学习方法|如何阅读一篇论文?
原文:S. Keshav,How to Read a Paper,ACM SIGCOMM Computer Communication Review,Volume 37, Number 3, July 2007,pp. 83-84
作者单位:David R. Cheriton School of Computer Science, University of Waterloo
作者邮箱:keshav@uwaterloo.ca
阅读提示: 这里临时产生了一些有趣的想法,和之前交大的PaMaster联袂出演了再一次hhhh。祝食用愉快~🪣
导言
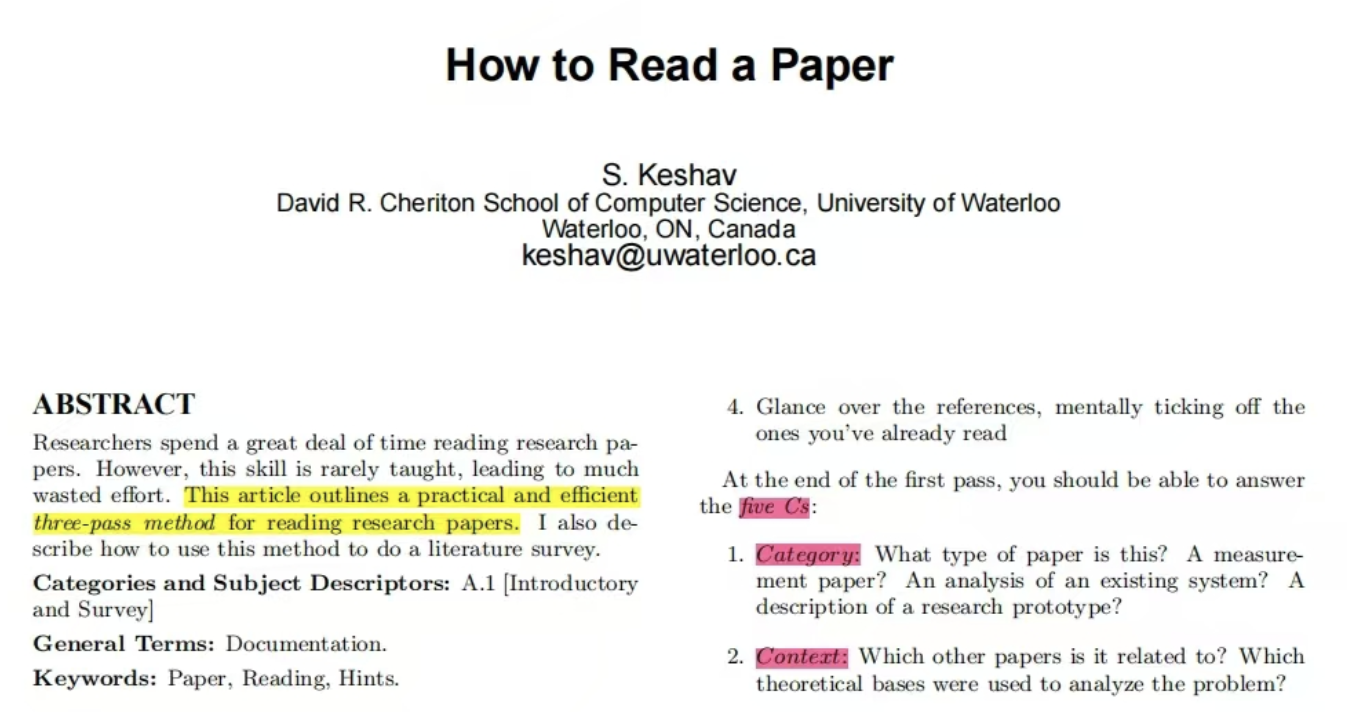
“ 这篇文章文概述了一种实用且高效的三遍阅读法(three-pass method)。 ”
图 1 论文原文
研究人员读论文出于几个原因:在会议或课堂上回顾论文、跟上自己领域的最新进展,或对一个新领域做文献综述。一个典型的研究人员每年可能要花数百小时读论文。
高效地读论文是一项关键但很少被传授的技能。因此,初学研究生必须靠试错自己学。这些学生在学习过程中浪费大量精力,而且常常被挫败感驱使走向歧途。
三遍阅读法(three-pass method) 是一种简单高效读论文的方法。
三遍阅读法(THE THREE-PASS APPROACH)
“ 研究人员应该最多读一篇论文三遍,而不是从头到尾一口气读完。每一遍都完成特定目标,并在前一遍的基础上逐步深入:第一遍是快速浏览,了解大致内容;第二遍抓住内容,但不看细节;第三遍才深入理解细节。 ”
第一遍(The first pass)
“ 这是一次快速浏览(quick scan),目的是获得论文的大致轮廓(bird’s-eye view)。你也可以借此判断是否需要再读更多遍。整个过程大约需要五到十分钟,包含以下步骤: ”
- 仔细阅读标题、摘要和引言(Carefully read the title, abstract, and introduction)
- 阅读各节与小节的标题,但忽略其他所有内容(Read the section and sub-section headings, but ignore everything else)
- 阅读结论(Read the conclusions)
- 快速浏览参考文献,在脑中勾出已经读过的文献(Glance over the references, mentally ticking off the ones you’ve already read)
“ 第一遍结束时,你应该能回答以下五个问题: ”
- 类别(Category):这是什么类型的论文?是测量类?对已有系统的分析?对研究原型的描述?
- 背景(Context):它与哪些论文相关?用什么理论基础来分析问题?
- 正确性(Correctness):假设看起来合理吗?
- 贡献(Contributions):论文的主要贡献是什么?
- 清晰度(Clarity):论文写得好吗?
“ 利用这些信息,你可以决定不再继续读。原因可能是:这篇论文对你没兴趣,或者你对该领域了解不够以至于无法理解,或者作者做了无效假设。第一遍对不属于你研究领域、但将来可能相关的论文也足够了。 ”
“ 顺便提一下,写论文时你可以预期大多数审稿人(和读者)只会做一遍。因此要精心选择连贯的章节标题,并写出简洁、全面的摘要。如果审稿人一遍后无法理解要点,该论文很可能被拒;如果读者在五分钟后还无法理解亮点,他们很可能永远不会再读了。(这也可以作为一个润色paper的指南) ”
第二遍(The second pass)
“ 第二遍要更仔细地读论文,但忽略细节如证明。这有助于抓住要点,或向同事做评论。读完后,你应该能总结论文的主要论点,并附上支持证据。这一遍通常需要约一个小时。 ”
“ 具体步骤: ”
- 仔细看图表、示意图和其他插图。特别注意图表。坐标轴是否标注?结果是否有误差条(error bars)使结论具有统计显著性?这类常见错误能把仓促、粗制滥造的工作与真正优秀的工作区分开来。
- 记得标记相关的未读参考文献以便进一步阅读(这是了解论文背景或了解作者后续工作的好方法)。
“ 第二遍应该做到:你能把论文的内容概括给别人听。对你感兴趣的论文,这一遍通常已足够;但对你研究领域内的论文,第二遍还不够,你可能需要第三遍。 ”
第三遍(The third pass)
“ 要完全理解一篇论文,需要第三遍。关键在于试图“虚拟重现(virtually re-implement)”这篇论文:也就是说,做出与作者相同的假设,重新创作这项工作。通过比较这种重现与实际论文,你不仅能轻松识别论文的创新之处,还能发现其隐藏的缺陷和假设。 ”
这遍要求对每个细节提出高度关注:你应该逐句逐行思考每个陈述的假设。更进一步,你应该思考:如果由你来呈现某个特定想法,你会如何做?这种实际与虚拟呈现的比较,能让你对论文的证明和呈现技巧有深刻洞察。读完这遍后,你应该能从记忆中重建整篇论文的结构,并能识别其强项与弱项。特别是,你应该能指出隐含的假设、缺失的相关工作引用,以及实验或分析技术中可能存在的问题。
“ 这遍大约需要初学者四到五小时,有经验的读者约一小时。读完后,你应该能从记忆重构整篇论文的结构,并识别其优缺点。在这个层次上,你还应该能精确指出论文的假设、缺失的引用,以及实验或分析技术中的潜在问题。 ”
做文献综述(DOING A LITERATURE SURVEY)
“ 论文阅读技能不仅在做研究时重要,在做文献综述(literature survey) 时也至关重要。文献综述要求你在一个不熟悉的领域读数十篇论文。那么,应该读哪些?以下是如何用三遍法高效完成的建议: ”
- 先用学术搜索引擎(如 Google Scholar 或 CiteSeer)和精选关键词找到该领域三到五篇近期论文。对每篇做一遍,了解工作内容,读它们的相关工作部分。你会找到近期工作的简要总结,如果运气好,还能找到指向近期综述的指针。如果找到综述,那就完成了,恭喜你!否则进入下一步。
- 在参考文献中找重复出现的作者名或引用。这些是该领域的关键论文和关键研究人员。下载这些关键论文放在一边。然后访问这些关键研究人员的网站,看看他们最近在哪里发表文章。这将帮助你识别该领域的顶级会议,因为最好的研究者通常在顶级会议发表。
- 第三步:访问这些顶级会议的网站,浏览它们最近的会议记录。快速扫描通常能识别出近期高质量的相关工作。这些论文,连同之前放在一边的那些,构成了你综述的第一版。对这些论文做两遍。如果都引用了你之前没找到的一篇关键论文,那就找来读一下,必要时反复迭代。
概述
“ 可以把这个过程概括为这几个词 ”
- 第一遍:筛选(Filter)——判断这篇论文值不值得深读(5-10 分钟)。
- 第二遍:理解(Understand)——抓住核心思想和证据,不纠结数学细节(约 1 小时)。
- 第三遍:内化(Internalize)——像审稿人一样重构论文,发现隐藏缺陷(1-5 小时)。
“ 这篇论文提出的深刻的思想让我有了一些想法:不止在如何去读取论文,还在于如何利用这个思想框架去设计一个层次递进的Agent或者skills去解决文献检索的深度匹配需求,以及如何润色一篇论文,如何高效将论文转化为一个合理的框架结构给他人展示清楚。 ”
关于 Idea
“ 有一篇是上海交大团队提出的 PaSaMaster(Towards Self-Evolving Agentic Literature Retrieval,arXiv:2605.14306),它试图把文献检索从一次性的 query-document matching,改造成一个根据检索证据不断修正意图、重新检索和排序的 agentic retrieval 系统。于是…… ”
在读完 Keshav 的三遍法和 PaSaMaster 的架构后,我产生了一个比较有趣的联想。如果把这两个思想结合起来,不只是做“更好的检索系统”,而是做一个可持续沉淀知识、并反过来指导写作和 Agent 行为的闭环系统,会怎样?
从“检索结果”到“背景知识库”
PaSaMaster 的 REFLECT 步骤强调:根据已排序证据发现缺失术语、覆盖空洞和未探索方向。这意味着每一轮检索不仅产出一份论文清单,还在“修正对问题本身的理解”。
但是呢,如果把这些修正记录下来——包括每轮发现的缺口、补充的同义词、排除条件的调整、领域核心作者和会议的识别——这些信息本质上构成了一个动态增长的背景知识库(Background Knowledge Base)。
背景知识库的构成要素
- Intent Spec 演化历史:每一轮用户意图的结构化表达(objective / domain / must_have / exclude / freshness / evidence_needs / acceptance_rule)。
- Checklist 模板库:不同领域任务的验证清单模式,例如“术语对齐任务”与“知识图谱综述任务”所需的 checkpoint 结构差异。
- Query Family 扩展图:精准检索、召回扩展、作者/数据集扩展、排除条件感知检索的互补策略。
- 验证与失败模式:哪些候选被拒绝、拒绝原因是什么(routing 错误 / retrieval 不足 / verification 失败 / ranking 偏差 / presentation 问题)。
- 领域核心节点图:重复出现的关键作者、顶级会议、基准数据集、方法学流派。
这个知识库的存储了“如何理解这个领域的问题”的元知识。它让 Agent 不再每次从零开始理解任务,而是可以基于历史检索证据快速构建 IntentSpec 和 Checklist。
“文章润色 Skill”
更有趣的一步是:如果把这个知识库反过来用于指导写作,而不只是检索,会怎样?
回到 Keshav 的反向启示:大多数审稿人只做一遍,所以文章的标题、摘要、章节结构和图表必须在第一遍内传达核心价值。如果 Agent 在做文献检索时积累了大量“哪些论文被拒绝、哪些假设被质疑、哪些证据不足”的模式,这些模式完全可以被抽象为文章润色(Polishing)与写作指导的行为规范。
把它的核心逻辑反向应用到写作任务中,就可以形成一个文章润色 Skill:
文章润色 Skill 的规则
- 第一遍可读性检查:标题是否连贯?摘要是否在 300 字内包含类别、背景、贡献、清晰度四要素?章节标题是否构成自洽的逻辑流?
- 图表证据检查:图表坐标轴是否完整?是否有误差条或统计显著性标注?插图是否能独立传达核心信息?
- 假设与缺失引用检查:文章是否明确列出隐含假设?相关工作部分是否覆盖了领域核心节点(重复出现的关键作者、基准、方法流派)?
- 虚拟重现提示:如果读者试图重现你的工作,是否缺少关键参数、数据集描述或代码位置?
- 排除条件与偏好对齐:文章是否清晰说明了“不适用”的场景?这与检索中的
exclude条件直接对应。
这样一来,Agent 在做文献检索时积累的知识,可以帮助“理解这个领域的写作规范”。当用户要求“润色一篇论文”时,Agent 可以直接调用这个知识库中的领域模板,而不需要每次重新学习领域惯例。
小结:检索 → 知识库 → 写作指导 → 更好的检索?
如果把这三个环节串起来,就形成了一个有趣的闭环:
检索证据修正意图 → 背景知识库沉淀领域元知识
↓
知识库指导文章润色 Skill → 写出更清晰、更可验证的论文
↓
更清晰的论文被更高效地检索和验证 → 检索证据更准确 → 知识库更精确
这是一种领域性质更强的学习模式:Agent 成为了逐步构建并维护一个领域特定“理解框架”的伙伴。
笔者的话
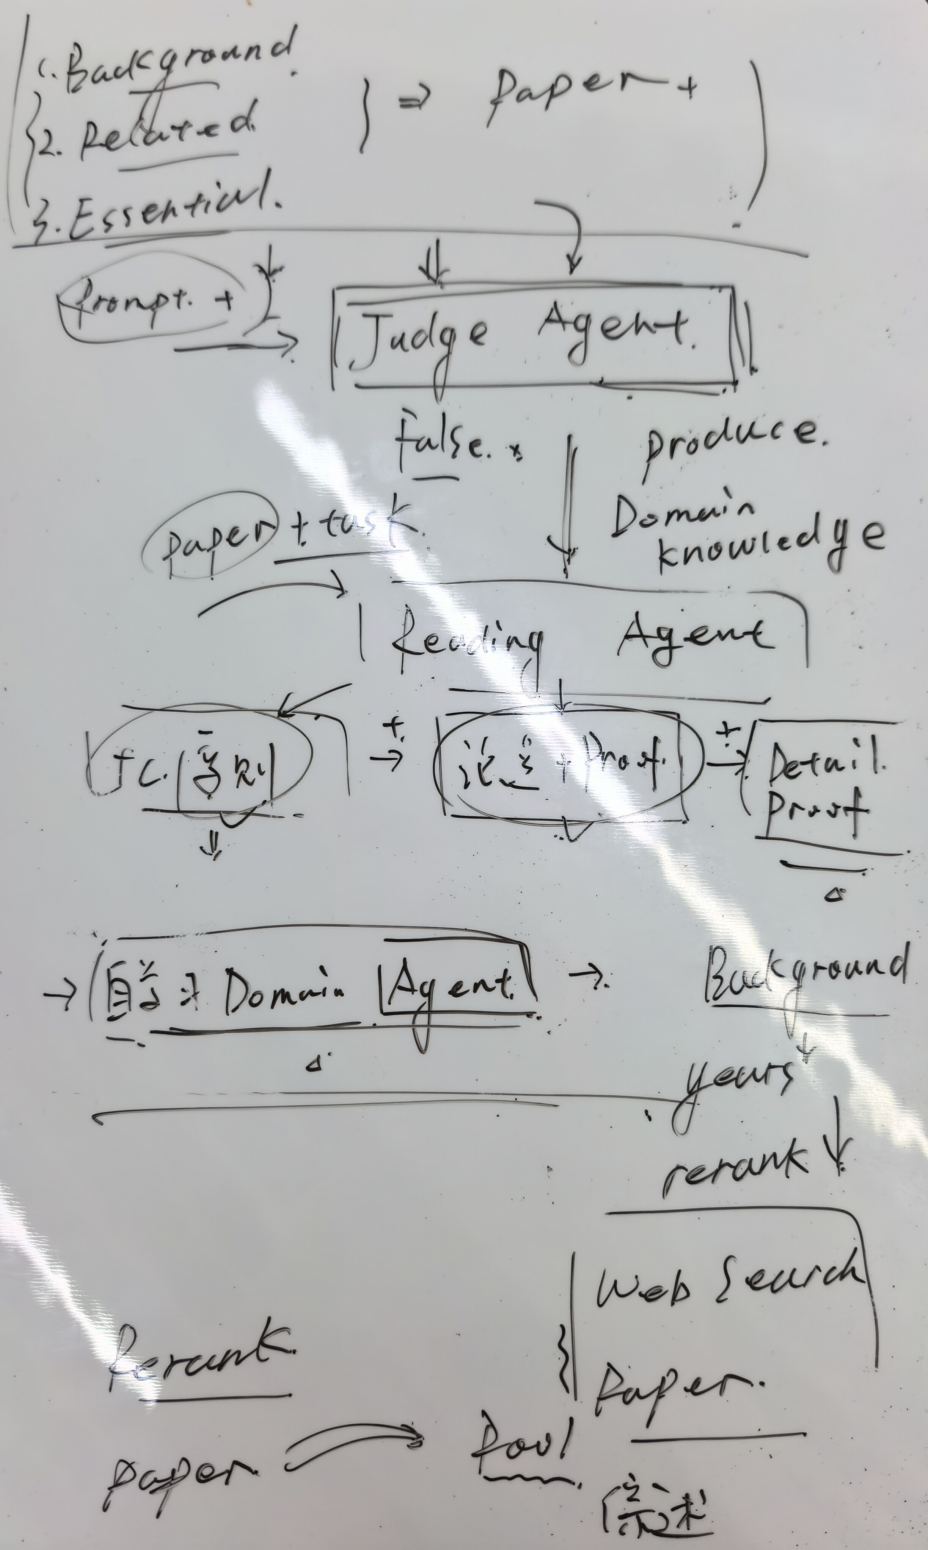
“ 这个读取论文的方法需要习惯习惯就可以上手作为一个好的方法了,但是也可以把这个教授的思想蒸馏掉,做成其他Agent以及Skill的样板hhhhh。这里展示一下笔者在思考这个框架的时候的手稿,有点抽象说实话,之后有时间可以仔细看看。🧐 ”
图 2 手稿1
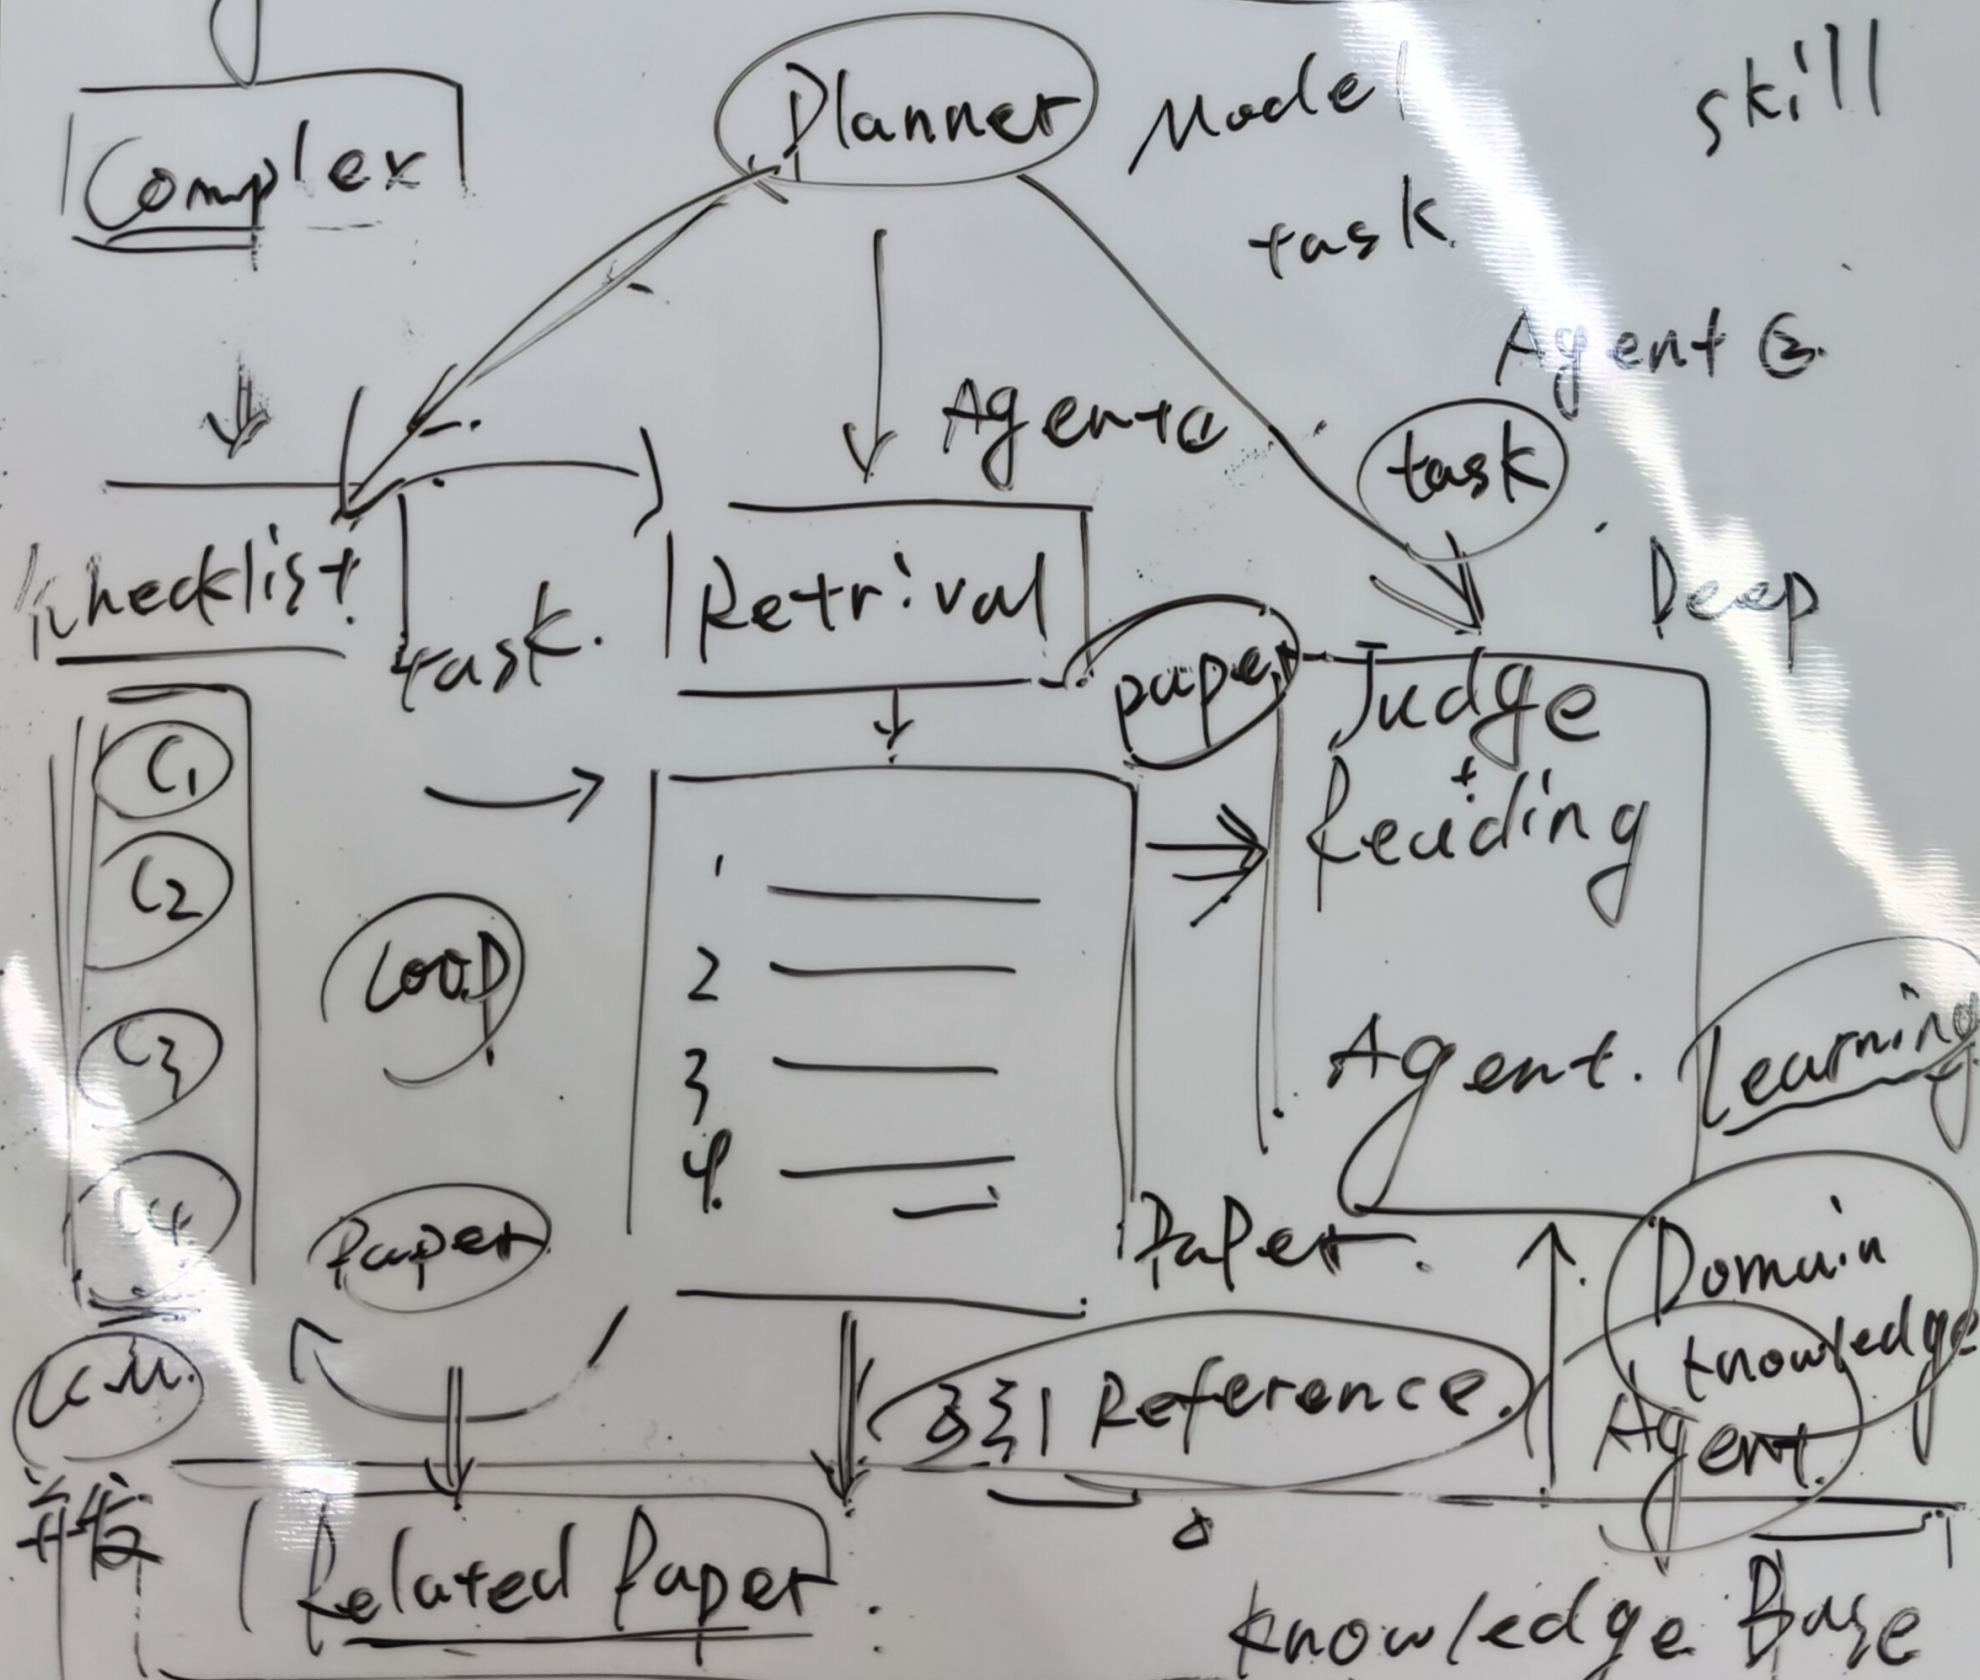
图 3 手稿2