论文解读|MRGen:基于扩散模型与 U-Net 的跨模态医学图像生成
“ MRGen: Diffusion-based Controllable Data Engine for MRI Segmentation towards Unannotated Modalities(ICCV 2025 交大) ”
阅读提示: 这篇是交大张娅教授发的一篇MRGen的个人解析,笔者花了大半天的时间读了原文➕附录,是一篇很不错的文章,发在ICCV上,这里会展示一下对这篇文章的内容的讨论。建议阅读需要一定对UNet、卷积网络、Transformer、扩散模型的了解,可以阅读笔者之前发的关于UNet和卷积网络介绍那篇来作为前置内容。祝食用愉快~🌲
图 1 论文
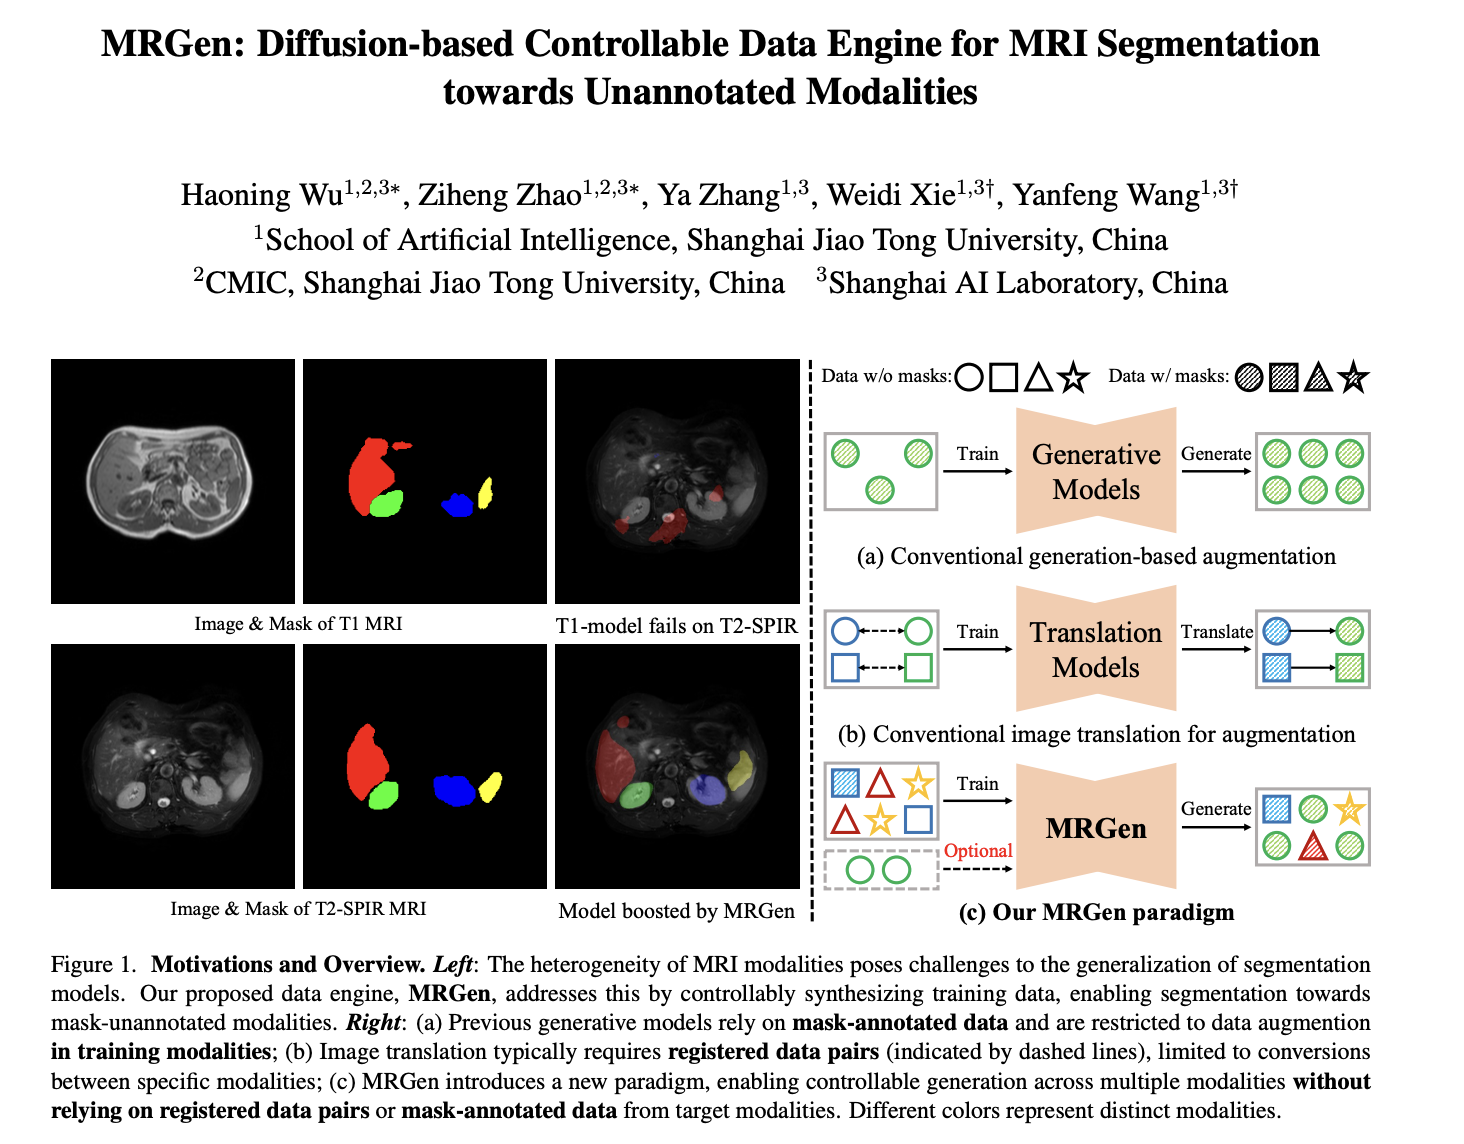
1. 导言
1.1 MRI 分割的困难
MRI 的像素强度不像自然图像那样具有稳定含义。T1、T2、T2-SPIR、ADC 等序列之间,同一组织可能呈现完全不同的信号;同一序列还会受扫描仪厂商、场强、线圈、TR/TE、抑脂方式、重建协议和患者运动影响。
因此,在源域训练的分割模型可能学到大量“外观捷径”:
- 某器官在 T1 中的灰度范围;
- 某一医院扫描协议的对比度;
- 特定重建噪声或背景分布。
当输入切换到 T2-SPIR 或 ADC 时,器官几何仍在,但像素统计发生剧变,模型可能直接失效。论文表 3 中,源域训练的 nnUNet 在目标模态上的平均 DSC 仅 8.99,UMamba 仅 6.85,正说明这种域偏移非常严重。
1.2 传统解决路线及其瓶颈
路线 A:目标模态人工标注
最可靠,但代价最高。医学 mask 通常需要专业人员逐层勾画,且不同模态、机构、协议都可能要重新标注。
路线 B:强数据增强 / 域泛化
例如论文比较的 DualNorm。它试图把源图像做很激进的强度与风格扰动,使分割器不依赖固定外观。
问题是:人工增强只能覆盖预先设定的变化,未必能逼近真实 T2-SPIR、ADC 或 CT→MRI 的复杂分布。
路线 C:图像翻译
例如 CycleGAN,把源域图像翻译为目标域风格,再沿用源 mask。
问题包括:
- 一对一翻译通常绑定特定源—目标域;
- 训练容易不稳定或模式崩溃;
- 翻译可能改变器官边界,使旧 mask 与新图不再严格对齐;
- 可扩展到大量 MRI 模态时,需要维护很多转换模型。
路线 D:生成式数据增强
以 mask 为条件直接生成图像。传统方法通常只在有 mask 的模态内训练,所以只能做“已标注模态的扩增”,不能自然地把控制能力迁移到无 mask 目标模态。
1.3 MRGen 的核心问题设定
论文希望学习:
其中:
- :模态、信号属性、身体区域、器官名称组成的文本条件;
- :器官分割 mask;
- :生成的 CT/MR 图像;
- :基础文本生成模型参数;
- :mask 控制分支参数。
其中 应符合目标模态, 则直接作为训练标签。
2. 数据基础
2.1 三类数据的角色
论文把数据抽象为:
1. 大规模图像—文本数据
作用:学习多模态 CT/MRI 的外观分布及文本控制能力。
2. 有 mask 的源域数据
作用:学习图像与器官 mask 的空间对应关系。
3. 无 mask 的目标域数据
作用:在 mask 控制微调阶段继续暴露目标域外观,减少控制分支过拟合源模态。
这里最重要的概念是:目标域没有分割标注,但目标域图像并非不存在。
2.2 数据规模与自动文本标注
论文汇集 Radiopaedia 及多个公开分割数据集,声称 MedGen-1M 约包含:
- 约 1.2M 张 2D CT/MR 切片;
- 数百种自由文本 MRI 模态标签;
- 部分样本带器官 mask;
- 模态、信号属性、身体区域与器官信息。
自动注释包含两步:
- 身体区域分类:用 BiomedCLIP 将切片分为上/中/下胸部、上/下腹部和盆腔六类;
- 模态解释:用 GPT-4 把 T1、T2 等标签映射为“fat high signal / water low signal”等模板属性。
模板例子为:
“ T1 MRI;脂肪高信号、肌肉中等信号、水低信号;上腹部;肝、脾、肾。 ”
这样做的目的,是避免文本编码器只看到“T1”或“T2”这种过短标签而难以学习细粒度差异。
2.3 数据层面的局限
(1)自动文本非扫描物理参数
“T1、脂肪亮、水暗”是粗粒度经验描述,不能完整表达:
- TR、TE、TI;
- 场强和厂商;
- 线圈与重建算法;
- 对比剂与时相;
- 抑脂方式;
- 病理、伪影和运动。
(2)2D 切片被作为基本样本
模型主要学习单切片分布,而不是完整 3D 体数据分布。切片独立生成会天然缺乏跨层连续性。
(3)源 mask 决定了合成数据的形态分布
即使外观被改成目标模态,mask 的器官大小、形态、病理和人群特征仍来自源域。MRGen 主要解决“外观域偏移”,不必然解决“几何/人群域偏移”。
3. 架构解析
图 2 个人理解制作的总pipeline(非论文原图)
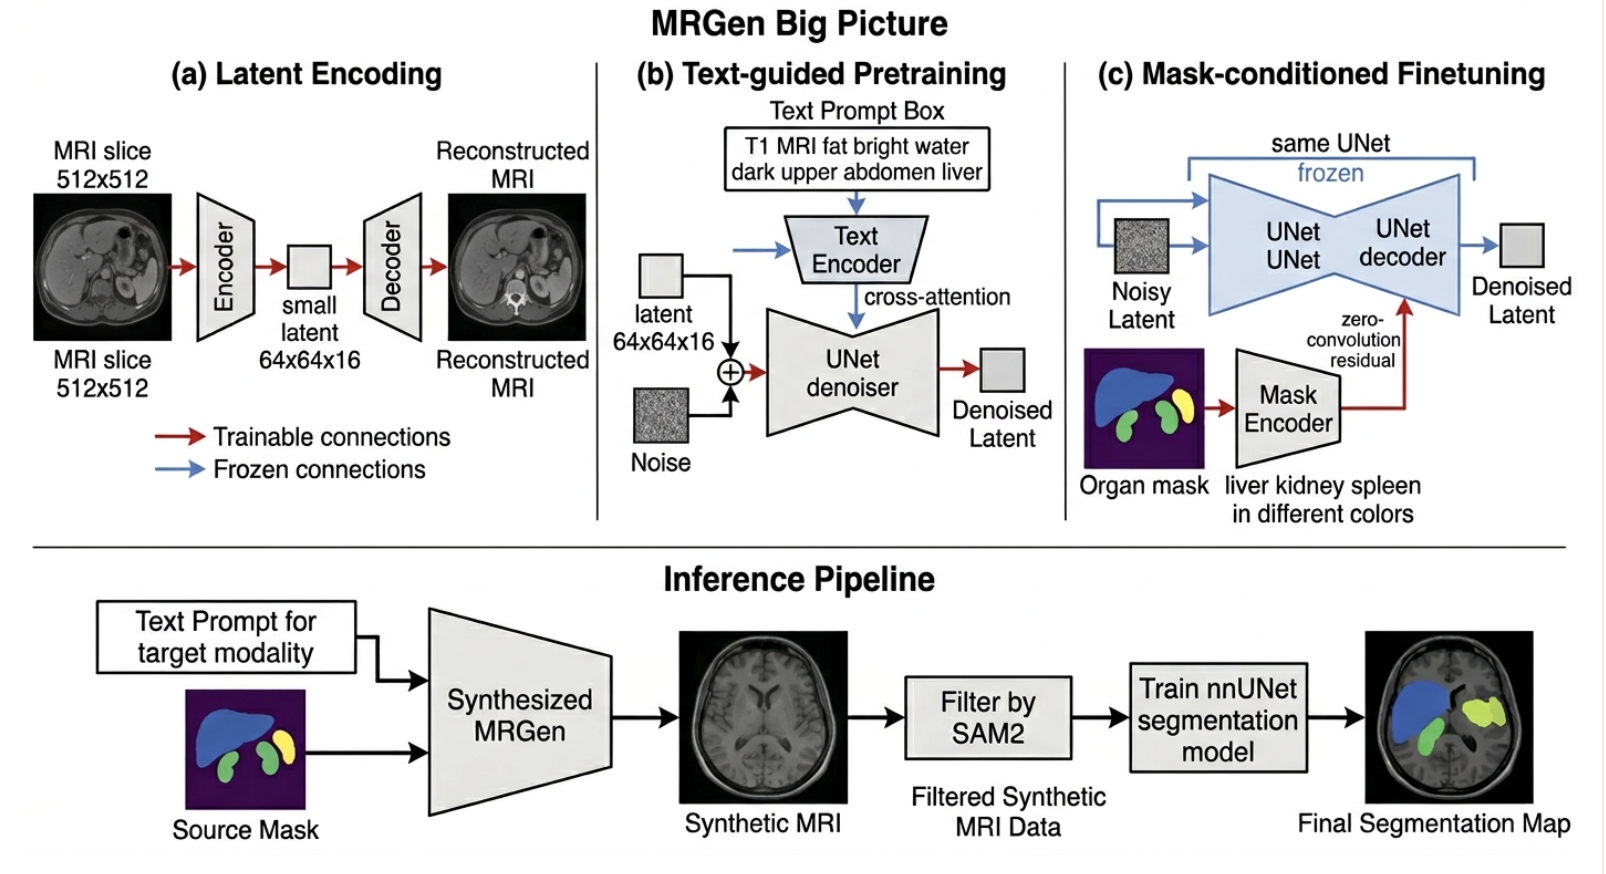
论文的 MRGen 由三部分组成:
- 医学图像 VAE;
- 文本条件 latent diffusion UNet;
- 类 ControlNet 的 mask 控制器。
其训练与部署流程可概括为:
大量 CT/MRI 图像 ──> 医学 VAE:学习高保真 latent
图像 + 文本       ──> 文本扩散模型:学习模态/区域/器官外观
图像 + 文本 + mask ─> mask 控制器:学习空间结构服从性

推理:目标模态文本 + 源域 mask
                ↓
        生成目标模态图像
                ↓
        SAM2 检验图像-mask 一致性
                ↓
      合成图像 + 原 mask 训练分割器
图 3 模型部分pipeline(论文摘录)
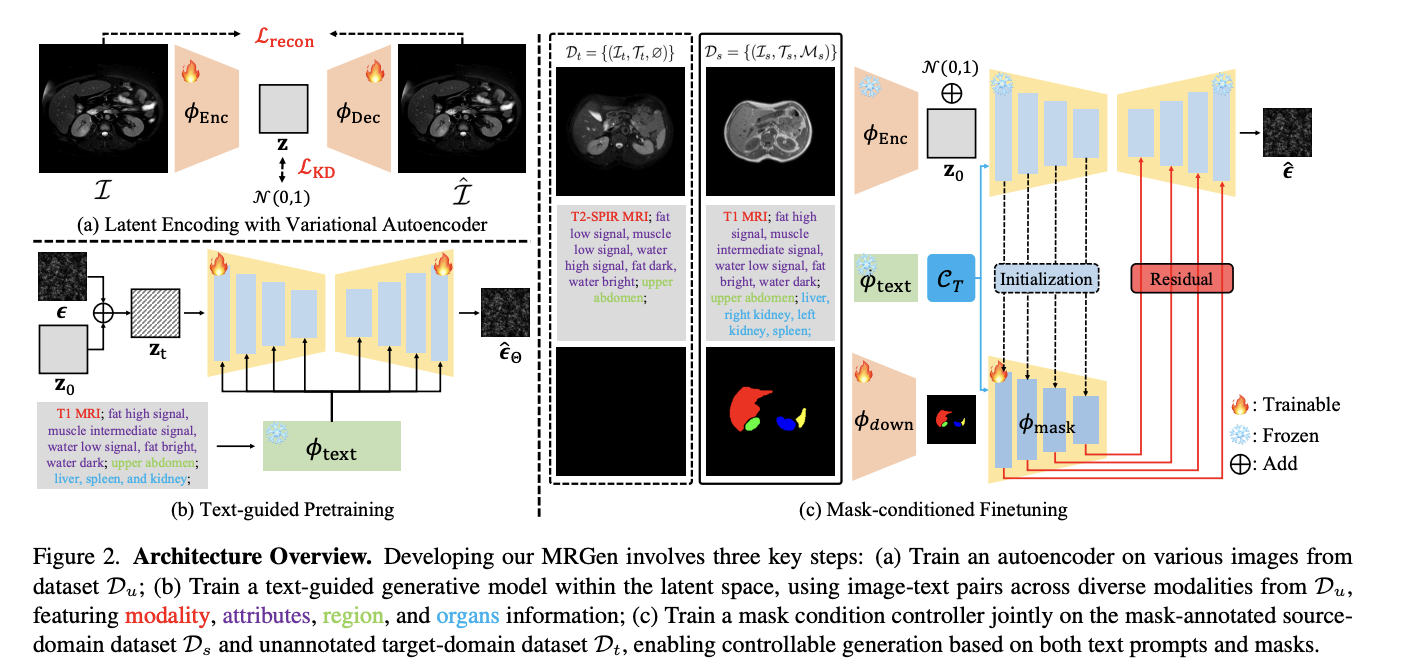
3.1 第一部分:医学图像 VAE
输入为 512×512 的单通道切片 ,编码为低维 latent:
训练损失:
论文设置:
- 空间下采样倍数:8;
- latent 通道数:16;
- ;
- VAE 训练 50K iterations。
若输入为 512×512,则 diffusion 大致在 64×64×16 的 latent 上工作。这样显著降低计算量,但也埋下了小器官问题:一个在原图中只有几像素宽的结构,到 1/8 尺度可能缩成一个像素甚至消失。
3.2 第二部分:文本引导 latent diffusion
前向扩散为:
UNet 学习预测噪声:
文本通过 BiomedCLIP 编码:
然后以 cross-attention 的 key/value 进入 UNet,视觉 latent 作为 query。
该阶段在 上训练,其作用不是学 mask,而是先学会:
- CT 与 MRI 的总体分布;
- 不同 MRI 模态的信号模式;
- 身体区域;
- 文本中所列器官与图像内容的相关性。
论文使用 10% 文本条件丢弃实现 classifier-free guidance,推理 guidance scale 为 7.0。
3.3 第三部分:mask 条件控制器
论文采用类似 ControlNet 的做法:
- 复制/初始化一个与 diffusion UNet encoder 相近的 mask encoder;
- 用 把 mask 下采样到 latent 尺度;
- 将控制分支输出通过 zero-convolution 以 residual 形式注入冻结 UNet 的 decoder 多层。
简化表达为:
其中基础 VAE、文本编码器和文本扩散 UNet被冻结,主要训练 mask controller。
训练数据同时包括:
- :有 mask 源域;
- :无 mask 目标域。
控制阶段损失仍为噪声预测 MSE:
作者的意图是:
- 教控制器“mask 如何影响图像”;
- 让控制器在目标模态上不要失真或只记住源域外观。
3.4 推理与自动筛选
对每个源 mask,输入:
- 目标模态文本 ;
- 源域器官 mask 。
MRGen 生成 20 个候选,再通过 SAM2 筛选,选出最好的 2 个。
SAM2 对每个器官输出:
- 置信度 ;
- 伪 mask,与条件 mask 计算 。
附录给出的阈值为:
- 每器官 IoU ≥ 0.70;
- 每器官 confidence ≥ 0.80;
- 平均 IoU ≥ 0.80;
- 平均 confidence ≥ 0.90。
这一步非常关键。它说明 MRGen 本身不能保证每次生成都服从 mask,SAM2 实际上充当了一个外部结构一致性判别器。
4. 实验结果
图 4 生成质量结果对比
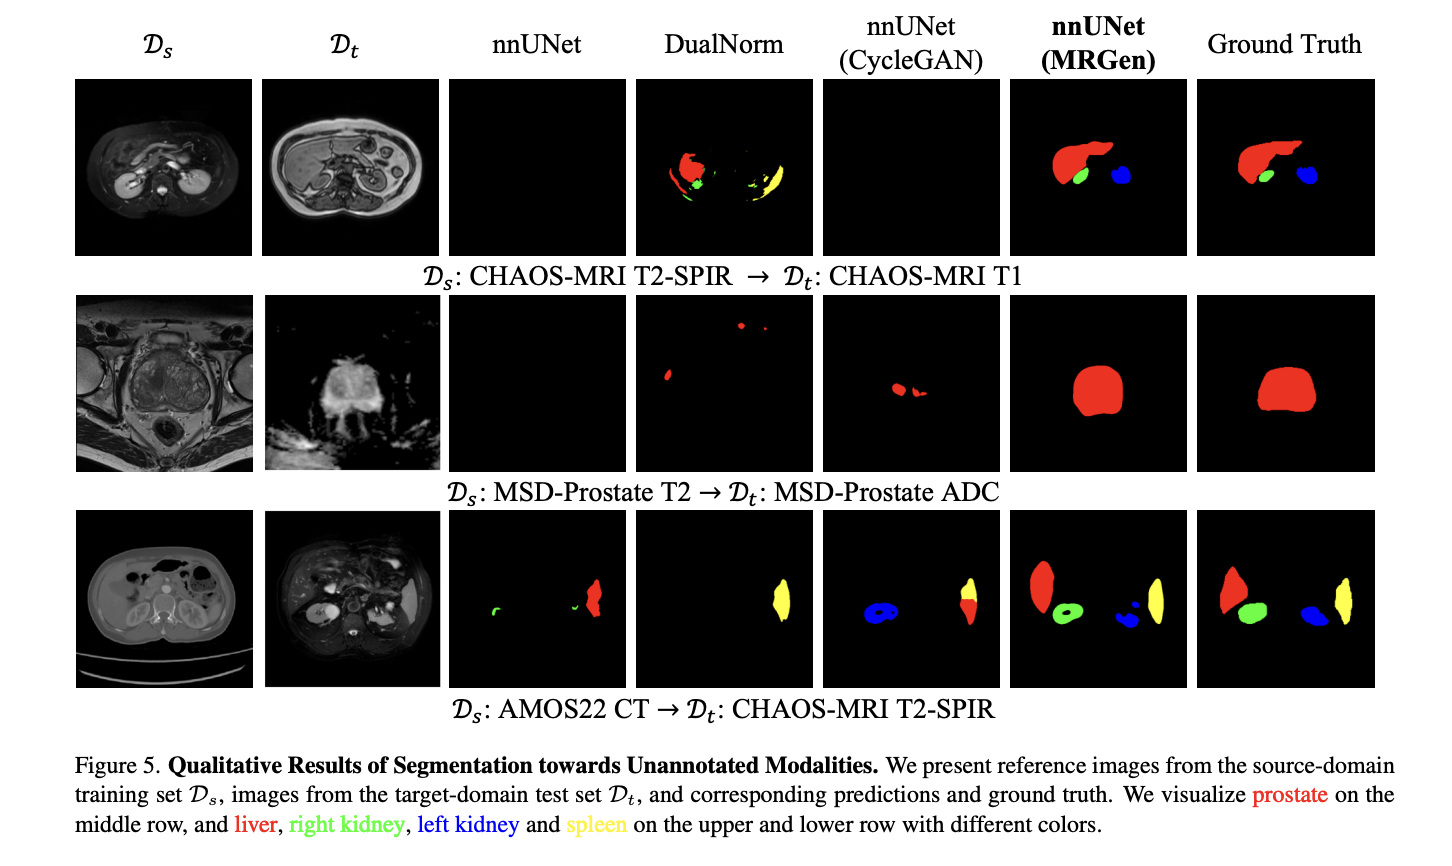
4.1 图像生成结果
表 2 的平均 FID:
| 方法 | 平均 FID ↓ |
|---|---|
| 源域图像直接对目标域 | 197.06 |
| DualNorm | 281.20 |
| CycleGAN | 200.47 |
| MRGen | 78.95 |
MRGen 相比 CycleGAN 的 FID 下降约 60.6%,说明合成分布更接近目标域。
- FID 的 Inception 特征来自自然图像,并非医学专用;
- FID 反映分布接近程度,不保证 mask 与图像边界对齐;
- 较低 FID 不代表没有病理幻觉或临床不合理结构。
4.2 下游分割结果
表 3 的平均 DSC:
| 训练来源 / 模型 | 平均 DSC ↑ |
|---|---|
| DualNorm | 10.79 |
| nnUNet:真实源域 | 8.99 |
| nnUNet:CycleGAN | 25.63 |
| nnUNet:MRGen | 43.43 |
| UMamba:真实源域 | 6.85 |
| UMamba:CycleGAN | 25.89 |
| UMamba:MRGen | 43.52 |
| SAM2(带扰动 oracle box) | 57.92 |
| nnUNet:真实目标域标注 | 83.72 |
4.3 目标域无标注图像和自动筛选
表 4 是理解系统真实工作机制的关键。
以 CHAOS T1→T2-SPIR 为例:
| 自动筛选 | 使用目标域无 mask 图像 | DSC |
|---|---|---|
| 否 | 否 | 16.53 |
| 是 | 否 | 22.30 |
| 否 | 是 | 30.16 |
| 是 | 是 | 66.18 |
T2-SPIR→T1 也从 15.10 提升到 58.10。
这说明:
- 仅靠两阶段预训练能产生一定迁移能力;
- 目标域图像适配很重要;
- SAM2 过滤很重要;
- 两者具有明显协同效应。
论文称“不使用目标域图像时仍有提升”,但并非所有方向都严格成立。例如 MSD-Prostate ADC→T2 在既无筛选又无目标图像时为 18.92,低于源域基线 22.20;加入筛选后才升到 25.34。
4.4 域内生成比跨域生成容易得多
附录表 6:
- CHAOS T1 域内:真实数据训练 90.60,MRGen 合成数据训练 88.14;
- CHAOS T2-SPIR 域内:83.90 对 82.06。
这说明在见过“该模态 + 该 mask 对应关系”时,生成数据质量很好。
但跨域时:
- T1 mask 控制生成 T2-SPIR:67.35,真实 T2 标注训练为 83.90;
- T2-SPIR mask 控制生成 T1:57.24,真实 T1 标注训练为 90.60。
真正困难的并不是“会不会生成医学图”,而是“能否把控制关系跨模态稳定迁移”。
4.5 文本消融的含义
表 8:
| 模型 | FID ↓ | CLIP-I ↑ | CLIP-T ↑ |
|---|---|---|---|
| Stable Diffusion | 249.24 | 0.3151 | 0.1748 |
| 医学数据微调 SD | 91.48 | 0.6698 | 0.3199 |
| MRGen,仅模态名 | 41.82 | 0.7512 | 0.3765 |
| MRGen,完整模板 | 39.63 | 0.8457 | 0.3777 |
完整模板使 CLIP-I 明显提高,但 CLIP-T 只从 0.3765 到 0.3777。可能说明区域与器官模板主要帮助结构/内容匹配,对文本可辨识的模态语义提升有限。
此外,BiomedCLIP 同时参与区域标注、文本编码和 CLIP 评测,会产生一定“同模型闭环偏好”:系统可能更容易得到 BiomedCLIP 自己认可的图像。
4.6 基线和评测设计的不足
- CycleGAN 是较老且易崩溃的基线,缺少更现代的扩散翻译、无监督域适应、自训练和多域分割方法;
- FID 不够医学特异(属于一个普遍性的指标);
- SAM2 既参与筛选,又被作为参考分割器,似乎存在工具偏置;
- 平均 DSC 跨器官、跨数据集直接求平均,可能掩盖小器官或困难方向的问题;
- Radiopaedia 的训练/测试是否按患者或 3D volume 严格划分没有在正文中清楚说明;若按切片随机划分,相邻切片可能泄漏;
- 没有医学专家对解剖真实性、病理保持性和伪影进行评评价(缺少expert意见);
5. 论文明确承认的局限性
5.1 极小器官 mask 控制失败
论文解释了三个原因:
- 同一器官在 3D 不同切片上的面积变化很大;
- 极小 mask 在训练数据中稀少,类别与尺度分布不平衡;
- mask 下采样到 latent 尺度后,细节进一步丢失。
作者给出的主要方案是增加带 mask 数据,但这只解决数据稀缺,不足以解决架构中的分辨率瓶颈。
5.2 假阴性样本
“ 输入 mask 只标肝脾时,生成图像可能额外生成肾脏。训练分割器时,肾脏真实存在于图像,却被标签当作背景,于是形成假阴性监督。 ”
作者建议更强过滤或人工筛选,但根因其实是:
- mask 只表达“哪些像素属于已标注器官”;
- 没有表达“某器官明确不得出现”;
- 没有区分 absent 与 unknown;
- 基础生成先验会根据上腹部共现关系自动补全器官。
这首先是条件语义与标签定义问题,其次才是过滤问题。
6.“解耦”
“ 笔者认为这篇文章最重要的思想就是解耦了模态和结构,让本身相互以标注为场景依赖的2种特性在这里的模型构造中发生解耦,这才是这篇论文搭建模型最重要的一个思路。 ”
6.1 数据监督解耦
传统 mask 条件生成要求三元组:
MRGen 把它拆成:
- 目标外观:;
- 几何监督:。
这是一种“缺失监督重组”。它不要求目标域出现完整三元组,而是假设:
“ 从源域学到的 mask—解剖关系,可以与目标域学到的模态外观进行组合。 ”
这是论文最核心的创新。
6.2 条件语义解耦
模型试图让:
- 文本 控制模态、信号、区域和器官语义;
- mask 控制器官形状与位置。
理想生成函数应近似:
这样就能固定 mask、切换 T1/T2/ADC,或者固定模态文本、切换不同患者 mask。
6.3 参数模块解耦
- 基础生成器负责多模态图像先验;
- mask controller 负责附加空间控制;
- zero-conv 让控制残差从零开始,避免一开始破坏基础模型;
- 冻结基础生成器减少灾难性遗忘。
这是典型的“foundation model + adapter/controller”范式。
6.4 优化阶段解耦
训练被分成:
- VAE 重建;
- 文本生成预训练;
- mask 控制微调。
这样解决了三元组数据不足的问题:不要求所有样本同时有文本和 mask。
6.5 推理解耦
推理时,文本和 mask 可以交叉组合:
这比固定域对的 CycleGAN 更灵活。理论上一套模型可以支持很多目标模态。
6.6 生成与下游任务解耦
MRGen 不绑定具体分割网络。论文分别用 nnUNet 和 UMamba,平均 DSC 几乎相同:43.43 与 43.52。这说明合成数据可作为通用训练资源,而不是依赖某个特定下游模型。
7. 生成 UNet 改为 Transformer?
“ 这里的“改成 Transformer”不能只理解为把卷积块替换成 self-attention。更合理的方向是构造分层、多尺度、条件因子化的 Diffusion Transformer。 ”
7.1 UNet → DiT / U-ViT
原 UNet 主要通过卷积和下采样扩大感受野。Transformer 中任意图像 token 可以与远距离 token 交互,更适合学习:
- 左右肾的相对位置;
- 肝、脾、胃与体腔边界关系;
- 器官是否应在该切片出现;
- 整体身体区域与局部 mask 是否矛盾。
这可能减少“局部看起来合理、整体解剖不合理”的样本。
7.2 条件因子化
可以设计:
- timestep:通过 AdaLN/FiLM 调制;
- modality/scanner:全局 style token,通过 AdaLN 或低频通道注入;
- organ set:器官 query;
- spatial mask:高分辨率空间 token,通过 cross-attention 注入;
- absent/unknown:显式状态 token。
这样比原模型“文本和 mask 一起进入控制器”更容易建立条件职责边界。
一种结构可写为:
其中 与 是可学习门控,推理时还可以分别设置 style guidance 和 mask guidance。
7.3 多尺度/高分辨率 Transformer
普通 ViT/DiT 若 patch 太大,可能比卷积 UNet 更不利于小器官。正确做法包括:
- latent 下采样从 8 改为 4,或保留双尺度 latent;
- mask 分支保留 1/2、1/4、1/8 多层特征;
- 小器官 ROI 使用更小 patch;
- deformable attention 只在边界和小器官附近采样;
- 全局 Transformer 与局部 CNN/窗口 attention 混合。
所以,小器官问题不是“用了 Transformer 就会好”,而是:
“ 高分辨率信息保留 + 多尺度 token 化 + 局部注意力 + 专门损失共同解决。 ”
7.4 可变器官集合
把每个器官表示为 query:
[liver: present]
[left kidney: absent]
[right kidney: unknown]
[spleen: present]
每个 query 同时带:
- 器官类别 embedding;
- present / absent / unknown 状态;
- 可选 mask token;
- 置信度与面积信息。
这样模型能明确区分:
- “没有标这个器官,但它可以存在”(unknown);
- “这个器官在本切片不应出现”(absent);
- “这个器官必须按给定 mask 出现”(present)。
这是修复假阴性问题最有针对性的 Transformer 设计。
小结
该篇论文把监督关系重新组织为:
“ 目标域外观监督 +源域 mask 监督=目标域合成监督对 ”
这是一个很有扩展潜力的数据引擎范式。
回顾
- 对于这里的 mask 训练,为什么需要下采样后进入阶段三的微调?请结合 U-Net 的原理试着解释。
- 为什么阶段二和阶段三需要解耦,而不是一起训练 text 和 mask?主要考量是什么?
笔者的话
“ 这篇论文是一个很好的对稀疏图像合成场景的实践,它提供了一个更加广域的模型设计思想,使他可以具有较大的参考价值。也给了笔者一个机会去了解了图像处理UNet,扩散以及卷积技术在医疗实践中的应用,也是收获满满呢~😄 ”