图像处理|卷积与 U-Net 学习笔记
阅读提示: 这篇是个人在学习扩散模型以及尝试理解交大张娅教授发的一篇MRGen的学习过程中完成的,也是回归blog的第一作,尝试设计了一些回顾用的问题,用来加深自己的理解,可以不用有许多基础即可读懂,而且笔者这次加入了很多导图助于理解,后续对这篇论文我会去深度学习,在这个过程中会有一些补充的学习内容。祝食用愉快~❤️
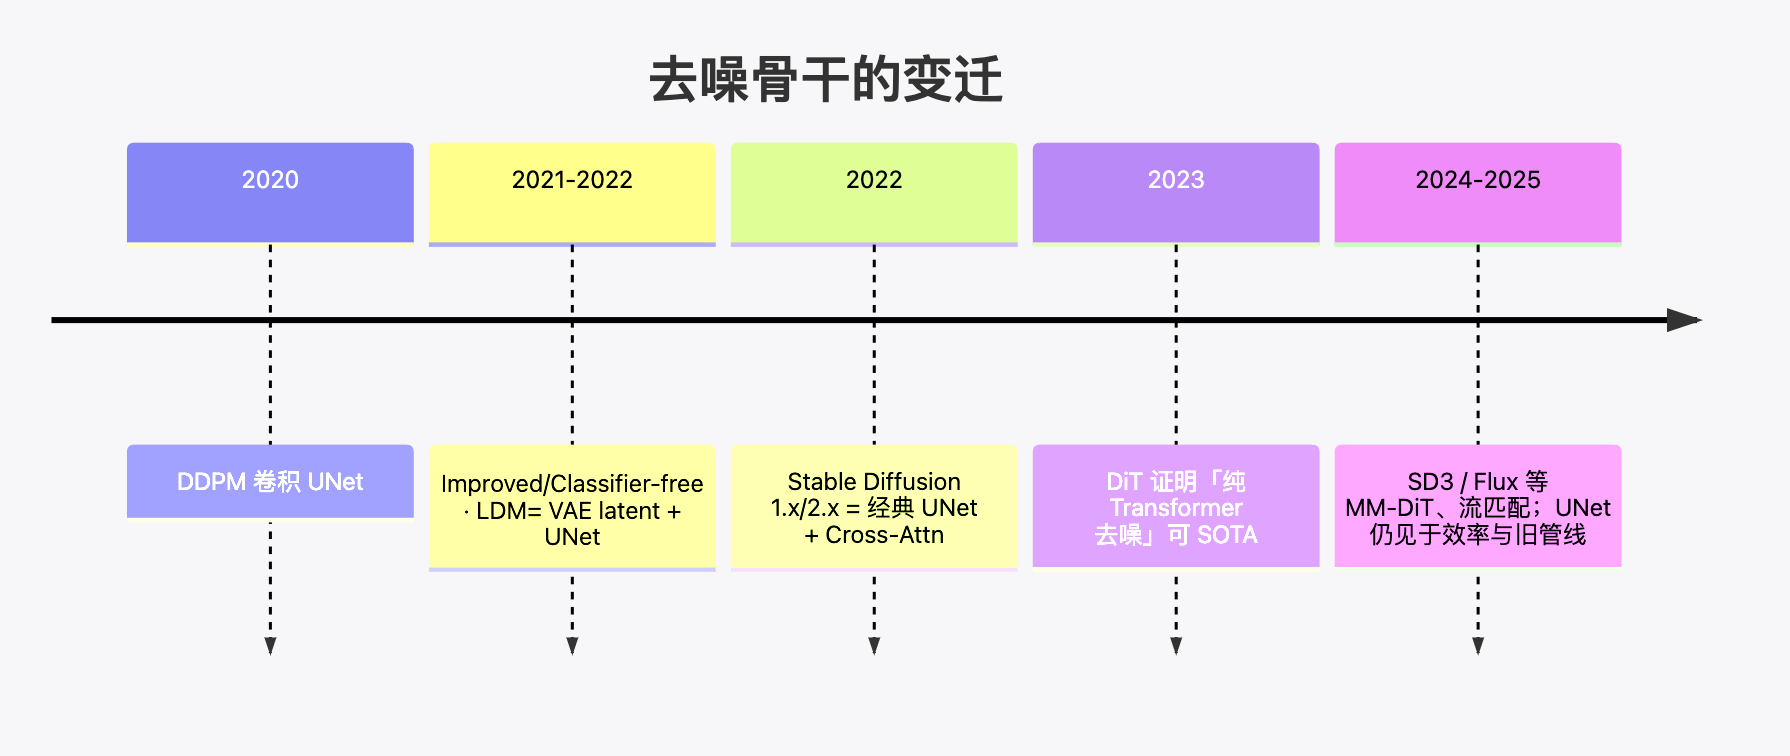
图 1 发展流程
导言
在大模型叙事里,落到图像生成,尤其是经典 Stable Diffusion 管线,马上就会撞上另一个名字:UNet。再往下挖一层,UNet 的基本积木又是 卷积(Convolution)。
问题在于:很多人「见过」卷积和 UNet,却很难说清:
- 卷积和全连接、和 Self-Attention 的本质差别是什么?
- 为什么图像天然适合卷积,而语言天然适合 Transformer?
- UNet 的 U 形到底在解决什么矛盾?
- 层数、分辨率、感受野、通道数,各自管什么、如何互相影响?
- Skip connection 和 ResNet 残差是不是一回事?
- 扩散模型里的 UNet,和 2015 医学分割 UNet,还是不是同一种东西?
这里指出,UNet 不是一种生成范式。像扩散可以用 UNet 去噪,也可以用 DiT(Transformer)去噪;而语言几乎不用 UNet。
卷积?
全连接
设输入有 个位置(一维信号长度,或图像拉平后的 )。若每个输出位置 都用自己的权重看全部输入:
参数大约 。对 图像,,全连接一层就极不现实。更糟的是:没有平移结构——左边的「竖边」和右边的「竖边」要各学一套权重。
图像的两个先验
| 先验 | 含义 | 对运算的要求 |
|---|---|---|
| 局部性 | 一点的性质多半由附近像素决定(边缘、纹理) | 不必每次看全图 |
| 平稳性 / 平移可复用 | 同一模式在图上各处结构相同 | 同一套检测器应到处用 |
卷积是:
“ 用少量可学习的局部模板,在所有空间位置上做相同的滑动点积。 ”
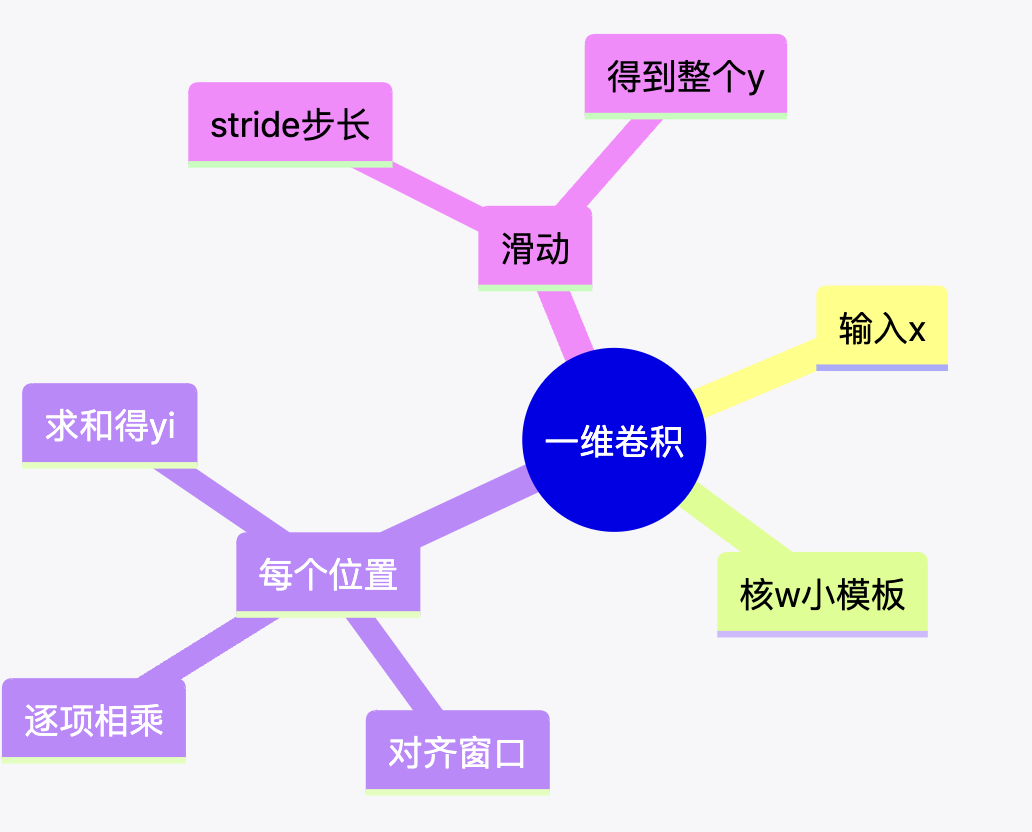
一维卷积
“ 先忘掉二维图像,从一维信号开始吧~ ”
图 2 一维卷积
实际定义
输入 ,核 , 通常很小(3、5、7)。在位置 :
也就是局部点积:
例子
取 ,,无 padding、stride :
| 窗口 | 计算 | ||
|---|---|---|---|
| 0 | |||
| 1 | |||
| 2 |
核 近似在做左边减右边,对变化 / 边缘敏感。若换成
则变成局部平均(平滑)。同一套滑动点积机制,换核 = 换提取的模式。 训练时学的就是这些核里的数字。
Padding、Stride 与输出尺寸
输入长 ,核长 ,两端各 pad ,stride 为 :
无 padding、 时退化为 。
图 3 概念
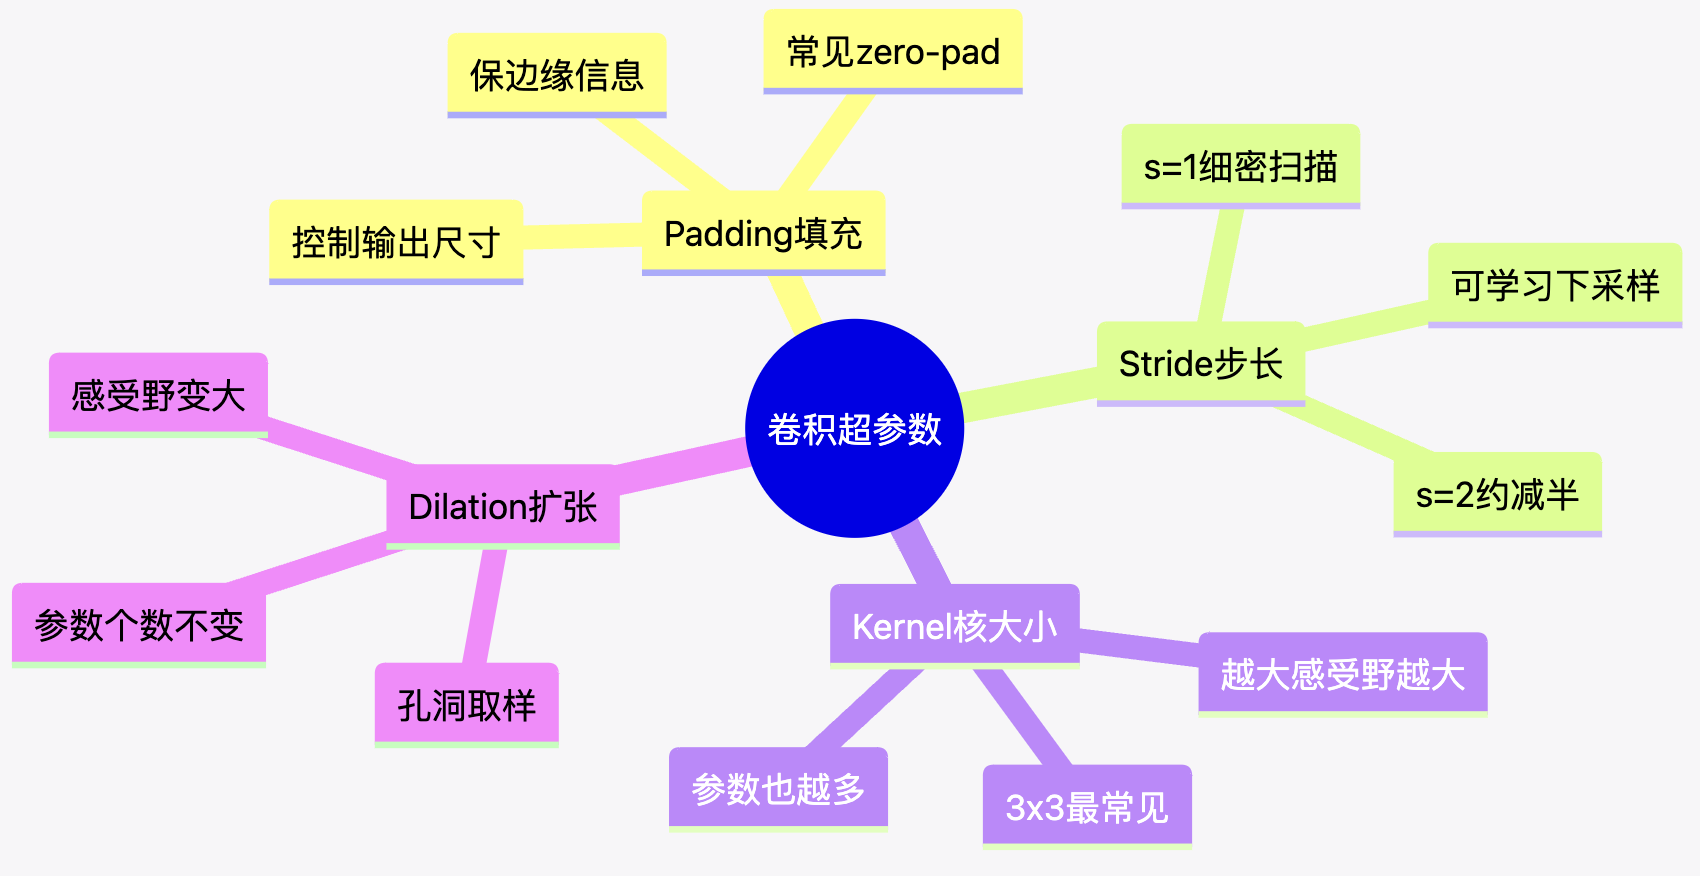
| 超参 | 作用 |
|---|---|
| Padding | 边上补值(常补 0);让边缘也能当窗口中心;控制输出是否「同尺寸」 |
| Stride | 窗口每次跳几步; 时分辨率大约减半,是下采样的重要方式 |
| Kernel size | 单层直接感受野大小;越大参数与计算越多 |
| Dilation | 取样隔空,参数个数不变但感受野变大 |
且 (如 )时,常保持 ,即所谓 same 卷积的常见设定。
带 pad 与 stride 的统一写法:对填充后序列 ,
手算:padding
,, 时 ,可得到长度仍为 3 的输出。
二维卷积
“ 卷积核(kernel / filter) = 一个很小的数字表,比如 3×3。 这些数字是 可学习参数(类似 Linear 的 weight)。这里介绍晚了,上面的一维卷积也是使用的核去做。 ”
假设输入是一块 5×5 的数字,核是:
Kernel K (3×3):
[ 1,  0, -1 ]
[ 1,  0, -1 ]
[ 1,  0, -1 ]
(这个核有点像「检测竖直边缘」:左边减右边。)
操作步骤:
- 把 3×3 核 盖在 输入的左上角 3×3 区域上
- 对应位置相乘,再全部加起来 → 得到输出的 一个数
- 核向右滑一格,再算一个数……
- 一行滑完,往下移一格,继续
一个输出像素
输入局部 3×3(盖住的那一块):
[ 1, 2, 3 ]
[ 4, 5, 6 ]
[ 7, 8, 9 ]
与核逐项相乘:
1*1 + 2*0 + 3*(-1)  = 1 + 0 - 3  = -2
4*1 + 5*0 + 6*(-1)  = 4 + 0 - 6  = -2
7*1 + 8*0 + 9*(-1)  = 7 + 0 - 9  = -2
---------------------------------
求和 = -6
实际定义
单通道输入 ,核 :
逻辑拆解:
- 选定输出位置 ,在输入上盖住一块 窗口;
- 与核逐项相乘再全部相加,得到一个标量;
- 窗口滑过整张图,填满输出特征图。
也就是二维局部点积(Frobenius 内积):
例子
左上角窗口与核对齐后:
无 pad、stride 时,,。
二维输出尺寸对高、宽分别套一维公式即可。
多通道卷积
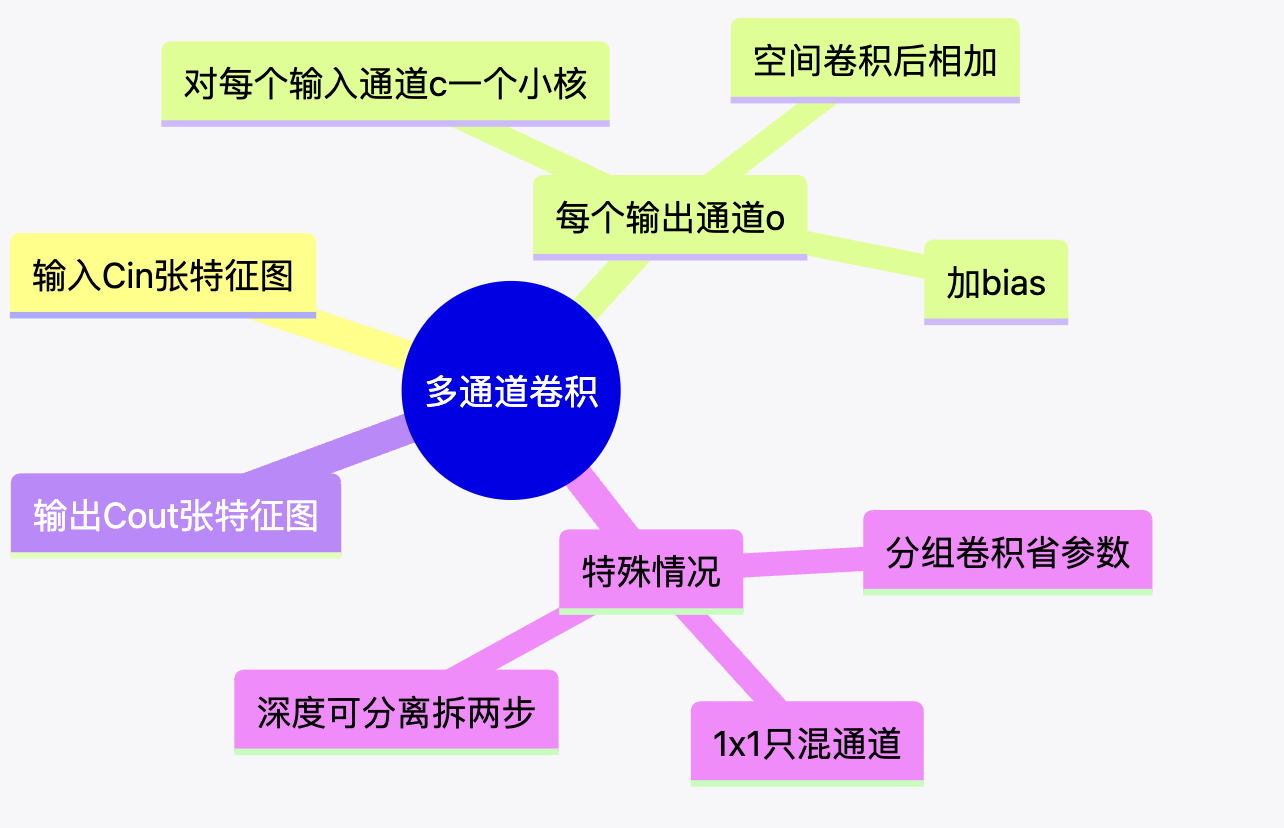
“ 真实输入几乎从不是单平面:RGB 是 3 通道;网络中间常见 64、128、256 通道。通道 = 每个空间位置上特征向量的长度,中间层的通道不是「颜色」,而是学出来的特征维——有点像 Transformer 里的 ,只是布局是网格 而不是序列 。 ”
图 4 多通道卷积
张量形状
| 对象 | Shape |
|---|---|
| 输入 | |
| 核 | |
| bias | 可选 |
| 输出 |
核心公式
(实现中 会先 padding; 为 stride。)
参数量
与 无关。 例如 、:
这是卷积能处理大图的根本原因之一:参数共享。计算量仍大致随 增长:
1x1 卷积
核高宽都是 1 时:
对固定位置 ,这就是:
其中 ,且同一个 用于所有空间位置。
和 Transformer 对照:
序列上的 Linear |
卷积 | |
|---|---|---|
| 每个位置 | 对每个 token 做 | 对每个像素做 |
| 是否混不同位置 | Linear 本身不混 token | 也不混空间邻居 |
| 权重 | 常全序列共享 | 全图共享 |
用途:
- 升维 / 降维(改通道数);
- concat 之后把通道压回去;
- ResNet 瓶颈:
$1\times1$ 降维 → $3\times3$ 空间 → $1\times1$ 升维; - 分割 / 去噪的输出头(得到
n_class或与输入同通道的图)。
关键点:
“ 不扩大空间感受野。 要扩感受野,仍靠 等空间核,或靠下采样。 ”
卷积和结构化稀疏线性层
把输入拉平为 ,输出拉平为 ,任意卷积都可写成:
极度稀疏且高度结构化:同一条对角线上许多元素相等——这就是权值共享。
一维 示意:
可见:
“ 卷积首先是线性变换,只是强制了局部连接 + 权值共享。 非线性来自后面的 ReLU / SiLU / GELU 等。
多层卷积 + 激活,才组成真正的深度 CNN。 ”
视角对比
设位置 的特征为 :
| 模型 | 结构直觉 |
|---|---|
| 全连接 | , 几乎任意,参数易爆 |
| 卷积 | ,只依赖相对位置,邻域局部,核全图共享 |
| Self-Attention | , 随内容动态变化,默认可全局 |
| 卷积一层 | Attention 一层 | |
|---|---|---|
| 感受野 | 局部 | 全局(全序列 / 全 token) |
| 权重 | 经典卷积与内容无关(固定核) | 随 Q、K 内容变 |
| 复杂度 | 与 相关 | 与 相关 |
| 位置信息 | 网格结构自带上下左右 | 需要 RoPE 等位置编码 |
层数、感受野、分辨率、通道
“ 这是容易出现疑惑的概念,这里简要介绍一下。 ”
层数
卷积层数 = 数据依次穿过多少次卷积(通常还带归一化与激活)。示意:
x0 --Conv1--> x1 --Conv2--> x2 -- ...每一层做一次局部(及通道)混合。类比 Transformer 的 “L 层 Block”:CNN 的层数也是「混合了多少次」,但混合范围默认是局部邻域,而不是全局 Attention。
感受野
感受野(Receptive Field):输出特征图上某一个点,最多依赖输入图像上多大一块区域。
仅堆 、stride 全为 1、无 dilation 时,边长大约:
| 层数 | 约感受野边长 |
|---|---|
| 1 | |
| 2 | |
| 3 | |
递推直觉():
所以:层数增加 → 感受野通常增大;此时若一直 same 卷积,分辨率可以不变。
分辨率
分辨率下降 = 特征图的 变小,来自:
MaxPool/AvgPool;Conv的stride=2;- 其他下采样模块。
这是主动设计操作,不是「感受野变大」的数学必然结果。
纠正
| 说法 | 对不对 |
|---|---|
| 层数↑ → 感受野↑ | 对(在有空间卷积的前提下) |
| 下采样 → 分辨率↓ | 对 |
| 下采样 → 后续层对原图等效感受野↑↑ | 对 |
| 感受野↑ 必然 分辨率↓ | 错 |
| 分辨率↓ 常为了更便宜地扩大感受野、减计算 | 对(设计动机) |
为什么下采样后「看得更远」
在特征图坐标里,核仍是 ,只看 9 个格子。但每个格子已经代表原图上更大一块:
原图 2×2 像素  --下采样-->  特征图 1 格
特征图上再 3×3 卷积
≈ 在原图坐标系里覆盖更大区域
(再叠加前面层已有的感受野)
只靠堆 stride=1 的 把感受野扩到整张 ,大约需要上百层,又贵又难训。下采样是用空间分辨率换等效视野和算力。
通道数为什么常跟着变
经典设计(VGG / ResNet / UNet 都常见):
分辨率:  224 → 112 → 56 → 28
通道:     64 → 128 → 256 → 512
分辨率减半时通道常常翻倍。 这不是卷积公式强迫的,而是工程惯例,动机大致有三:
- 容量补偿:空间格点数 ,减半后面积约 ;通道加倍可缓和「格子×通道」总量暴跌。
- 语义变抽象:深层每个位置要用更宽的向量描述(类似加大 )。
- FLOPs 平衡:面积 ,若 都 ,则
各阶段单层算力大致同阶,网络不会在某一尺度突然算爆。
可以设计成通道不翻倍;只是经典架构爱这么配。
四概念对照表
| 概念 | 管什么 |
|---|---|
| 层数 | 混合了多少次;感受野慢涨的主力之一 |
| 分辨率 | 格子多粗;由下/上采样决定 |
| 感受野 | 输出一点看见多大原图 |
| 通道 | 每个格子上特征向量多宽 |
| 只改通道,不改空间感受野 |
小 UNet 尺度
输入 ,通道按 走两级下采样:
| 阶段 | 分辨率 | 通道 | 直观 |
|---|---|---|---|
| Enc 上层 | 64 | 细节多,感受野还小 | |
| Down | 常升到 128 | 格子变粗,等效视野跳涨 | |
| Enc 中层 | 128 | 语义更强 | |
| Down | 常升到 256 | 更粗 | |
| Bottleneck | 256 | 最懂全局,也最糊 | |
| Up + Skip | concat 后卷积融合 | 细节从 Skip 回来 |
扩张卷积与常见变体
Dilation
为普通卷积; 时取样隔一格。参数个数不变,感受野变大,常用于分割(DeepLab)等不想猛降分辨率又想看远的场景。
分组卷积与深度可分离
- 分组卷积:输入通道分组,组内卷积,参数大约除以组数。
- 深度可分离(MobileNet 思路):先每通道独立做空间卷积(Depthwise),再用 混通道(Pointwise)。把「空间混合」和「通道混合」拆开,换效率。
反传
前向(一维示意):
对核的梯度:
的梯度 = 输出梯度图与输入再做一次对齐的局部相关。所以反向仍是卷积型运算。
核从随机初始化变成边缘 / 纹理 / 部件检测器,是梯度下降的结果
为什么光有卷积堆叠还不够?
只在高分辨率上堆卷积:
- 感受野扩大慢、计算贵;
- 很难高效获得全局语义。
反复下采样:
- 语义变强、等效感受野变大、计算变省;
- 边缘、纹理、精确位置丢失(MaxPool 本身就不可逆)。
若在最底层直接上采样回原尺寸:
- 能涂出大概区域;
- 边界糊、细节对不齐。
UNet 正是为这个矛盾设计的拓扑。
UNet
UNet(Ronneberger et al., 2015)原为生物医学图像分割提出,结构是:
“ 对称 Encoder–Decoder + 跳跃连接(Skip Connection) ”
三大部分
图 5 UNet流程
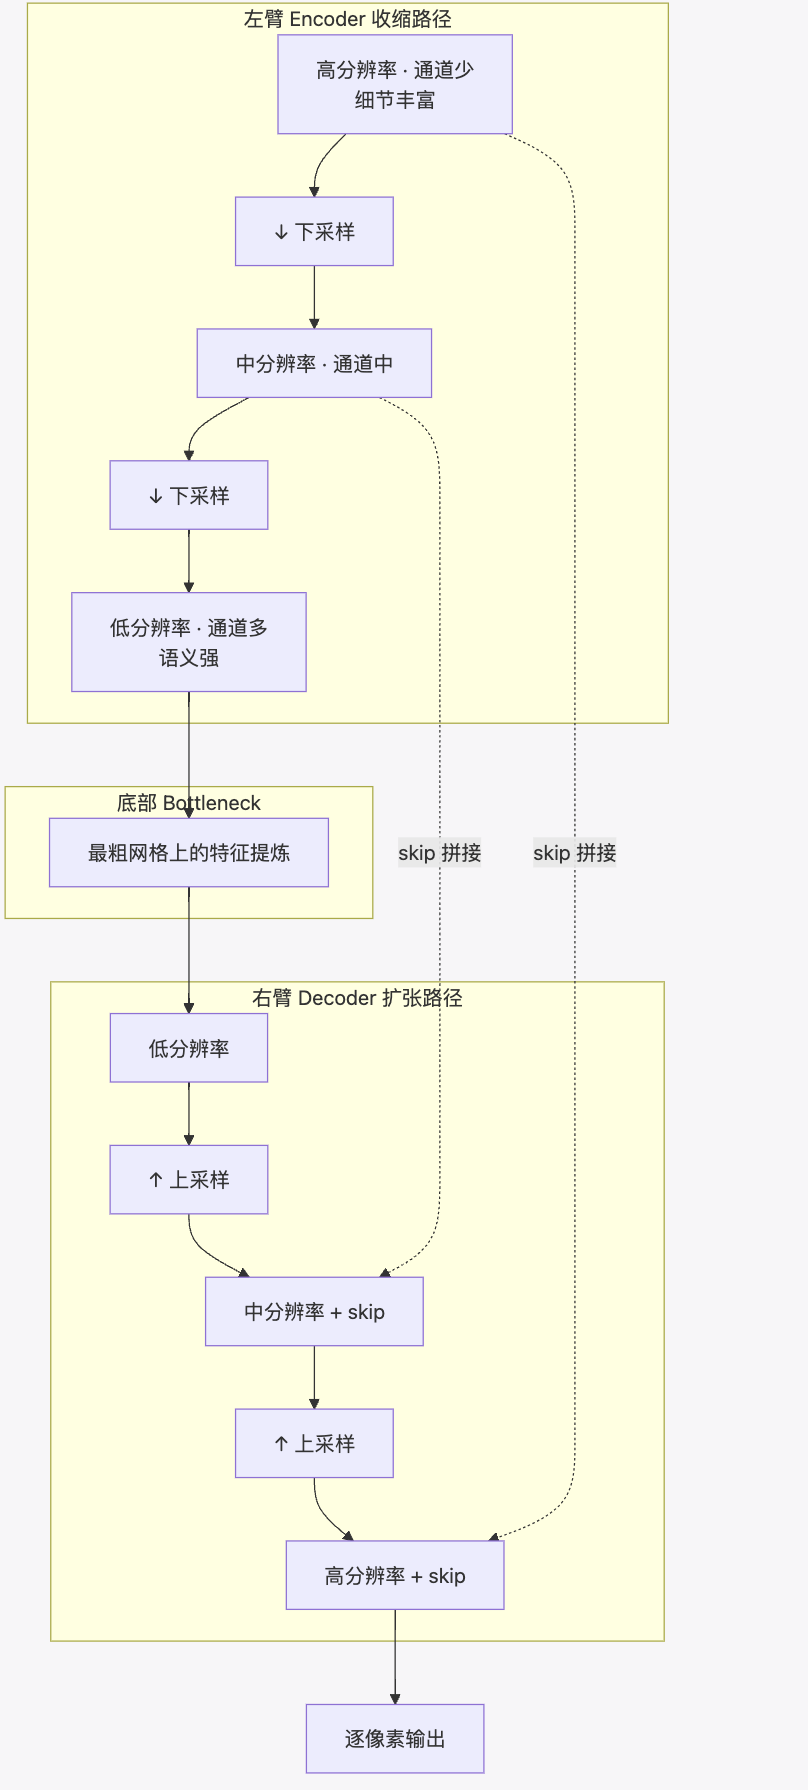
1. Encoder(收缩路径 / 左臂)
- 反复:卷积提特征 → 下采样;
- 分辨率逐步 ,通道常 ;
- 越往下:语义越强,细节越少;
- 每一级的特征图会存起来留给 Skip。
2. Bottleneck(底部)
- 最低分辨率上的特征提炼;
- 感受野大,偏全局语义。
3. Decoder(扩张路径 / 右臂)
- 反复:上采样 → 与对应 Encoder 特征融合 → 卷积;
- 分辨率逐步恢复到输入尺度;
- 输出与输入空间对齐的稠密预测。
Skip
设 Decoder 上采样后特征为 ,对称 Encoder 特征为 ,空间尺寸已对齐。
经典 UNet:通道维拼接
然后再用卷积(常是两个 )把 融合成更合适的通道数。
直觉:
- :从很糊的语义往上抬,带着「这是什么」;
- :编码时留下的「边界、纹理、精确位置」;
- 卷积负责学会如何融合两路信息。
也有实现用相加(需通道对齐),更像残差,参数更省,但融合更硬。原版论文是 copy-and-crop + concat。
一个 Stage
教学简化版:
DoubleConv:
  Conv3x3 → BN → ReLU → Conv3x3 → BN → ReLU

Encoder stage:
  DoubleConv → 保存为 skip → Downsample

Decoder stage:
  Upsample → concat(skip) → DoubleConv
扩散模型里的 UNet 会更复杂:ResBlock、GroupNorm、SiLU、时间步嵌入、Self-Attention、Cross-Attention(文本条件)等。但 U 形 + Skip 的数据流骨架不变。
UNet 整体数据流
以极小教学网络为例:输入 ,base 通道 64,下采样 2 次。
| 步骤 | 模块 | Shape | 说明 |
|---|---|---|---|
| 0 | 输入 | 原图 | |
| 1 | Enc1 | skip1 | |
| 2 | Down | 分辨率÷2 | |
| 3 | Enc2 | skip2 | |
| 4 | Down | ||
| 5 | Bottleneck | 最底层 | |
| 6 | Up | 上采样(通道实现可不同) | |
| 7 | Concat skip2 | ||
| 8 | Dec 融合 | 卷积压通道 | |
| 9 | Up | ||
| 10 | Concat skip1 | ||
| 11 | Dec 融合 | ||
| 12 | 头 | 或 | 逐像素输出 |
伪代码:
function UNet_forward(x):
    skips = []
    for stage in encoder_stages:
        x = DoubleConv(x)
        skips.append(x)
        x = Downsample(x)

    x = Bottleneck(x)

    for stage, skip in zip(decoder_stages, reversed(skips)):
        x = Upsample(x)
        x = Concat(x, skip)      # 通道维
        x = DoubleConv(x)

    return Head_1x1(x)
训练任务
语义分割
输入 x: (B, 3, H, W)
标签 y: (B, H, W)          # 每像素类别
输出 logits: (B, n_class, H, W)
loss = CrossEntropy(logits, y)  # 在所有像素上平均
去噪 / 扩散中的去噪器
输入:  noisy 图或 latent x_t,以及时间 t(常还有文本条件)
输出:  预测噪声 ε(或 v / x0),空间尺寸与输入对齐
loss = MSE(ε_pred, ε_true)为何合适?因为任务要求同尺寸稠密输出,且同时需要大范围语义与像素级对齐——正是 U 形 + Skip 的设计目标。
和语言模型训练对照
| Transformer LM | UNet 分割 / 去噪 | |
|---|---|---|
| 一个样本 | 一串 token | 一张图(网格) |
| 输出对齐 | 每个位置一个词表分布 | 每个像素一个类 / 一个连续向量 |
| 空间结构 | 靠位置编码注入 | 卷积 + 网格结构自带 |
扩散 UNet
| 项目 | 2015 医学分割 UNet | 现代扩散 UNet(如 SD 1.x/2.x) |
|---|---|---|
| 输入 | 生物医学图像 | 噪声图像或 VAE latent |
| 条件 | 无或弱 | 时间步 、文本 Cross-Attention 等 |
| 块结构 | Conv + ReLU 为主 | ResNet 块、GroupNorm、SiLU |
| 注意力 | 无 | 常在中低分辨率插入 Self/Cross-Attn |
| 输出 | 分割 map | 噪声 / v-prediction / x0 等 |
| 深度与通道 | 相对小 | 很大 |
时间条件注入的常见直觉:把 做成嵌入向量,在 ResBlock 里做 scale/shift(AdaGN / FiLM)或相加,使同一套权重在不同噪声水平下表现不同去噪行为。
文本条件:在 UNet 中部用 Cross-Attention,让空间 token 作为 query、文本为 key/value。
UNet vs Transformer
| 维度 | UNet(卷积经典形态) | Transformer |
|---|---|---|
| 基本单元 | Conv / 上下采样 / Skip | Attention + FFN |
| 拓扑 | U 形多尺度 | 多为等长 token 直筒堆叠(ViT/DiT);也有层次变体 |
| 依赖范围 | 单层局部;深层与下采样后变大 | 一层可全局 |
| 位置 | 网格自带 | 需 RoPE 等 |
| 擅长 | 同尺寸稠密预测、局部细节、中小数据分割 | 语言、全局关系、大规模异质数据 scaling |
| 在扩散史中 | DDPM/SD 经典去噪器 | DiT / SD3 等证明可 SOTA |
“ UNet 是为网格上多尺度重建而生的拓扑;Transformer 是为集合/序列上全局关系而生的算子。 生成范式(扩散)可以挂在不同骨干上; ”
而且融合也很常见:UNet 里插 Attention;卷积 stem + Transformer body;层次化 / 带 skip 的 Transformer 等。
和生成范式的关系
“ 我们可以讨论一下讨论过大模型的三维拆分:生成范式 × 骨干 × 组成形态。 ”
图 6 生成范式
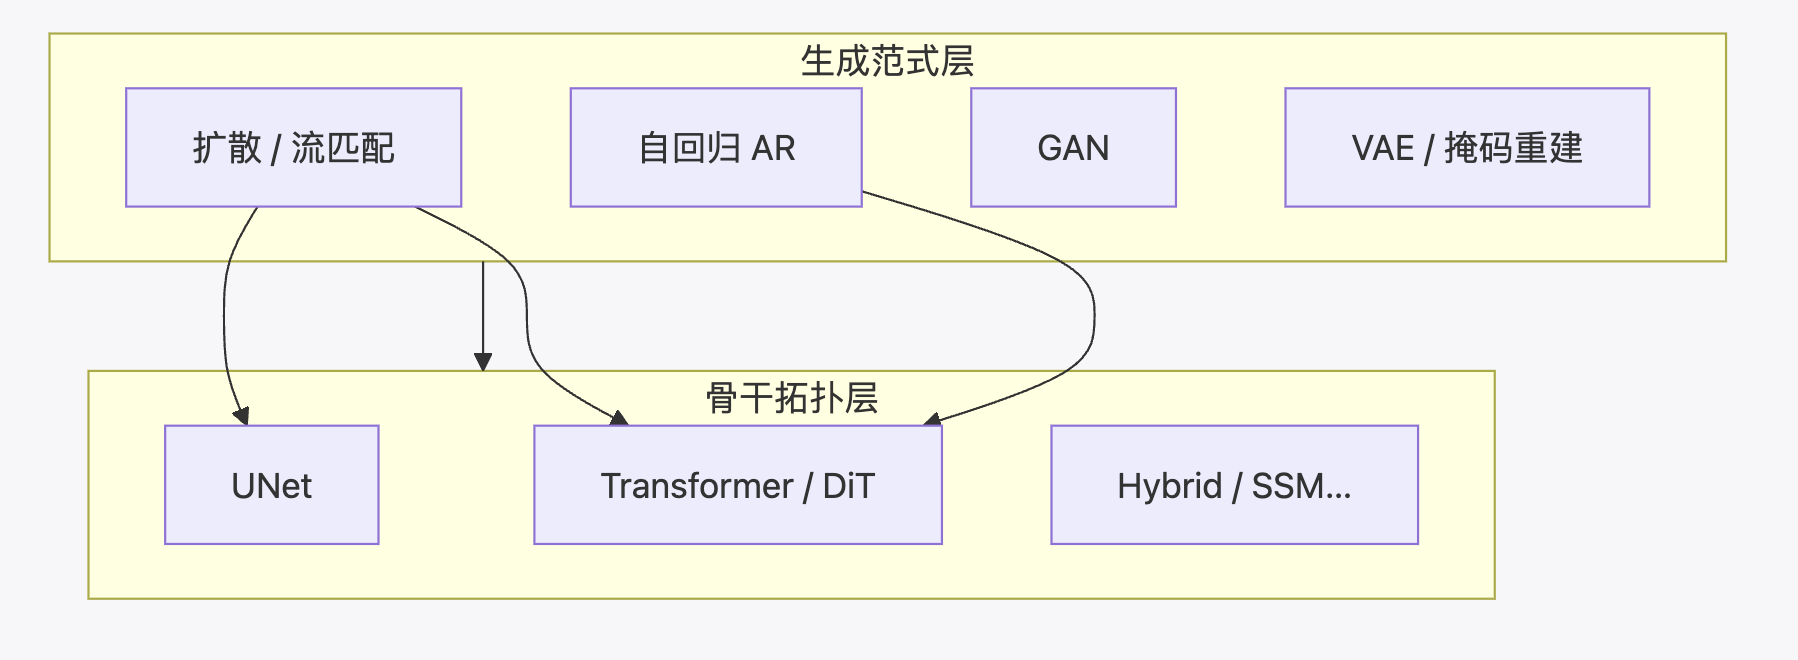
在图像扩散里:
- 范式:多步去噪(或流匹配);
- 骨干:可以是 UNet,也可以是 DiT;
- 空间:常在 VAE 连续 latent 里做,而不是直接像素(LDM 的关键工程点)。
对比语言模型:
- 范式:多为自回归 next-token;
- 骨干:Decoder-only Transformer;
- 空间:离散 token。
“ 在网格数据上做同尺寸稠密预测,又要多尺度语义与细节时,UNet 拓扑非常对症。
它不是所有视觉任务的唯一解,更不是语言任务的默认解。 ”
回顾与思考
“ 这是笔者加入的新模块,也方便我自己回顾与思考,很多都是我自己学习的疑问 ”
T1. 输入 shape 为 ,Conv2d(3,16,kernel_size=3,padding=1,stride=1),输出 shape 与含 bias 参数量分别是多少?
T2. 只增加 卷积层数,空间感受野会变大吗?为什么?
T3. 两层 、stride 全 1,感受野边长大约多少?若一直 same padding,分辨率会变吗?
T4. 数学卷积为何常翻转核,而深度学习框架通常不翻转?
T5. UNet 经典 Skip 是 concat 还是 add?concat 后通道数如何变?
T6. 残差 与 UNet Skip 最关键的两点差别是什么?(这个对比很有意思)
T7. 为什么说「位置可表示」不等于「模型真的会用长程信息」——这个问题和 UNet 哪一个设计动机是同构的?
参考
T1. 输出 ;参数 。
T2. 不会。
T3. 约 ;分辨率可以不变。
T4. 表达力等价;实现与反传更直接;框架统一为互相关。
T5. 经典为 concat;通道变为两侧之和,再由后续卷积压回。
T6. (1)残差多同尺寸相加,Skip 多跨路径 concat;(2)残差偏优化与恒等映射,Skip 偏多尺度细节回注。
T7. 同构于:下采样让网络「有能力」看远,但不自动保证细节仍在——需要 Skip 等结构把细节通路接回来;长上下文同理,RoPE scaling 解决「能表示」,数据与架构决定「会使用」。
小结
- 卷积用局部模板滑动点积,强制局部性与权值共享;多通道时再对输入通道求和,形成 组检测器。
- 层数增加感受野;下采样降低分辨率并放大后续层对原图的等效视野;通道常随阶段加宽以平衡容量与算力——三者相关但不是同一件事。
- UNet 用 Encoder 换语义与大感受野,用 Decoder 恢复分辨率,用 Skip 送回细节,专治稠密预测里的语义—定位矛盾。
- UNet 是骨干,不是生成范式;扩散可以挂 UNet 或 Transformer;语言默认仍是 Transformer。
笔者的话
笔者终于在漫长的期末周后回归了。这篇之所以写得偏长,是因为这些概念一旦拆开讲,就会在别的地方以别的名字再出现一次:比如说 UNet 不讲 Skip,讲不出具体的卷积是怎么做的,那就容易发虚。
参考文献
- LeCun et al. Gradient-Based Learning Applied to Document Recognition.
CNN 早期系统工作的重要代表。
- Ronneberger, Fischer, Brox, 2015. U-Net: Convolutional Networks for Biomedical Image Segmentation.
UNet 原始论文。
https://arxiv.org/abs/1505.04597
- He et al., 2016. Deep Residual Learning for Image Recognition.
残差连接;与 UNet Skip 对照阅读。
https://arxiv.org/abs/1512.03385
- Goodfellow, Bengio, Courville. Deep Learning.
卷积、池化、反传等教科书级推导。
- Dumoulin & Visin. A guide to convolution arithmetic for deep learning.
卷积算术、转置卷积尺寸。
https://arxiv.org/abs/1603.07285
- Ho et al., 2020. Denoising Diffusion Probabilistic Models.
扩散与去噪网络设定。
https://arxiv.org/abs/2006.11239
- Rombach et al., 2022. High-Resolution Image Synthesis with Latent Diffusion Models.
LDM / Stable Diffusion:VAE latent + UNet。
https://arxiv.org/abs/2112.10752
- Peebles & Xie, 2023. Scalable Diffusion Models with Transformers (DiT).
用 Transformer 替代 UNet 做扩散骨干。
https://arxiv.org/abs/2212.09748
- Vaswani et al., 2017. Attention Is All You Need.
与卷积对照的全局混合基线。
https://arxiv.org/abs/1706.03762
- Chollet, 2017. Xception;Howard et al. MobileNets.
深度可分离卷积的重要实践来源。