Transformer|架构演进(3):Vocab 系统(3)——高效词表、词表适配与 Tokenizer-free
阅读提示: Vocab的最后一部分,是时候说再见了,“萨扬娜拉”。祝食用愉快~🥹
导言
“ 前两篇里,我们默认了一件事:模型有一个固定词表。 ”
图 1 非固定词表
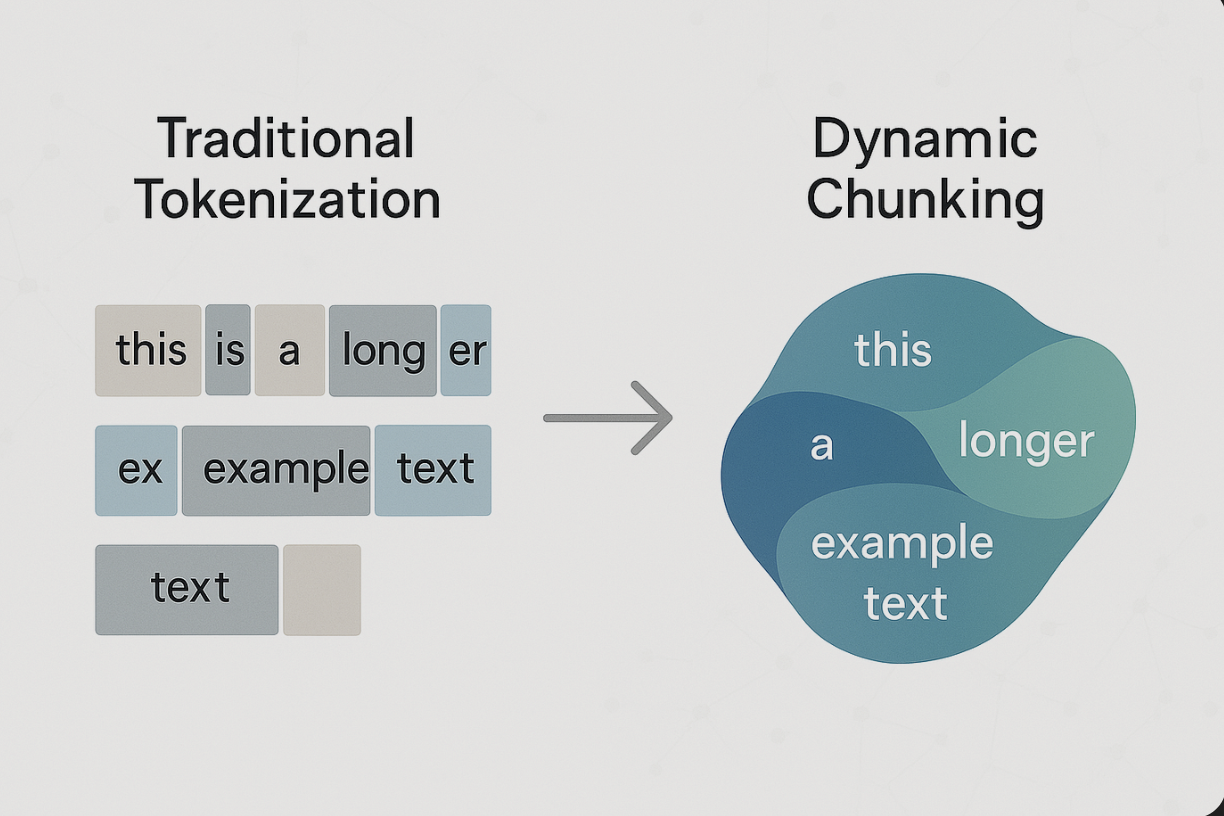
第一篇讲 tokenizer,讨论文本如何被切成 token,以及为什么 vocabulary size 会影响序列长度、上下文效率、多语言公平性和推理成本。
第二篇讲 embedding、LM Head 和 tied embedding,讨论 token 如何进入模型,又如何从模型输出。我们看到,词表越大,input embedding 和 LM Head 越重;小模型更需要 tied embedding,大模型则会在参数效率和表达自由度之间做权衡。
但到这里还有一个更大的问题没有解决:
“ 如果固定词表本身不够高效、不够公平、不够灵活,我们该怎么办? ”
固定词表系统的局限很明显。
大词表会让 embedding 和 LM Head 变重;小词表会让 token 序列变长。英语中心 tokenizer 对其他语言可能不公平。领域专有词可能被切得很碎。代码、数学、工具调用格式和普通自然语言又不完全一样。更麻烦的是,fixed tokenizer 一旦训练好,后续很难适应新领域、新语言和新模态。
-
所以,Vocab 系统的后续优化大致沿着三条路线展开:
- 压缩它:在固定词表内做高效输出、高效 embedding、高效并行和高效 tokenization;
- 适配它:根据语言、领域、任务和部署需求扩展或裁剪词表;
- 替代它:走向 byte-level、tokenizer-free、dynamic patching 等新范式。
固定词表的问题
固定词表系统的核心矛盾,可以用两个变量概括:
- :vocabulary size;
- :tokenized sequence length。
词表小, 小,embedding 和 LM Head 便宜,但文本会被切得更碎, 变长。序列一长,attention、KV cache、prefill、decode step 都会变贵。
词表大, 变短,token efficiency 更高,同样 context window 能装下更多原始信息,但 变大,input embedding、LM Head 和 softmax 都会变重。
这就是固定词表系统的基本 trade-off:
“ 小词表省参数,但浪费序列长度;大词表省 token,但增加词表参数和输出计算。 ”
前两篇已经讲过 embedding 和 LM Head 的参数压力。这里我们进一步看:当固定词表已经成为系统瓶颈时,有哪些方法可以继续优化?
在固定词表内提高效率
“ 最直接的思路是:我们仍然使用 fixed vocabulary,但不再天真地给每个 token 同样的计算和表示待遇。 ”
自然语言的 token 分布高度不均匀。少数高频 token 覆盖了大量文本,大量低频 token 很少出现。这个 Zipf 分布特性,是很多高效词表方法的出发点。
Adaptive Softmax
在 decoder-only language model 里,LM Head 要把 hidden state 映射到整个 vocabulary 上。
如果 hidden size 是 ,词表大小是 ,那么每一步输出 logits 大致需要一个 的投影。
当 很大时,这一步会非常重。
Adaptive Softmax 的想法是:
“ 高频 token 经常被预测,应该快速、精细地建模;低频 token 很少出现,可以放进更粗的分层结构里,减少平均计算成本。 ”
Grave 等人在 2017 年提出 Efficient Softmax Approximation for GPUs,利用词频不均衡把词表分成 head 和 tail。高频词直接计算,低频词分簇计算,从而降低大词表输出概率的计算成本。
直觉上,它不是每次都完整扫一遍所有词,而是先判断大类,再在对应低频簇里细分。
这类方法在早期大词表 word-level language model、WikiText-103、Transformer-XL 等场景很重要。它解决的是:
“ 大词表输出层太贵,能不能利用词频分布降低平均计算? ”
不过,在现代旗舰 LLM 里,Adaptive Softmax 并不是最主流的训练方式。原因也很现实:full softmax 简单、稳定、容易并行;大规模训练系统也已经能通过 tensor parallel、vocab parallel、fused cross entropy 等方式处理巨大的 LM Head。
所以 Adaptive Softmax 更像是一个经典方法论:它告诉我们,词表里的 token 并不应该被完全平等对待。高频和低频 token 可以有不同的计算路径。
Adaptive Input Representations
“ 既然输出侧可以按词频分配计算,那么输入侧是否也可以按词频分配表示容量? ”
这就是 Adaptive Input Representations 的思路。
普通 embedding table 给每个 token 一个同样维度的向量。无论这个 token 是高频的 “the”,还是一年出现不了几次的罕见词,都拥有同样大的 embedding capacity。
这显然不一定合理。
Baevski 和 Auli 在 2019 年提出 Adaptive Input Representations for Neural Language Modeling,把 adaptive softmax 的思想扩展到 input embedding:高频词使用更高维表示,低频词使用更低维表示,然后再投影到模型 hidden space。
它的核心思想是:
“ 频繁出现的 token 值得更多参数;极低频 token 不应该占用和高频 token 一样多的表示容量。 ”
这和第二篇讲的 factorized embedding、tiny embedding 是同一类问题:词表参数应该如何分配。
Tied embedding 解决的是“输入输出是否重复存两份”。Factorized embedding 解决的是“每个 token 是否需要完整 hidden size”。Adaptive input 进一步问的是:
“ 不同 token 是否应该拥有不同大小的表示容量? ”
这在小模型、端侧模型、多语言大词表中仍然很有启发。
Vocab Parallelism
“ 在现代大模型训练中,很多时候不会用 approximate softmax,而是保留 full softmax,然后靠系统并行解决。 ”
这背后的原因很简单:full softmax 更稳定,训练目标更干净,也更容易和主流框架兼容。
但 full softmax 的代价也很明确。训练时 logits 张量通常是:
如果 是 150K、200K 或 260K,这个张量会非常大。
Megatron-LM 这类系统会把 embedding / unembedding 按 vocabulary dimension 切分,并把 parallel GEMM 和 cross-entropy loss 融合,避免通信完整 logits。Megatron-LM 论文中就明确讨论了并行化 output embedding GEMM 以及 fused cross entropy 对通信量的降低。
所以,在今天的旗舰 LLM 中,“高效词表”不只是算法问题,也是系统问题。
可以这样理解:
“ 早期方法想少算 softmax;现代大模型更多是完整计算 softmax,但把它切开、并行、融合和优化。 ”
这也是为什么 Vocab 系统和训练框架、分布式并行、推理 kernel 之间关系越来越紧。
更高效的 tokenization
“ 前面几个方法主要优化 相关的参数和计算。但还有另一条思路:不一定先压缩 embedding 或 LM Head,而是让 tokenizer 切得更高效,减少序列长度 。 ”
现代大模型越来越重视 token efficiency。比如 LLaMA 3 从 LLaMA 2 的 32K tokenizer 提升到 128K tokenizer,就是为了更高效地编码文本。Qwen、Gemma、Mistral 等模型也使用了更大的词表或更平衡的 tokenizer。
最近还有一些工作进一步挑战传统 subword tokenizer 的边界。一个典型方向是允许 token 跨越空格边界,也就是不再假设 token 必须是单词内部的 subword。
SuperBPE 就是这类方法。它指出,大多数 tokenizer 默认 token 应该在 word boundary 内部,但空格并不总是可靠的语义边界。比如 “by the way” 是一个常见多词表达,德语里一个概念可能压缩成一个复合词,中文日文又没有显式空格。因此,SuperBPE 允许 BPE 学习跨空格的 “superword” token,在固定词表大小下能显著减少 token 数,并报告在 8B 规模英文 LM 上带来下游任务提升和推理计算减少。
这类方法的意义在于:
“ 高效词表不只是让 embedding 更小,也可以让文本被压缩得更好。 ”
它把 tokenizer 从“子词”推进到“短语级、跨边界、语义块级”的方向。
当然,这里也有风险。跨空格 token 可能让词表更偏向训练语料中的常见短语,对低资源语言、形态丰富语言或开放域泛化可能需要更细致的平衡。但它说明一个趋势:现代 tokenizer 仍然有很大改进空间。
让词表适应任务、语言和领域
“ 第一条路线是在固定词表内提升效率。第二条路线则是:既然固定词表不一定适合所有场景,那我们能不能根据目标任务修改它? ”
这就是 vocabulary adaptation。
它包括两个相反方向:
- Vocabulary Expansion:添加新 token;
- Vocabulary Pruning:删除不需要的 token。
前者解决“词表不够用”;后者解决“词表太臃肿”。
Vocabulary Expansion
假设我们拿一个英语中心模型去做韩语、中文、生物医学、法律、游戏文本或代码领域。
很多目标领域里的高频词,原 tokenizer 可能切得很碎。
例如医学术语、化学名词、法律条款名、API 名称、游戏世界观专名,如果被拆成多个 subword,就会带来几个问题:
- token 序列变长;
- 上下文窗口被浪费;
- 领域实体表示分散;
- 输出这些词需要多个 decode step;
- 模型需要通过多个 token 组合来学习一个领域概念。
所以,vocabulary expansion 的想法很直接:
“ 把目标语言或目标领域中的高价值多 token 片段加入词表,让它们成为单个 token。 ”
但这件事并不只是 tokenizer.add_tokens 那么简单。
新 token 加入词表后,模型需要新的 input embedding,也需要新的 output unembedding / LM Head vector。如果初始化不好,模型可能会生成奇怪 token,或者原有能力退化。
-
因此,vocabulary expansion 的关键问题有三个:
- 加哪些 token?
- 新 token 的 input embedding 怎么初始化?
- 新 token 的 LM Head vector 怎么初始化,并如何训练?
EEVE
“ EEVE 是一个典型的多语言词表扩展示例。它面向韩语适配,针对英语中心模型在韩语文本上 tokenization 低效的问题,提出使用 vocabulary expansion、subword-based embedding initialization 和分阶段参数冻结训练。报告中指出,它可以在相对较少的 2B token 训练下显著提升韩语能力。 ”
它代表了一类实际工程路线:
- 从目标语言或领域语料中训练/挖掘新 token;
- 将这些 token 加入原 tokenizer;
- 用已有 subword 的 embedding 组合来初始化新 token;
- 初期冻结大部分模型,只训练新增 embedding 或少量层;
- 再逐步解冻进行 continued pretraining。
这种方法适合从一个强大的通用基础模型出发,把它适配到目标语言或领域。
它的核心观点是:
“ 与其让模型长期忍受低效切分,不如改造词表,让目标语言以更自然、更短的 token 序列进入模型。 ”
“inner lexicon”
“ 更前沿的 vocabulary expansion 不只是看 tokenizer 频率,还开始研究模型内部是否已经形成了“词级表示”。 ”
From Tokens to Words: On the Inner Lexicon of LLMs 这篇 ICLR 2025 工作提出:虽然 LLM 输入是 subword token,但模型内部可能会把多 token word “detokenize” 成一个相对完整的内部表示。基于这个现象,他们提出一种后验词表扩展方法:先从模型内部抽取某个 multi-token word 的表示,再学习映射到 input embedding 和 output unembedding 空间,为新词构造 embedding / unembedding。
这比简单平均 subword embedding 更有意思。
普通初始化可能是:
“ 新词 embedding = 它拆开的几个旧 token embedding 的平均。 ”
而 inner lexicon 方法更像是在问:
“ 模型内部是否已经知道这个词是一个整体?如果知道,我们能不能把这个内部整体表示提取出来,变成一个新 token? ”
论文报告这种方式可以减少 token 数,同时保持或轻微改善模型表现。
这代表一个很重要的趋势:
“ 词表适配不再只是 tokenizer 工程,而开始和模型可解释性、内部表示、embedding space 对齐结合起来。 ”
AdaptiVocab
“ 另一个很实际的方向是面向 focused domain 做词表适配。 ”
AdaptiVocab 提出,在特定领域里,通用模型的完整能力和完整词表未必都需要。它通过把通用 token 替换或扩展成领域特定 n-gram token,减少输入和输出 token 数,并通过轻量微调保持性能。论文报告在若干 niche domains 上 token usage 可以减少 25% 以上,同时不损害性能。
这个方向很实用。比如在医疗、法律、金融、电商、代码仓库、企业知识库中,大量高频短语和专业术语是稳定的。让这些短语成为更大的 token,可以直接减少 decode steps 和上下文消耗。
它说明 vocabulary adaptation 不只是为了多语言能力,也可以服务于低延迟、低成本的垂直场景部署。
Vocabulary Pruning
Expansion 是加 token,pruning 是删 token。
为什么要删?
因为很多模型的词表是为通用场景设计的。它可能覆盖大量语言、符号、emoji、代码片段、控制 token。但如果你的应用只服务某个语言或某个领域,其中大量 token 永远不会用到。
这时,完整 embedding 和 LM Head 就是浪费。
例如,多语言模型经常有 200K 以上词表。如果你只做法语、中文或某个企业内部英语任务,很多 token 都可以裁掉。
Vocabulary pruning 的思路是:
“ 删除低频或无关 token,同时裁剪 embedding 和 LM Head 中对应的行。 ”
这能直接减少参数量、显存占用和部分输出计算。
早期一些工具已经在做 multilingual LM 的 vocabulary trimming,比如把 mT5 这类大词表多语言模型裁成目标语言子词表,以降低模型大小和微调成本。
COMPACT
“ 更近期的 COMPACT 把 vocabulary pruning 和 FFN pruning 结合起来。它观察到不同规模模型的参数分布不同,小模型中 vocab 参数占比很高,大模型中 FFN 参数更重。因此,它提出同时剪掉 rare vocabulary 来缩小 embedding / LM Head,并用 common-token-weighted activations 来剪 FFN channel。论文在 Qwen、LLaMA、Gemma 等 0.5B 到 70B 模型上做实验,目标是同时减少参数、GPU memory 和 latency。 ”
这个方向很有价值,因为它把词表剪枝放回整个模型压缩框架中看。
对于小模型来说,vocab pruning 可能比剪 attention 或 FFN 更直接有效。对于大模型来说,vocab pruning 可以和 FFN pruning 一起组合。
它背后的思想是:
“ 模型压缩不能只看 Transformer block,embedding 和 LM Head 也是重要参数来源,尤其在大词表小模型中。 ”
Tokenizer-free
“ 前面两条路线都默认 tokenizer 仍然存在。 ”
-
但 fixed tokenizer 有一些根本限制:
- 它在训练前固定;
- 它依赖参考语料;
- 它可能偏向高资源语言;
- 它不容易适应新词、新拼写、新符号;
- 它对噪声、typos、代码混合文本不一定鲁棒;
- 它人为规定了模型的输入边界。
所以,越来越多工作开始问:
“ 能不能不使用固定 subword tokenizer? ”
这就是 tokenizer-free 或 tokenizer-light 的方向。
CANINE
CANINE 是 tokenizer-free encoder 的代表。它直接处理 character sequence,不依赖固定 subword vocabulary,并通过 downsampling 缩短序列,让后续 Transformer 能处理更长的字符输入。CANINE 在 TyDi QA 等多语言任务上表现出对 mBERT 的竞争力,并且参数更少。
它的意义在于:模型不再需要预先训练一个词表,而是从字符层面学习语言。
但字符级方法的问题也很明显:序列太长,计算成本高,尤其对 decoder-only 生成模型更困难。
ByT5
ByT5 是 byte-level encoder-decoder 模型。它基于 T5/mT5 框架,直接处理 UTF-8 bytes,而不是 subword token。ByT5 的目标是走向 token-free future,并且在多语言任务和输入扰动鲁棒性上表现出优势。
Byte-level 的好处是覆盖任何文本,不需要 OOV,也不依赖 Unicode 字符表。
但代价仍然是序列变长。原本一个 subword token 可能对应多个 byte。序列一长,标准 Transformer 的 attention 成本就会上升。
所以 ByT5 证明了 byte-level 建模可行,但也暴露了效率问题。
Charformer
Charformer 走的是另一条路线:不是完全放弃 tokenization,而是把 tokenization 的一部分变成模型内部可学习的过程。
它提出 Gradient-Based Subword Tokenization,也就是 GBST。模型从字符或 byte 输入出发,枚举局部 span,然后学习如何把它们组合成 latent subword representation。Charformer 报告其在英语、多语言和噪声文本任务上能和 subword 模型竞争,并优于一些 byte-level baseline。
它的重要意义是:
“ token boundary 不一定要在训练前固定,也可以成为模型内部学习到的结构。 ”
这条路线和传统 tokenizer 的差别很大。传统 tokenizer 是模型外部的静态模块;Charformer 这类方法试图把切分决策融入模型。
MEGABYTE
MEGABYTE 面对的是 byte-level 序列过长的问题。
它把 byte sequence 分成 patch,用局部模型处理 patch 内部,用全局模型处理 patch 之间。这样可以避免在每一个 byte 上都使用昂贵的全局 attention。
MEGABYTE 的目标是让 byte-level autoregressive modeling 能扩展到更长序列,例如文本、图像、音频等原始 byte 数据。NeurIPS 2023 的介绍中提到,它可以建模超过一百万 byte 的序列,并让 byte-level 模型在长上下文语言建模上更接近 subword 模型。
这个方向的关键是:
“ 如果不用 tokenizer,就必须重新设计序列建模架构,否则 byte 序列太长。 ”
BLT
Byte Latent Transformer,简称 BLT,是目前非常值得关注的 tokenizer-free / byte-level 方向。
BLT 不使用固定 vocabulary,而是直接处理 raw bytes,并根据 next-byte entropy 动态形成 patch。容易预测的区域可以合成较长 patch,复杂区域则使用更短 patch。这样,模型把更多计算分配到复杂文本位置,把更少计算分配到简单、可预测位置。
BLT 论文声称它可以在 scale 上匹配 tokenization-based LLM,并带来推理效率和鲁棒性提升;它还做了到 8B 参数、4T training bytes 的 FLOP-controlled scaling study。
它和传统 tokenizer 的区别非常本质。
传统 tokenizer 是:
“ 训练前固定切分规则。 ”
BLT 是:
“ 根据输入复杂度动态形成计算单位。 ”
这可能是未来很重要的方向,因为它把“token”从静态词表项变成了动态 patch。
不过,BLT 这类方法仍然需要复杂架构支持。它不是把现有 LLaMA 的 tokenizer 拿掉就行,而是需要 local encoder、latent transformer、local decoder 等结构共同工作。
T-FREE
图 2 T-Free
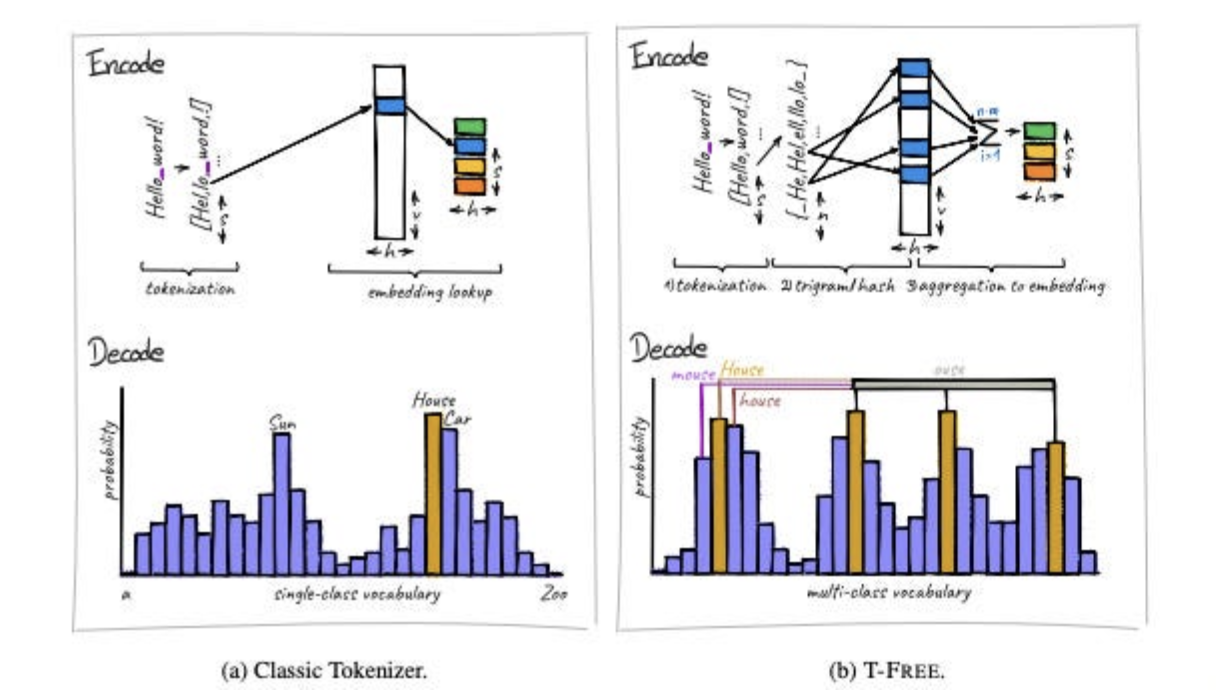
T-FREE 是另一个有趣方向。它不走传统 subword vocabulary,而是通过字符 triplet 的稀疏激活模式直接表示词。它不需要 reference corpus 来训练 tokenizer,并且显式利用形态相似性。EMNLP 2024 论文报告其在 embedding/head 层可以减少超过 85% 参数,同时保持竞争性下游表现,并改善 cross-lingual transfer。
T-FREE 和 BLT 不完全一样。BLT 更像是 byte-level dynamic patch architecture;T-FREE 更像是替代传统 tokenizer/embedding 的稀疏表示系统。
但它们都在挑战同一个假设:
“ 文本一定要先映射到一个固定 subword vocabulary 吗? ”
Tokenizer-free 还没有成为主流?
“ 看起来 tokenizer-free 很有吸引力:没有 OOV,没有词表偏置,更适合多语言和噪声文本,也更适合未来多模态统一。但它还没有取代主流 fixed tokenizer,原因也很现实。 ”
序列长度成本
byte 或 character 序列比 subword 序列长很多。
如果模型架构仍然是标准 Transformer,那么 attention 和 KV cache 成本会迅速上升。
所以 tokenizer-free 往往必须配合 downsampling、patching、local-global architecture 或 linear attention 等结构。
训练系统不兼容
现有 LLM 训练系统高度围绕 token sequence 优化。
数据 pipeline、packing、loss、KV cache、推理引擎、benchmark、API 计费,几乎都默认 token 是离散词表 ID。
Tokenizer-free 改变的不只是模型输入,还会改变整个训练和服务系统。
解码和可控性问题
传统 token 是离散 vocabulary item,生成时比较容易做 top-k、top-p、bad words filter、grammar constraint、JSON constraint。
如果模型按 byte 或 patch 生成,如何稳定约束输出、如何避免无效 UTF-8、如何做结构化解码,都需要重新设计。
迁移成本
现在有大量强大的 pretrained LLM 已经基于 fixed tokenizer 训练好。
要让 tokenizer-free 成为主流,不仅要从头训练强模型,还要解决如何复用现有模型能力的问题。
所以短期内,fixed tokenizer 仍然会是主流;中长期,dynamic byte patching、sparse token-free representation 和 learned tokenization 会继续发展。
高效词表
-
评价 tokenizer 或 vocab adaptation常见指标包括:
- fertility:一个词平均被切成几个 token;
- compression ratio:文本压缩成 token 的效率;
- token count per language;
- bits-per-byte;
- LM loss / perplexity;
- downstream benchmark;
- prefill latency;
- decode latency;
- memory footprint;
- embedding / LM Head 参数占比;
- 多语言 token premium;
- 输出质量和稳定性。
Ali 等人的 Tokenizer Choice For LLM Training 也指出,fertility 和 parity 等指标并不总能可靠预测下游效果;tokenizer choice 会显著影响模型下游性能、训练成本和推理成本。
所以,一个好的 tokenizer 不只是压缩率高,还要能让模型学得好、推得快、跨语言公平、领域适配稳定。
小结
-
现在可以把 Vocab 系统整体串起来:
- Tokenizer 决定模型读取文本的基本单位;
- Vocab size 决定序列长度和词表参数的权衡;
- Input embedding 是语言进入模型的入口;
- LM Head 是模型回到语言世界的出口;
- Tied embedding 让输入输出共享同一套词表表示;
- Adaptive softmax / input representation 利用词频不均衡提升效率;
- Vocabulary expansion 让模型适应新语言和新领域;
- Vocabulary pruning 让模型适应部署和低成本推理;
- Tokenizer-free 则试图摆脱 fixed vocabulary 这个前提。
-
未来 Vocab 系统可能会沿着两条线同时发展。
- 短期内,主流 LLM 仍然会使用 fixed subword tokenizer,但会越来越重视 vocab size scaling、多语言平衡、代码友好、大词表并行、embedding/LM Head 压缩和领域适配。
- 长期看,tokenizer-free、dynamic byte patching、learned tokenization 和 inner lexicon-based vocabulary adaptation 会持续挑战固定词表范式。
“ Vocab 系统不只是简单的文本预处理,同时是大模型在语言世界和向量世界之间的接口;它决定模型如何压缩语言、表示语言、生成语言,也决定模型在规模、效率、多语言、领域适配和未来架构上的重要边界。 ”
笔者的话
“ 第一部分Vocab到这里结束了,有些部分讲的不算很细,因为笔者对后面的几个组件的偏重要大一点,具体对相关组件有兴趣的请具体自己去看,笔者主要起到一个整理导览叙述的作用。下次再见。 ”
参考文献
- Grave et al., 2017. Efficient Softmax Approximation for GPUs.
Adaptive Softmax 的经典论文。
- Baevski & Auli, 2019. Adaptive Input Representations for Neural Language Modeling.
将 adaptive softmax 思想扩展到 input embedding。
- Shoeybi et al., 2019. Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism.
讨论 embedding / output layer 的并行化和 fused loss。
- Kim et al., 2024. Efficient and Effective Vocabulary Expansion Towards Multilingual Large Language Models.
EEVE,面向韩语适配的 vocabulary expansion 方法。
- Kaplan et al., 2025. From Tokens to Words: On the Inner Lexicon of LLMs.
利用模型内部 detokenization 表示进行词表扩展。
- Nakash et al., 2025. AdaptiVocab: Enhancing LLM Efficiency in Focused Domains through Lightweight Vocabulary Adaptation.
面向领域的轻量词表适配。
- Goel et al., 2025. VocabTrim: Vocabulary Pruning for Efficient Speculative Decoding in LLMs.
在 speculative decoding 的 drafter 中剪枝词表。
- Kwek & Yin, 2025. COMPACT: Common-token Optimized Model Pruning Across Channels and Tokens.
同时进行 vocabulary pruning 和 FFN pruning。
- Clark et al., 2022. CANINE: Pre-training an Efficient Tokenization-Free Encoder for Language Representation.
character-level tokenizer-free encoder。
- Xue et al., 2022. ByT5: Towards a Token-Free Future with Pre-trained Byte-to-Byte Models.
byte-level encoder-decoder 模型。
- Tay et al., 2022. Charformer: Fast Character Transformers via Gradient-based Subword Tokenization.
学习 latent subword representation。
- Yu et al., 2023. MEGABYTE: Predicting Million-byte Sequences with Multiscale Transformers.
multi-scale byte-level autoregressive modeling。
- Pagnoni et al., 2024. Byte Latent Transformer: Patches Scale Better Than Tokens.
动态 byte patching,挑战 fixed tokenizer。
- Deiseroth et al., 2024. T-FREE: Subword Tokenizer-Free Generative LLMs via Sparse Representations for Memory-Efficient Embeddings.
用字符 triplet 稀疏表示替代传统 subword tokenizer。
- Liu et al., 2025. SuperBPE: Space Travel for Language Models.
允许跨空格的 superword tokenizer,提高编码效率和下游表现。
- Ali et al., 2024. Tokenizer Choice For LLM Training: Negligible or Crucial?
系统分析 tokenizer choice 对 LLM 训练、推理和下游表现的影响。