Transformer|架构演进(2):Vocab 系统(2)——Embedding、LM Head 与 Tied Embedding
阅读提示: 现在笔者要讲述第二部分,这一部分涉及到的主要内容即为Tied Embedding,并且以此来引出后续的的一些优化内容。祝食用愉快~🐑
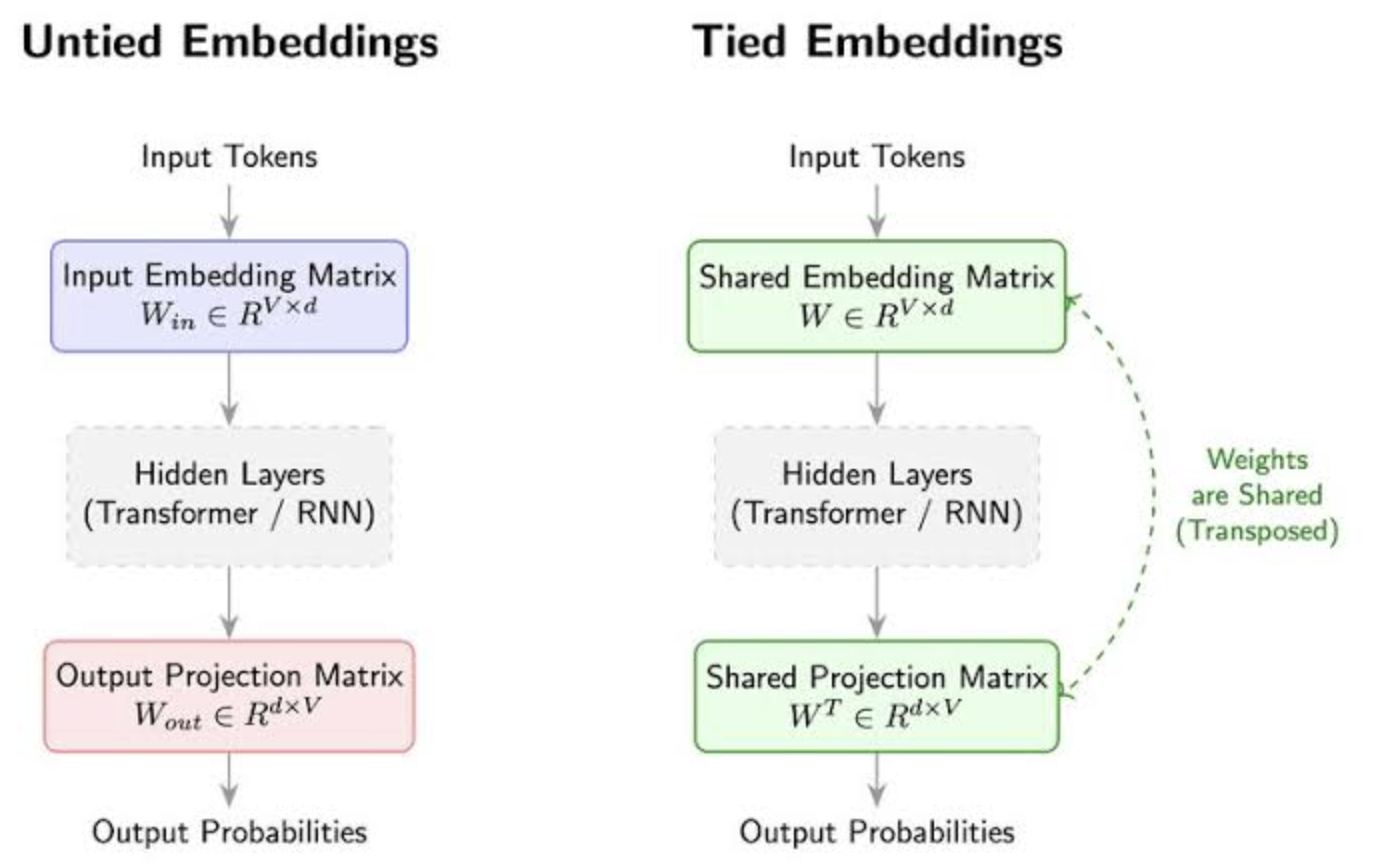
图 1 Tied Embedding
导言
“ 上一篇我们讲了 tokenizer:原始文本如何被切成 token,以及为什么 vocabulary size 会影响序列长度、上下文效率、多语言公平性和推理成本。 ”
但 tokenizer 只完成了第一步。
Tokenizer 的输出不是向量,而是一串整数 ID。比如:
"我喜欢机器学习"
→ [1024, 3567, 8910, ...]
这些整数本身没有连续空间里的几何意义。Transformer 不能直接对这些 ID 做 attention、FFN 或 normalization。模型真正处理的是向量。
所以,在 tokenizer 之后,模型需要一个 input embedding,把 token id 映射到 hidden vector。
而在模型输出时,Transformer block 得到的也是 hidden vector。为了预测下一个 token,模型还需要一个 LM Head,把 hidden vector 映射回 vocabulary 上的 logits。
于是,Vocab 系统里自然出现了两个和词表强相关的矩阵:
- Input Embedding:负责
token id → vector - LM Head / Unembedding:负责
hidden state → vocabulary logits
这两个矩阵看起来只是模型的输入层和输出层,但它们非常重要。因为它们的参数量都和 vocabulary size 成正比。
如果词表很大,它们会占据大量参数。
这就引出了一个经典问题:
“ 输入 embedding 和输出 LM Head 是否应该共享权重? ”
这就是 Tied Embedding,也叫 Weight Tying。
从 Token ID 到 Input Embedding
Tokenizer 输出的是 token id。Token id 只是一个索引,比如:
巴黎 → 12345
北京 → 67890
学习 → 54321
但模型不能把 12345 这个整数直接当作有意义的数值来处理。因为 token id 的编号本身没有语义顺序。12345 并不比 12344 更“大”,也不意味着它们语义更接近。
所以模型需要一个 embedding table。
假设:
- 词表大小是
- 模型隐藏维度是
那么 input embedding matrix 可以写成:
每个 token 对应这个矩阵中的一行。
如果 token id 是 ,那么它的 embedding 就是:
也就是取出第 行向量。
直观来说,input embedding 是一个“词表查表器”:
token id
  ↓
embedding table lookup
  ↓
token vector
例如:
12345 → [0.12, -0.53, 0.07, ..., 0.31]这个向量才是 Transformer 后续真正处理的对象。
需要注意的是,LLM 里的 embedding 通常不是静态词向量。它不是预先训练好的 Word2Vec 然后固定不动,而是和整个模型一起端到端训练出来的参数。
一开始,每个 token embedding 通常是随机初始化的。经过大规模 next-token prediction 训练后,模型逐渐学会把某些 token 放到合适的表示空间里。
比如,语义相近、上下文相似、功能相近的 token,可能会在 embedding 空间中形成某些结构。
但 input embedding 只是第一步。真正的上下文语义,要经过多层 Transformer 之后才形成。
换句话说:
“ Input embedding 提供的是 token 的初始表示;Transformer block 负责把它变成上下文化表示。 ”
从 Hidden State 到 LM Head
Decoder-only language model 的训练目标是预测下一个 token。
假设模型读入上下文:
法国的首都是经过多层 Transformer 后,最后一个位置得到一个 hidden state:
这个 hidden state 表示模型基于当前上下文形成的预测状态。
但最终模型需要输出的不是一个 hidden vector,而是整个 vocabulary 上的概率分布:
巴黎: 0.82
伦敦: 0.03
柏林: 0.02
...
为了做到这一点,模型需要一个输出矩阵。这个矩阵通常叫:
- LM Head
- Output Projection
- Unembedding matrix
如果词表大小是 ,隐藏维度是 ,那么 LM Head 可以写成:
对于每个候选 token ,都有一个输出向量 。模型计算:
其中:
- 是 token 的 logit;
- 是 token 的输出分类向量;
- 是可选 bias;
- 是当前上下文 hidden state。
然后对所有 logits 做 softmax:
这样就得到了下一个 token 的概率分布。
所以,LM Head 本质上是一个巨大的分类器:
“ 给定当前 hidden state,在整个 vocabulary 里判断下一个 token 最可能是哪一个。 ”
Input Embedding 与 LM Head
现在我们有两个矩阵。
Input embedding:
LM Head:
如果它们不共享参数,那么词表相关参数量大约是:
这个数在现代 LLM 里非常可观。
举个例子。
如果:
- vocabulary size
- hidden size
那么一个 embedding matrix 的参数量就是:
如果 input embedding 和 LM Head 各一份,就是:
这还只是词表入口和出口,不包括中间 Transformer layers。
对于 70B 级别模型,这个比例可能还能接受;但对于 0.5B、1B、3B 的小模型来说,这会非常重。
所以自然会出现一个想法:
“ 既然 input embedding 和 LM Head 都是给 vocabulary 中每个 token 分配一个向量,能不能共享同一套向量? ”
这就是 tied embedding。
Tied Embedding
“ Tied embedding 指的是:输入 embedding matrix 和输出 LM Head matrix 使用同一套参数。 ”
如果 input embedding 是:
那么输出 logits 不再使用独立的 ,而是直接使用 :
也就是说:
或者在另一种矩阵记法中:
这样,输入和输出共享一套 token vectors。
原本参数量是:
现在变成:
直接省掉一半词表相关参数。
tied embedding还有一个更深的表示假设:
“ 一个 token 被模型“读入”时的表示,和它被模型“生成”时的表示,应该处在同一个语义空间里。 ”
这句话很重要。
在 untied embedding 中,模型有两套空间:
- input embedding space:用于理解 token;
- output embedding space:用于预测 token。
在 tied embedding 中,这两个空间被强行对齐。
模型读入 “巴黎” 时用的是 ,模型想生成 “巴黎” 时,也要让 hidden state 靠近同一个 。
Tied Embedding 训练
在 tied embedding 中,模型只有一套矩阵:
它在 forward 中被用两次。
第一次,作为 input embedding:
第二次,作为 output LM Head:
所以,训练时并不是“先优化 input embedding,再优化 LM Head”,也不是“先优化 LM Head,再优化 input embedding”。
更准确地说:
“ 同一个参数矩阵 会从输入路径和输出路径同时收到梯度,两部分梯度相加后,由 optimizer 统一更新。 ”
可以写成:
这就是 tied embedding 训练的关键。
Output Path
对于某个位置 ,模型输出:
softmax 后得到概率:
真实目标 token 是 。
cross entropy loss 对 logit 的梯度是:
因为:
所以 output path 对 的梯度是:
这说明:
- 如果 是正确 token, 会被拉向当前 hidden state;
- 如果 是错误 token, 会被推离当前 hidden state。
例如:
法国 的 首都 是 → 巴黎如果模型应该生成“巴黎”,那么 output path 会让:
更靠近当前上下文 hidden state:
所以 output path 的作用是:
“ 让 token vector 学会作为输出分类原型,被正确的 hidden state 选中。 ”
Input Path
输入 token 通过 embedding table 变成向量:
这些向量进入 Transformer,影响后续 hidden states 和最终 loss。
反向传播时,loss 会经过 Transformer 传回输入 embedding。
如果 token 出现在输入位置中,那么:
这部分梯度的含义是:
“ token 作为输入时,它的向量应该如何调整,才能帮助模型更好地理解上下文、预测后续 token。 ”
例如:
巴黎 是 法国 的 首都当“巴黎”作为输入出现时,input path 会让 学会携带对后续预测有用的信息,例如地点、城市、法国相关实体等。
两种信号合并
对于任意 token ,tied embedding 的梯度可以理解为:
第一项来自 output path。
它让 学会作为输出 token,被正确 hidden state 选中。
第二项来自 input path。
它让 学会作为输入 token,帮助模型构造上下文表示。
因此,tied embedding 的训练本质是:
“ 同一个 token vector 同时接受“如何被生成”的监督和“如何被理解”的监督。 ”
训练时先后顺序
从计算图实现上看,反向传播会从 loss 开始,先经过输出层,再经过 Transformer,最后到输入 embedding。
但从优化意义上讲,并不存在“先优化输出,再优化输入”的阶段划分。
一次训练 step 的过程是:
- forward 时, 作为 input embedding 被查表使用;
- Transformer 计算 hidden states;
- 再作为 LM Head 计算 logits;
- loss 反向传播;
- output path 给 一部分梯度;
- input path 也给 一部分梯度;
- 两部分梯度相加;
- optimizer 对 做一次统一更新。
如果用 Adam,可以理解为:
然后 Adam 用总梯度 更新 。
所以 tied embedding 的关键不是训练顺序,而是:
“ 参数共享导致梯度合流。 ”
Tied Embedding 的有效性
Tied embedding 的有效性主要来自三个方面。
1. 参数效率
这是最直接的好处。
对于大词表模型,input embedding 和 LM Head 都是 。共享权重后,可以显著减少参数。
如果 很大,节省会非常明显。
这对小模型尤其重要。因为小模型总参数不多,embedding 和 LM Head 可能占据很高比例。如果不共享,模型大量参数会被词表矩阵吃掉,中间 Transformer block 的容量反而受限。
2. 表示空间对齐
语言模型的输入和输出并不是完全无关的任务。
如果一个 token 在输入中表示某个概念,那么模型在输出时也应该能生成同一个概念。
例如,“巴黎”作为输入时代表一个城市;作为输出时也代表同一个城市。
Tied embedding 强制输入空间和输出空间使用同一套 token vectors,因此可以减少两套空间之间的不一致。
这类似一种语义约束
3. 正则化
共享参数会降低模型自由度。
在小模型或数据有限的场景下,这通常是好事。它可以减少过拟合,让模型更有效地利用参数。
这也是为什么早期语言模型、机器翻译模型和很多小型 Transformer 中,weight tying 经常带来收益。
Tied Embedding 和约束
虽然 tied embedding 很优雅,但它不是所有模型都必须使用的标准答案。
它本质上是一种约束。
这个约束在小模型中可能是正则化,在大模型中也可能变成表达限制。
1. 输入角色和输出角色并不完全相同
- Input embedding 的任务是:
“ 把 token 放入上下文表示空间,让 Transformer 可以理解它。 ”
- LM Head 的任务是:
“ 把 hidden state 映射到词表分类空间,让模型可以预测下一个 token。 ”
这两个任务相关,但不完全相同。
输入侧更关注 token 如何参与上下文组合;输出侧更关注 token 如何作为一个分类目标被区分出来。
例如,一些 token 在输入中很常见,但很少作为生成目标出现;一些控制 token、格式 token、特殊符号,在输入和输出中的角色也可能不同。
如果强制共享,可能限制模型分别优化这两种角色。
2. 输出分类空间可能需要更高自由度
LM Head 是一个巨大的多分类器。
对于每个上下文 hidden state,模型要在整个 vocabulary 里做区分。输出矩阵的几何结构会直接影响分类能力。
如果 LM Head 必须等于 input embedding,那么输出分类器的向量空间就受到 input embedding 的约束。
从理论上看,标准 softmax 本身就存在表达能力限制。Yang 等人在 Breaking the Softmax Bottleneck 中从矩阵分解角度分析了 softmax-based language model 的 rank bottleneck 问题,指出低维 hidden state 到大词表分布的映射存在表达限制。
它进一步把输出分类矩阵和输入 embedding 绑定在一起,因此在高容量模型中可能限制输出层自由度。
3. 大模型不一定缺这部分参数
对于小模型,省掉 参数非常重要。
但对于几十亿、几百亿参数模型来说,embedding 多一份参数可能不是主要瓶颈。模型可能更愿意用额外参数换取更自由的输入/输出空间。
例如 Qwen2 技术报告中,小规模的 0.5B 和 1.5B 模型使用 embedding tying,而 7B、72B 和 MoE 模型不使用 embedding tying。这很典型地体现了小模型和大模型之间的取舍。
4. 多模态和特殊 token 会让输入输出更不对称
现代 LLM 不只是纯文本模型。
-
它可能包含:
- chat template token;
- tool-use token;
- function calling token;
- image placeholder token;
- audio token;
- control token;
- special routing token。
这些 token 在输入和输出中的角色未必对称。
某些 token 可能只用于输入,不应该被普通生成;某些 token 可能主要用于结构化输出;某些 multimodal token 可能根本不对应自然语言词表。
这种情况下,强行共享所有 embedding 和 LM Head 可能不再自然。
小模型更适合 Tied Embedding
小模型的核心问题是参数预算有限。
假设一个小模型:
- vocabulary size
- hidden size
单个 embedding matrix 参数量是:
如果 input embedding 和 LM Head 不共享,那么词表相关参数大约是:
对于一个 0.5B 模型来说,这已经超过一半参数。
这显然不合理。
因此,小模型更倾向 tied embedding。它可以把节省下来的参数留给 Transformer blocks,也就是 attention 和 FFN。
小模型使用 tied embedding 的收益主要包括:
- 显著减少参数;
- 降低显存占用;
- 提供正则化;
- 提高参数利用率;
- 减少词表矩阵对模型容量的挤压。
Factorized Embedding
我们知道Tied embedding 解决的是:
“ 输入和输出两套 矩阵是否应该共享? ”
但它没有解决另一个问题:
“ 每个 token 是否真的需要一个完整的 维向量? ”
这就引出了 factorized embedding。
ALBERT 提出过一个经典设计:factorized embedding parameterization。
普通 BERT 里,embedding matrix 是:
其中 是 hidden size。
ALBERT 认为,词表 embedding size 不一定要等于 hidden size。于是它把 embedding 分解成两个矩阵:
其中 。
这样参数量从:
变成:
当 很大、 很大、 较小时,参数节省非常明显。ALBERT 论文明确把这种方法作为降低 BERT 参数量的重要手段。
-
这和 tied embedding 的关系是:
- tied embedding 减少的是输入/输出两套矩阵之间的重复;
- factorized embedding 减少的是单个 embedding matrix 本身的维度成本。
它们可以看成两类不同的参数效率方法。
Factorized、Tiny Embedding 和低秩输出层
继续往下看,factorized embedding 本质上是在问:
“ token 的词表表示空间是否需要和模型 hidden space 一样大? ”
普通模型默认:
也就是每个 token 直接拥有一个 维向量。
Factorized embedding 则设:
先把 token 映射到较小的 lexical space,再投影到模型 hidden space。
这其实和未来的 tiny embedding、low-rank embedding 有很强关联。
可以把它们放在一起看:
- Tied Embedding
输入和输出共享同一套词表向量,减少重复。
- Factorized Embedding
把 分解成 和 ,降低单个矩阵成本。
- Low-rank LM Head
输出矩阵也可以被看成低秩分解,减少 的参数与计算压力。
- Tiny Embedding
更进一步,尝试用更小的 token representation 表达大词表,尤其适合端侧模型和小语言模型。
- Adaptive Embedding
根据 token 频率分配不同表示容量,高频 token 给更多维度,低频 token 给更少维度。
小结
- tied embedding 的本质是一个表示空间设计问题:
“ token 的“读入表示”和“生成表示”,应该是同一个向量,还是两个不同角色的向量? ”
这个问题连接了 Vocab 系统中的多个方向:
- tokenizer 越大,embedding 越重;
- 小模型越小,weight tying 越重要;
- 大模型越大,表达自由度越重要;
- factorized embedding 和 tiny embedding 继续压缩词表表示;
- output softmax 和 LM Head 优化继续影响推理效率。
参考文献
- Hakan Inan, Khashayar Khosravi, Richard Socher. Tying Word Vectors and Word Classifiers: A Loss Framework for Language Modeling. ICLR 2017.
- Ofir Press, Lior Wolf. Using the Output Embedding to Improve Language Models. EACL 2017.
- Ashish Vaswani et al. Attention Is All You Need. NeurIPS 2017.
原始 Transformer 中也讨论了 embedding 与 pre-softmax linear transformation 的权重共享。
- Zhenzhong Lan et al. ALBERT: A Lite BERT for Self-supervised Learning of Language Representations. 2019.
提出 factorized embedding parameterization。
- Zhilin Yang, Zihang Dai, Ruslan Salakhutdinov, William W. Cohen. Breaking the Softmax Bottleneck: A High-Rank RNN Language Model. ICLR 2018.
从矩阵分解角度分析 softmax-based language model 的表达限制。
- Qwen Team. Qwen2 Technical Report. 2024.
报告中给出了不同规模模型是否使用 embedding tying 的配置。