Transformer|架构演进(1):Vocab 系统(1)——Tokenizer 与 Vocabulary Size
阅读提示: 这一篇是关于vocab系统的,笔者将会按照自己的节奏开始我们的架构介绍。这一部分不需要太多的背景知识,大可以按照自己的想法按需阅读。祝食用愉快~😁
导言
“ 在介绍 Transformer 架构演进时,我们往往会很快进入 Attention、FFN、RoPE、MoE、RMSNorm 这些模块。但在所有这些模块之前,还有一个更基础的问题: ”
图 1 分词类型一览
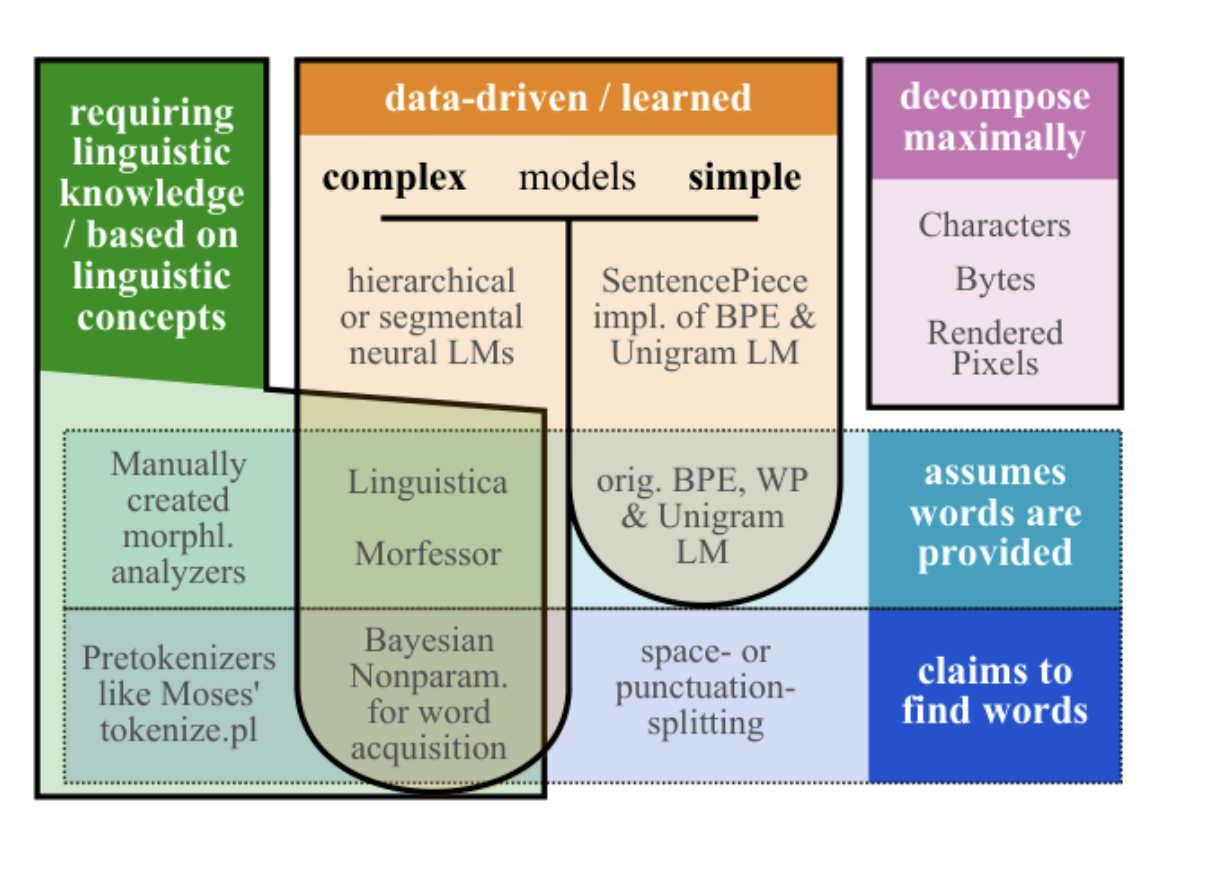
文本到底是如何进入模型的?
大语言模型并不能直接处理自然语言字符串。对模型来说,原始文本首先需要被切分成 token,再被映射成 token id,然后通过 embedding table 变成向量,最后才会进入 Transformer block。
也就是说,模型看到的并不是“我喜欢机器学习”这几个字本身,而是一串 token id。之后,这些 token id 会被转换成向量,进入模型内部进行计算。模型输出时,也不是直接吐出自然语言,而是先在整个词表上预测下一个 token 的概率,再把 token id 还原成文本。
这个过程可以简化成:
Raw Text
  ↓
Tokenizer
  ↓
Token IDs
  ↓
Input Embedding
  ↓
Transformer Backbone
  ↓
LM Head
  ↓
Vocabulary Distribution
  ↓
Next Token
所以,Vocab 系统并不是一个孤立的小模块。它是自然语言和 Transformer 之间的接口层:一头连接文本世界,一头连接模型的向量空间。
这也是为什么我把这个主题称为 Vocab 系统,而不只是 Vocab Embedding。因为它至少包含四个紧密相关的部分:Tokenizer、Vocabulary、Input Embedding 和 LM Head。
为什么 Vocab 系统要拆成三部分讲?
“ Vocab 系统看起来简单,但它牵涉的问题很多。如果一篇文章里同时讲 tokenizer、embedding、LM Head、tied embedding、adaptive softmax、tokenizer-free,很容易变成概念堆砌。 ”
所以我会把它拆成三篇。
第一部分:Tokenizer 与 Vocabulary Size
第一篇,也就是本文,主要回答一个问题:
模型应该用什么基本单位来阅读文本?
比如一个词:
“unbelievable”
可以被切成完整词,也可以被切成 “un + believe + able”,还可以进一步拆成更小的字符或 byte。不同切法会带来不同的 token 数量,也会影响上下文长度、推理成本、多语言表现和训练效率。
-
这部分重点讲:
- 为什么需要 tokenizer;
- word-level、character-level、subword-level 的取舍;
- BPE、WordPiece、Unigram、SentencePiece、Byte-level BPE 的演进;
- 为什么现代 LLM 的 vocab 越来越大;
- vocab size 为什么也开始成为 scaling law 的一部分。
也就是文本如何被压缩成 token 序列。
第二部分:Embedding、LM Head 与 Tied Embedding
“ 当 tokenizer 已经把文本变成 token id 之后,模型仍然不能直接处理这些整数。它需要 input embedding 把 token id 变成向量。 ”
而模型输出时,也需要 LM Head 把 hidden state 映射回词表概率。
-
这里就出现了两个矩阵:
- Input Embedding:负责 token id 到向量;
- LM Head:负责 hidden state 到 vocabulary logits。
这两个矩阵都和词表大小有关。如果词表很大,它们会占用大量参数。于是就产生了一个经典问题:
输入 embedding 和输出 LM Head 是否应该共享权重?
这就是 tied embedding。
第二篇会重点讲:
- input embedding 是什么;
- LM Head 为什么本质上是一个词表分类器;
- tied embedding 的思想;
- 为什么小模型更适合 tied embedding;
- 为什么大模型不一定使用 tied embedding;
- factorized embedding、tiny embedding 和低秩 embedding 的关联。
即token 如何进入模型,又如何从模型输出。
第三部分:高效词表、词表适配与 Tokenizer-free
“ 前两篇默认我们使用一个固定词表。但固定词表本身也有局限。 ”
-
比如:
- 大词表会让 embedding 和 LM Head 变重;
- 小词表会让 token 序列变长;
- 英语中心 tokenizer 对其他语言可能不公平;
- 领域专有词可能被切得很碎;
- 代码、数学、工具调用格式对 tokenizer 有特殊要求;
- fixed tokenizer 很难适应新领域和新模态。
-
于是就有了后续方向:
- adaptive softmax;
- adaptive input representation;
- vocabulary expansion;
- vocabulary pruning;
- tokenizer-free;
- byte-level modeling;
- dynamic patching。
即当固定词表系统不够高效、不够灵活时,我们应该压缩它、适配它,还是替代它?
三篇文章的逻辑顺序
这三部分的顺序,其实就是文本在模型中的自然流动顺序:
本文先从第一步开始:Tokenizer 与 Vocabulary Size。
Tokenizer 不是简单预处理
“ 很多人第一次接触 tokenizer 时,会把它理解成一个普通预处理步骤。好像只要把文本切成 token,再映射成 id,就完成了,对吧?💨 ”
但在现代大模型中,tokenizer 远不只是预处理。它会直接决定两个关键变量:
- Vocabulary size,也就是词表大小,记作 V;
- Tokenized sequence length,也就是切分后的序列长度,记作 T。
这两个变量非常重要。
词表大小 V 决定了 embedding table 和 LM Head 的参数量。序列长度 T 则决定了 attention 计算成本、KV cache 大小、上下文窗口利用率和生成时的 decode 步数。
举个例子,假设模型要处理一句话:
“internationalization is difficult”
- 如果 tokenizer 把 “internationalization” 切成多个子词,那么序列会变长。序列变长意味着 attention 计算更多,KV cache 更大,同样上下文窗口能装下的原始文本更少。
- 如果 tokenizer 词表更大,能把 “internationalization” 作为一个 token,序列就会变短。但代价是词表更大,embedding 和 LM Head 也更大。
所以 tokenizer 的核心不只是“怎么分词”这么简单,而在做一个压缩权衡:
用有限的词表,把无限多样的文本压缩成模型可以处理的 token 序列。
这个压缩做得好,模型训练和推理都会更高效;做得不好,模型可能会浪费大量上下文和计算在碎片化 token 上。
从 word 到 subword:Tokenizer 的早期演进
“ 理解现代 tokenizer,最好从最朴素的方法开始。 ”
1. Word-level tokenizer
最自然的想法是按词切分。
比如:
“I love machine learning”
可以切成:
“I / love / machine / learning”
这种方式非常直观。每个 token 接近一个自然语言里的词,序列长度也比较短。
但它有一个致命问题:语言是开放的,词表不可能覆盖所有词。
现实文本里会不断出现新词、人名、地名、产品名、代码符号、学术术语和领域专有名词。比如 “ChatGPT”“BRCA1”“Lothlorien”“transformerization”,这些词如果不在词表里,就会变成 unknown token,也就是 OOV。
在早期神经机器翻译中,OOV 是一个非常严重的问题。机器翻译经常遇到罕见词、人名、地名、复合词,如果模型无法表示这些词,就很难翻译准确。
所以 word-level tokenizer 虽然语义单位完整,但词表会变得极大,而且无法处理开放词表问题。
2. Character-level tokenizer
另一个极端是按字符切分。
这样做几乎没有 OOV。任何词都可以拆成字符序列。
比如:
“unbelievable”
可以拆成:
“u / n / b / e / l / i / e / v / a / b / l / e”
这样确实解决了 OOV 问题,但代价是序列太长,而且每个 token 的语义太弱。
对于 Transformer 来说,序列长度非常关键。因为标准 self-attention 的计算复杂度和序列长度的平方相关。字符级 tokenization 会显著拉长序列,从而增加训练和推理成本。
所以 character-level tokenizer 虽然开放,但效率不高。
3. Subword tokenizer
于是,一个自然的折中方案出现了:subword tokenization。
它的思想是:
常见词可以作为完整 token,罕见词可以拆成更小的子词。
比如:
“unbelievable”
可以被切成:
“un / believe / able”
这样,如果模型没见过完整的 “unbelievable”,仍然可以通过 “un”“believe”“able” 这些子词组合出它。
这正好平衡了 word-level 和 character-level 的缺点:
- 比 word-level 更开放,不容易 OOV;
- 比 character-level 更短,效率更高;
- 对复合词、派生词、罕见词更友好。
“ 现代 LLM 的 tokenizer,大多数都是 subword tokenizer 的变体。 ”
BPE、WordPiece、SentencePiece:经典 tokenizer 方法如何变化?
“ Subword tokenization 不是一个单一方法,而是一类方法。这里最经典的有 BPE、WordPiece、Unigram LM 和 SentencePiece。 ”
它们的共同目标是:在有限词表下,找到一种合适的文本切分方式。
但它们的出发点和工程风格略有不同。
BPE:从字符开始,反复合并最高频组合
“ BPE,全称 Byte Pair Encoding,最初是一种数据压缩算法,后来被引入神经机器翻译,用来解决 rare words 和 open vocabulary 问题。 ”
它的核心思想非常简单:
“ 从最小单位开始,不断把语料中最常一起出现的相邻 token 合并成新的 token。 ”
一开始,所有词都被拆成字符。例如:
low     → l o w
lower   → l o w e r
lowest  → l o w e s t
然后统计所有相邻 pair 的出现频率。
如果 l + o 出现最多,就合并成:
lo于是:
low     → lo w
lower   → lo w e r
lowest  → lo w e s t
接着继续统计。如果 lo + w 出现最多,就合并成:
low于是:
low     → low
lower   → low e r
lowest  → low e s t
这个过程不断重复,直到词表达到设定大小。
BPE 的直觉是:如果两个片段经常一起出现,就把它们压缩成一个更大的单位。这样,常见词或常见词片段会逐渐变成完整 token,而罕见词仍然可以退回到更小的子词甚至字符。
BPE 的优点是简单、稳定、工程实现成熟,也非常适合大规模语料。它解决了 word-level tokenizer 的 OOV 问题,同时比 character-level tokenizer 更短、更高效。
但 BPE 也有明显局限。它主要依赖频率统计,不一定符合真正的词法、语义或形态学边界。比如它可能把一个词拆在很奇怪的位置,只因为某些字符组合在训练语料中频繁出现。对于多语言、低资源语言、代码和特殊符号,BPE 的表现很依赖训练语料和预处理方式。
“ BPE 是一种“从小到大”的合并算法:谁最常一起出现,就先合并谁。 ”
WordPiece:不只看频率,而是看“合并后是否更值得”
“ WordPiece 和 BPE 很相似,也是一种从小单位逐步构造子词词表的方法。它同样从字符或基础符号开始,然后不断合并成更大的 subword。 ”
但 WordPiece 和 BPE 的关键区别在于:BPE 通常优先合并出现频率最高的相邻 pair,而 WordPiece 更关心某个合并是否能让语料被当前词表更好地解释。
换句话说,BPE 问的是:
“ 哪两个片段最常一起出现? ”
而 WordPiece 更像是在问:
“ 合并哪两个片段,最能提升语言模型对语料的建模能力? ”
一个简单例子可以帮助理解。
假设有两个候选 pair:
t + h
e + r
如果 t + h 出现次数比 e + r 更多,BPE 可能会优先合并 t + h。但 WordPiece 不一定只看出现次数。它还会考虑 t、h、e、r 本身的频率。如果 t 和 h 各自本来就非常常见,那么 t + h 频繁出现并不一定说明它们是一个特别有信息量的组合。相反,如果 e + r 虽然出现次数略少,但 r 很多时候都跟在 e 后面,那么 er 这个组合可能更值得合并。
所以,WordPiece 更偏向选择那些“组合关系强”的 subword,而不只是最高频 pair。
在 BERT 中,WordPiece 的输出形式很典型。比如:
playing可能被切成:
play ##ing其中 ##ing 表示它不是一个词开头,而是接在前面 token 后面的词内部子词。
再比如:
unaffable可能被切成:
un ##aff ##able这种表示方式让模型知道哪些 token 是词首,哪些 token 是词内部片段。
WordPiece 的优点是:相比纯频率合并,它更强调子词组合对语料建模的贡献,因此在 BERT 这类预训练模型中非常经典。它同样能缓解 OOV,也能保持相对较短的序列长度。
但它也仍然是 fixed tokenizer。它的词表一旦训练完成,后续切分方式就固定了。对于多语言、低资源语言、代码和新领域文本,如果训练语料覆盖不足,仍然可能出现切分不理想的问题。
“ WordPiece 也是“从小到大”构造子词,但它不只是看谁出现最多,而是看合并谁更有助于解释语料。 ”
Unigram LM:先准备大量候选,再删掉不重要的子词
Unigram LM 和 BPE、WordPiece 的思路明显不同。
BPE 和 WordPiece 都是从小单位开始,不断合并成更大的单位。它们是“加法式”的。
Unigram LM 则更像是“减法式”的:
“ 先准备一个较大的候选子词词表,然后不断删除对语料解释贡献较小的 token,最后留下目标大小的词表。 ”
比如,对于一个词:
unbelievable候选词表里可能同时存在:
u
n
un
believe
able
believable
unbelievable
这意味着同一个词可以有多种切法:
un + believe + able
un + believable
unbelievable
u + n + believe + able
Unigram LM 会给每个 subword 一个概率,并认为一句话的概率由它的 subword 切分共同决定。对于同一句话,不同切分方式会有不同概率。
训练时,它会估计哪些 subword 更常被用于解释语料,哪些 subword 很少起作用。那些对整体语料 likelihood 贡献较小的 token,就会被逐步删除。
所以 Unigram LM 的流程大致是:
补充:Unigram LM 完整流程(选择性阅读)
在此感谢提出疑问的读者,帮助我完善了blog内容
第一步:初始化词表:把语料中所有可能的字符和字符组合都列出来,得到一个很大的候选词表 ,并给每个 subword 赋一个初始概率 。
第二步:用 EM 学概率:我们希望模型对语料的解释能力越强越好,也就是最大化语料的 log likelihood:
一个句子可以有很多种切法。每种切法 的概率是其中所有 subword 概率的乘积:
句子的概率是所有切法的概率之和:
切法是一个隐变量,我们不知道一个句子“正确”的切法是什么。所以对所有可能的切法求和,把隐变量边缘化掉。Unigram LM 假设每个 subword 是独立生成的,所以一种切法的概率就是各 subword 概率的乘积。这也是模型名字“Unigram”的由来。
解释: 要估计 ,我们需要知道每个 subword 被用了多少次;但被用了多少次取决于怎么切词,怎么切词又取决于 。这是一个相互依赖的问题,所以用 EM 来迭代求解。
E-step:算期望计数:固定当前的 ,对每个句子,按每种切法的概率占比作为权重,计算每个 subword 的期望出现次数:
直观来说:概率高的切法权重大, 在这些切法里出现得越多,期望计数就越高。
M-step:更新概率,用期望计数归一化: E-step 和 M-step 交替进行,直到概率收敛。
对这里为什么收敛有兴趣的可以看数学算法的一篇blog,6-8号的Transformer算法|架构演进(拓展):Vocab 系统——Unigram LM的subword概率收敛证明
第三步:计算每个 subword 的重要性:EM 收敛后,我们得到了每个 subword 的 和 。直觉是:删掉某个 subword 后,语料的 log likelihood 掉得越少,说明它越不重要。
EM 收敛后,对每个句子,概率最高的那种切法会占主导: 所以 log likelihood 近似为: 从按句子遍历变成按 subword 遍历,对每个 subword ,它在整个语料所有句子的最优切法里出现了 次:
删掉 之后损失多少? 在这个近似下, 对 的贡献是 ,所以删掉 造成的损失近似为: 其中: 两者相乘,就是 对整个语料 likelihood 的总贡献。
第四步:删除不重要的 subword
按重要性从小到大排序,删掉贡献最低的一批(比如 20%)。
有两个约束:
- 单个字符不能删,保证任何词都能被切出来
- 每次删一批而不是一个,因为删掉一批后其他 subword 的概率会变,需要重新跑 EM
第五步:重复,直到词表够小。
回到讨论,它和 BPE 最大的不同是:BPE 通常会给一个文本确定性切分,而 Unigram LM 天然允许多种切分。
这一点非常重要,因为它带来了 subword regularization。
在训练模型时,我们不一定每次都使用同一种切分,而可以从多种可能切分中采样。例如:
internationalization这一次可以切成:
international + ization下一次可以切成:
inter + national + ization这种随机切分相当于一种数据增强。它可以减少模型对某一种固定切分方式的过拟合,让模型对词形变化、低资源语言和跨领域文本更鲁棒。
Unigram LM 的优点是概率解释更自然,也更适合 subword sampling。它的问题是训练过程比 BPE 更复杂,而且最终效果仍然依赖候选词表和训练语料。
“ Unigram LM 是先给出很多可能的子词,再逐步删除不重要的,保留最能解释语料的一组。 ”
SentencePiece:让 tokenizer 直接处理 raw text
“ SentencePiece 容易和 Unigram LM 混在一起,但严格来说它们不是一回事。 ”
Unigram LM 是一种 subword segmentation 算法。
SentencePiece 更像是一个 tokenizer 框架或工具。它支持 BPE,也支持 Unigram LM。只是很多模型在说使用 SentencePiece 时,常常指的是使用 SentencePiece 中的 Unigram 模型。
SentencePiece 的关键贡献是:
“ 它可以直接从 raw text 训练 tokenizer,不要求先用语言特定的分词器做预处理。 ”
这点对多语言尤其重要。
英语文本天然有空格,可以比较容易地先按空格分词。但中文、日文、泰文等语言没有类似的显式空格边界。如果 tokenizer 强依赖预分词,就需要为不同语言设计不同的预处理流程。
SentencePiece 的做法是把输入文本看成普通字符序列,连空格也作为一种符号来处理。它常用特殊符号 ▁ 表示空格或词边界。
例如:
Hello world可能被表示成:
▁Hello ▁world这里的 ▁ 表示前面有一个空格或词边界。
这样做的好处是 tokenizer 和 detokenizer 可以更稳定地互相转换,也更容易统一处理不同语言。
SentencePiece 的优点包括:
- 可以直接处理 raw text;
- 不强依赖语言特定分词器;
- 对中文、日文等无空格语言更友好;
- 支持 BPE 和 Unigram LM;
- 适合多语言预训练模型。
因此,SentencePiece 被很多多语言模型和开源 LLM 使用,比如 T5、mT5、LLaMA 系列的一些版本等。
但 SentencePiece 本身不是某个具体切分算法。它更像是一个“把 subword tokenizer 工程化、语言无关化”的工具框架。
“ SentencePiece 的核心价值是让 subword tokenizer 可以直接从 raw text 学习,并更好地服务多语言场景。 ”
四种方法的关系
-
这几种方法可以按思路分成两类。
- BPE 和 WordPiece 都是“从小到大”的方法。它们从字符或基础符号开始,通过不断合并构造更大的 subword。BPE 更强调频率,WordPiece 更强调合并后对语料建模的收益。
- Unigram LM 则是“从大到小”的方法。它先准备大量候选子词,再通过概率模型删除不重要的 token,最后得到一个紧凑词表。它的优势是天然支持多种切分方式,因此适合 subword regularization。
- SentencePiece 则更偏工程框架。它让 BPE 或 Unigram LM 可以直接运行在 raw text 上,不强依赖语言特定预分词,因此非常适合多语言和无空格语言。
| 方法 | 核心思想 | 构造方式 | 典型特点 |
|---|---|---|---|
| BPE | 合并最高频相邻 pair | 从小到大合并 | 简单稳定,工程成熟 |
| WordPiece | 合并最有利于语料建模的 pair | 从小到大合并 | BERT 经典 tokenizer |
| Unigram LM | 保留最能解释语料的子词 | 从大候选集删减 | 支持多切分和采样 |
| SentencePiece | 从 raw text 训练 tokenizer | 工具框架 | 语言无关,多语言友好 |
“ BPE 解决了 rare words 的开放词表问题;WordPiece 让 subword 成为 BERT 时代预训练模型的标准输入;Unigram LM 引入了概率化切分和 subword regularization;SentencePiece 则把这些方法推广到 raw text 和多语言场景。 ”
Byte-level BPE:现代开放域 LLM 的实用选择
“ 随着模型从传统 NLP 任务走向开放域大模型,输入文本变得越来越复杂。 ”
现代 LLM 不只需要处理普通自然语言,还要处理代码、emoji、URL、Markdown、JSON、数学公式、罕见 Unicode 符号、工具调用格式,以及多语言混合文本。
这时,基于字符或语言规则的 tokenizer 会面临很大的覆盖压力。
Byte-level BPE 的思路是:不从 Unicode 字符开始,而是从 UTF-8 byte 开始。UTF-8 byte 的基础集合只有 256 个,因此任何文本最终都可以被表示成 byte 序列。
这带来一个很大的好处:
几乎没有真正意义上的 OOV。
GPT-2 使用 byte-level BPE,词表大小为 50,257。Qwen 系列也使用 UTF-8 byte-level BPE,以保证任意文本都可以被编码。
Byte-level BPE 非常适合开放域 LLM,因为它对代码、符号、emoji、多语言混排都更加统一。
但它也不是完美方案。原始 byte 序列很长,需要通过 BPE merge 来压缩;而 merge 仍然主要由频率驱动,有时会产生不符合人类直觉的 token。不同语言之间仍然可能存在 tokenization efficiency 差异。
所以 Byte-level BPE 的定位不算是“终极方案”,只是现代 LLM 在通用性、鲁棒性和工程可用性之间的一个强折中。
为什么现代 LLM 的词表越来越大?
“ 让我们抽离历史的vocab的思考,关注几个现实状况:早期模型的词表通常在 30K 到 50K 左右。比如 BERT 大约 30K WordPiece,GPT-2 是 50,257 byte-level BPE,LLaMA 2 使用 32K SentencePiece。 ”
-
但近几年的模型开始明显使用更大的词表。
- LLaMA 3 使用 128K vocabulary tokenizer,并且官方提到,相比 LLaMA 2 tokenizer,它能带来更高 token efficiency,最多减少约 15% token 数。
- Qwen2 使用约 151K 的 byte-level BPE 词表。
- Gemma 3 使用 Gemini 2.0 的 262K SentencePiece tokenizer,并强调对非英语语言更均衡。
- Mistral 的 Tekken tokenizer 也使用约 131K vocabulary。
Q:为什么会出现这个趋势?
核心原因是:大词表可以减少 token 数。
如果一个 tokenizer 词表太小,很多常见词、代码片段、数字格式、多语言片段都会被拆成多个 token。这样模型虽然词表参数少了,但序列变长了。
-
序列变长会带来很多代价:
- 同样上下文窗口能放下的原始文本更少;
- attention 计算成本更高;
- KV cache 更大;
- prefill 更慢;
- 生成同样内容需要更多 decode steps;
- 多语言和代码任务更容易被碎片化表示拖累。
大词表则可以把更多常见片段压缩成单个 token,从而提升 token efficiency。
-
但大词表也有明显代价:
- input embedding 更大;
- LM Head 更大;
- softmax 输出维度更高;
- 稀有 token 可能训练不足;
- 小模型中词表参数占比会很高。
所以,词表不是越大越好。合理的 vocab size 取决于模型规模、训练数据、语言分布、上下文长度、代码比例和部署成本。
对于小模型,过大的词表可能让 embedding 和 LM Head 占掉太多参数预算。对于大模型,词表参数占比相对下降,token efficiency 的收益会更明显。
这也是为什么小模型和大模型的 tokenizer / embedding 策略可能不同。
Vocab Size 也许正在成为 Scaling Law 的一部分
“ Vocab Size的逐渐变大的趋势也许也反映了它在大模型优化的部分占的比重也在增大,举个例子。过去我们讨论 scaling law,主要关注三个变量:模型参数量、训练数据量和计算量。 ”
但现在,vocabulary size 也开始被纳入 scaling law 的视角。
Tao 等人在 2024 年的 Scaling Laws with Vocabulary: Larger Models Deserve Larger Vocabularies 中系统研究了 vocab size 和模型规模之间的关系。他们训练了从 33M 到 3B 的模型,并提出:更大的模型通常应该配更大的 vocabulary。他们甚至预测 LLaMA2-70B 的 optimal vocabulary size 至少应该达到 216K,而不是原来的 32K。
这个结论很有启发。
它说明,vocab size 不应该只是一个沿用默认值的工程超参数,而应该和 model size、data size、compute budget 一起设计。
未来设计大模型时,我们可能不只问:
模型多大?数据多少?上下文多长?
还要问:
词表多大?这个词表对哪些语言高效?对代码是否友好?对目标领域是否合适?它和模型规模是否匹配?
这代表 tokenizer 从“预处理工具”变成了“架构设计变量”。
Tokenizer Choice 会影响模型能力吗?
“ 所以我们发现了vocab size的影响力确实很大,此时我们选择的分词方式也是跳脱出来成为一个无法避免的事情。一个自然的问题是:不同 tokenizer 的影响真的有那么大吗? ”
过去很多人可能会觉得,BPE、SentencePiece、WordPiece 都差不多,只要能把文本切成 token 就可以。
但最近的研究表明,tokenizer choice 会显著影响模型的下游表现、训练成本和推理成本。
Ali 等人在 2024 年的 Tokenizer Choice For LLM Training: Negligible or Crucial? 中训练了 24 个 2.6B 规模的单语和多语语言模型,系统比较不同 tokenizer 的影响。结果显示,tokenizer choice 会影响模型 downstream performance,也会影响训练和推理成本。
更重要的是,这篇论文指出,常见的 tokenizer 指标,比如 fertility 和 parity,并不总能可靠预测最终下游表现。也就是说,一个 tokenizer 看起来压缩率不错,不代表它一定能让模型表现更好。
他们还发现,英语中心 tokenizer 用于多语言模型时,可能造成明显性能下降,并因为低效 tokenization 带来最高 68% 的额外训练成本。
这说明一个很重要的事实:
Tokenizer 不只是决定文本怎么切,它会影响模型最终学到什么、学得多快,以及推理有多贵。
从多语言和长上下文看 tokenizer 的真实影响
“ 我们说vocab size和tokenizer chioces的影响不断变大,但是这个影响在什么样的现实场景中更加显著呢?可以发觉,Tokenizer 的影响在多语言和长上下文场景中尤其明显。 ”
假设一个模型支持 128K tokens 的上下文。表面上看,每种语言都有 128K tokens 可用。但如果 tokenizer 对英语很高效,对某些低资源语言很低效,那么同样 128K tokens,能装下的原始信息量是不一样的。
对英语来说,128K tokens 可能能放下很长的文档。对另一些语言,如果一句话被切得更碎,同样的上下文窗口能放下的内容就更少。
- 这会带来三个问题。
- 第一,训练成本不公平。低效 tokenization 会让某些语言需要更多 token 才能表达同样信息。
- 第二,上下文利用率不公平。同样的 context length,对不同语言实际承载的信息量不同。
- 第三,推理成本不公平。按 token 计费或按 token 计算延迟时,不同语言用户的实际成本可能不同。
“ 这也是为什么现代多语言模型越来越重视 tokenizer balance。Gemma 3 使用更大的 262K tokenizer,并强调对非英语语言更加均衡,就是这种趋势的体现。 ”
代码场景也类似。代码中有大量符号、缩进、括号、变量名、API 名称。如果 tokenizer 对代码不友好,同样一段代码会被切成更多 token,不仅浪费上下文,也可能影响模型学习代码结构。
所以,tokenizer 的设计已经和长上下文、多语言、代码模型、agent 工具调用密切相关。
Tokenizer 的未来会走向哪里?
“ 从目前趋势看,我认为 Vocab / Tokenizer 方向有几个值得关注的发展点。 ”
1. Vocab size 会和模型规模共同设计
未来不应该默认使用 32K、50K 或 100K 词表,而应该根据模型规模、训练数据、语言分布、代码比例和部署场景来选择 vocab size。
小模型可能需要更谨慎地控制词表大小,因为 embedding 和 LM Head 占比高。大模型则可能更适合大词表,因为它能更好地消化大 vocab,并从 token efficiency 中获益。
2. 多语言 tokenizer 会越来越重要
只对英语高效的 tokenizer,在全球化 LLM 中会带来隐性不公平。未来 tokenizer 设计会越来越关注不同语言之间的压缩率、覆盖率和表示质量。
这不仅是性能问题,也是成本问题。因为 tokenization efficiency 会直接影响训练 token 数、推理 token 数和用户使用成本。
3. 代码和结构化文本会改变 tokenizer 设计
现代 LLM 不只是聊天模型,还要写代码、读 JSON、调用工具、处理 Markdown、生成 SQL、理解 LaTeX。代码和结构化文本有大量符号、缩进、括号和命名模式,和普通自然语言很不一样。
因此,未来 tokenizer 可能会更显式地考虑代码、数字、数学和工具调用格式。
4. Fixed tokenizer 仍是主流,但不是终点
当前主流 LLM 仍然使用固定 subword tokenizer,因为它成熟、稳定、高效,和现有训练系统兼容。
但 fixed tokenizer 也有根本限制:它在训练前就固定了文本切分方式,无法根据上下文动态调整粒度,也很难完美适配所有语言和领域。
所以 tokenizer-free、byte-level modeling 和 dynamic patching 会继续发展。CANINE、ByT5、Charformer、MEGABYTE、BLT 都是在探索这个方向。尤其是 BLT 这类 byte-level dynamic patching 方法,试图让模型直接处理 bytes,并根据输入复杂度动态形成 patch,从而摆脱固定词表。
不过,tokenizer-free 目前还没有完全取代 fixed tokenizer。它仍然要解决序列过长、训练成本、推理效率和系统兼容性问题。
所以短期看,固定 subword tokenizer 仍然是主流;长期看,动态、可学习、byte-level 的 tokenizer-free 方向值得持续关注。
小结
总结到这里,我们可以给 tokenizer 一个更准确的定位:
Tokenizer 是大模型的语言压缩器。
-
它不是简单地把文本切开,而是在多个目标之间做权衡:
- 词表大小不能太大,否则 embedding 和 LM Head 太重;
- 序列长度不能太长,否则 attention 和 KV cache 成本太高;
- 不能有严重 OOV,否则开放文本无法处理;
- 多语言要尽量公平;
- 代码、数学、符号和结构化文本要能高效表示;
- 上下文窗口要被充分利用;
- 训练和推理成本要可控。
-
从历史上看,tokenizer 的演进经历了一个清晰过程:
- 最早的 word-level tokenizer 语义完整,但 OOV 严重。
- Character-level tokenizer 没有 OOV,但序列过长。
- Subword tokenizer 在两者之间折中,于是 BPE、WordPiece、Unigram、SentencePiece 成为神经 NLP 和预训练模型的基础。
- 到了开放域 LLM 阶段,Byte-level BPE 进一步解决任意 Unicode 文本和复杂符号输入的问题。
- 最近,随着模型规模扩大和多语言需求增强,vocab size 又开始变大,并逐渐成为 scaling law 的一个变量。
所以,过去 tokenizer 是 NLP pipeline 的预处理步骤;今天 tokenizer 已经是 LLM 架构设计的一部分。
笔者的话
“ 第一篇,一个好的开头,vocab的梳理让人视野更加开阔了,呼呼~😊 ”
参考文献与延伸阅读
- Sennrich, Rico, Barry Haddow, and Alexandra Birch. 2016. Neural Machine Translation of Rare Words with Subword Units.
BPE 引入神经机器翻译,用 subword 处理 rare words 和 open vocabulary。1
- Wu, Yonghui et al. 2016. Google’s Neural Machine Translation System: Bridging the Gap between Human and Machine Translation.
GNMT 使用 wordpieces 处理 rare words。1
- Kudo, Taku. 2018. Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates.
提出 subword regularization 和 Unigram LM segmentation。2
- Kudo, Taku, and John Richardson. 2018. SentencePiece: A Simple and Language Independent Subword Tokenizer and Detokenizer.
提出 language-independent tokenizer,可以直接从 raw text 训练。2
- Radford, Alec et al. 2019. Language Models are Unsupervised Multitask Learners.
GPT-2 使用 byte-level BPE,词表大小 50,257。1
- Meta AI. 2024. Introducing Meta Llama 3.
LLaMA 3 使用 128K vocabulary tokenizer,并提升 token efficiency。4
- Qwen Team. 2024. Qwen2 Technical Report.
Qwen2 使用 byte-level BPE,词表约 151K。#link(“https://arxiv.org/html/2407.10671v4”)[1]
- Google. 2025. Gemma 3 Technical Report.
Gemma 3 使用 Gemini 2.0 的 SentencePiece tokenizer,词表约 262K,更强调非英语语言平衡。4
- Ali, Mehdi et al. 2024. Tokenizer Choice For LLM Training: Negligible or Crucial?
系统研究 tokenizer choice 对 LLM 下游性能、训练成本和推理成本的影响。3
- Tao, Chaofan et al. 2024. Scaling Laws with Vocabulary: Larger Models Deserve Larger Vocabularies.
将 vocabulary size 纳入 scaling law,提出更大模型需要更大词表。1
- Pagnoni, Artidoro et al. 2024. Byte Latent Transformer: Patches Scale Better Than Tokens.
探索 byte-level dynamic patching 和 tokenizer-free 方向。1