CS336(2025)|Assignment 1:Transformer 架构测试实验
阅读提示: 这里是笔者对于cs336第一部分作业的实验部分的总结报告,主要聚焦于Transformer的架构,会对实验结果做分析,包含baseline,LR sweep,batch sweep ,ablation分析。祝食用愉快~🧪
1. 实验内容概览
本次 Assignment 1 的实验可以分成两条主线:
- TinyStories 实验线
使用 TinyStories 数据训练 10K byte-level BPE tokenizer,并训练一个小型 Transformer 语言模型。TinyStories 数据更干净、句式简单、主题集中,因此适合作为 pipeline 验证和小模型 baseline。
- OpenWebText 实验线
使用 OpenWebText 训练 32K BPE tokenizer,并在同样模型规模和训练 token budget 下训练语言模型。OpenWebText 更接近真实网页文本,主题复杂、噪声更多、词汇更长尾,因此 loss 更高、生成质量也更难稳定。
涉及的主要实验如下:
| 实验模块 | TinyStories | OpenWebText | 目的 |
|---|---|---|---|
| BPE tokenizer training | 10K vocab | 32K vocab | 训练领域 tokenizer |
| tokenizer experiments | 有 | 有 | 比较压缩率、错配 tokenizer、吞吐 |
| main training | 20k steps | 20k steps | 比较同规模模型在不同数据上的表现 |
| learning-rate sweep | 7 个 LR | 3 个 LR | 寻找合适学习率 |
| high-LR instability | 有 | 无 | 分析过大学习率导致的失稳 |
| batch-size sweep | 有 | 无 | 比较不同 batch size 的训练效果和吞吐 |
| architecture ablation | 有 | 无 | 分析 RMSNorm、PreNorm、RoPE、SwiGLU 的作用 |
| generation | 有 | 有 | 比较生成文本质量 |
2. 相关评估指标解释
“ 在正式看结果前,先解释几个贯穿全文的指标。 ”
| 指标 | 含义 |
|---|---|
vocab size |
tokenizer 词表大小,即 token ID 的总数量 |
merge count |
BPE 合并次数,通常约等于 vocab size - 256 - special tokens |
tokens |
文本被 tokenizer 编码后的 token 数量 |
validation loss / val loss |
模型在验证集上的 cross-entropy loss,不参与参数更新 |
best val loss |
训练过程中出现过的最低验证损失 |
final val loss |
训练结束时的验证损失 |
perplexity / ppl |
exp(loss),表示模型对下一个 token 的困惑程度 |
batch size |
每次参数更新使用多少条 token 序列 |
context length |
每条训练序列的 token 长度 |
steps |
参数更新次数 |
tokens processed |
训练中总共处理的 token 数,等于 batch_size × context_length × steps |
throughput |
训练速度,通常是 tokens/s |
wallclock time |
实际运行耗时 |
bytes/token |
tokenizer 压缩率,每个 token 平均覆盖多少 UTF-8 bytes |
diverged |
是否数值发散,例如 loss 变成 NaN/Inf |
“ 其中,最重要的评估指标是 validation loss。训练 loss 反映模型在训练数据上的拟合情况,而 validation loss 使用未参与训练的验证集评估模型泛化能力,因此更适合作为模型效果的主要指标。 ”
3. Tokenizer 训练:TinyStories 10K vs OpenWebText 32K
Tokenizer 是语言模型训练的第一步。原始文本不能直接输入 Transformer,需要先通过 BPE tokenizer 编码成 token ID 序列。
TinyStories 使用 10K 词表,OpenWebText 使用 32K 词表。两者都采用 byte-level BPE,并加入 special token <|endoftext|>。
3.1 Tokenizer 训练参数与结果
| 项目 | TinyStories | OpenWebText |
|---|---|---|
| 数据集 | TinyStories | OpenWebText |
| tokenizer 类型 | byte-level BPE | byte-level BPE |
| vocab size | 10,000 | 32,000 |
| special token | endoftext | endoftext |
| merge 数量 | 9,743 | 31,743 |
| 最长 token | b' accomplishment' |
长度 64 bytes 的重复乱码 byte 串 |
| train token 数 | 541,229,347 | 2,727,120,452 |
| validation token 数 | 5,465,883 | 66,401,098 |
| wallclock time | 8:17.83 | 4:08:28 |
| 最大 RSS 内存 | 约 1.9 GB | 约 9.5 GB |
| 是否需要 GPU | 否 | 否 |
| handout 资源限制 | 未超限 | 低于 12h / 100GB RAM |
3.2 结果分析
TinyStories tokenizer 的训练非常轻量,10K 词表在 8 分钟左右完成,最大内存只有约 1.9GB。最长 token 是 b' accomplishment',这是一个带前导空格的英文词片段,说明 tokenizer 学到的是自然语言中常见的 subword,而不是随机 byte 串。
OpenWebText tokenizer 的训练成本明显更高,耗时约 4 小时,内存约 9.5GB。这是合理的,因为 OWT 数据规模更大,词表也从 10K 增加到 32K。它的最长 token 是一个长度 64 bytes 的重复乱码串,看起来不美观,但这并不异常。OpenWebText 来自网页抓取数据,包含编码污染、HTML 残留和重复 byte 模式,BPE 只根据频率合并,不理解语义,因此会把高频乱码片段也合并进词表。
总体来看,两个 tokenizer 都满足 handout 要求。TinyStories tokenizer 更干净、更轻量;OWT tokenizer 更大、更适合复杂网页文本,但也会吸收更多噪声模式。
4. Tokenizer 压缩率与吞吐实验
“ Tokenizer 不只是前处理工具,它会直接影响语言模型看到的序列长度。相同文本如果被切成更多 token,模型在固定 context length 下看到的真实字符范围就更短,训练和推理成本也更高。 ”
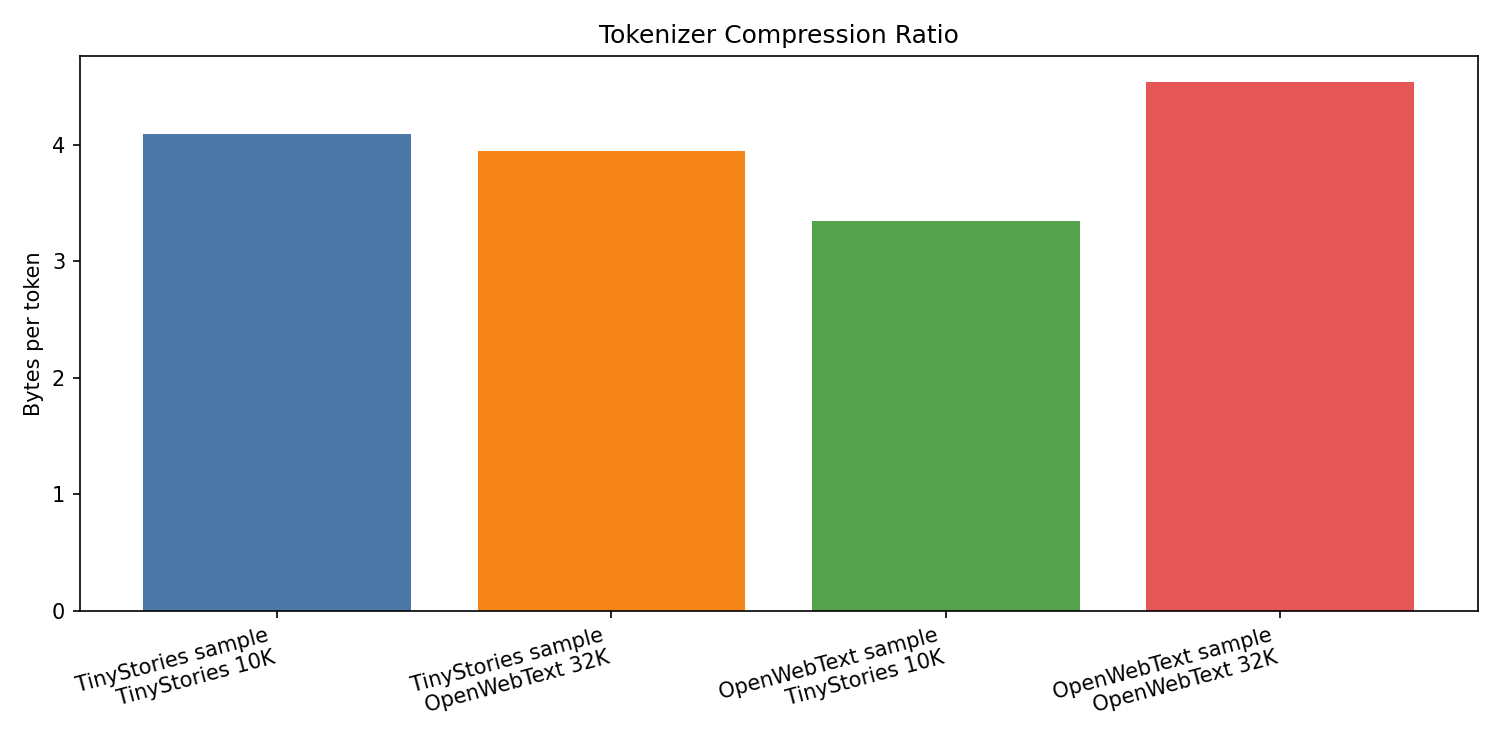
本实验比较了 TinyStories tokenizer 和 OWT tokenizer 在 TinyStories 样本与 OWT 样本上的压缩率。
4.1 压缩率实验参数
| 项目 | 设置 |
|---|---|
| TinyStories tokenizer | 10K byte-level BPE |
| OWT tokenizer | 32K byte-level BPE |
| TinyStories sample bytes | 8,648 |
| OWT sample bytes | 88,949 |
| 压缩率指标 | bytes/token |
| 指标解释 | 每个 token 平均覆盖多少 bytes,越高越好 |
4.2 压缩率结果
| 样本文本 | tokenizer | bytes | tokens | bytes/token |
|---|---|---|---|---|
| TinyStories sample | TinyStories 10K | 8,648 | 2,114 | 4.0908 |
| TinyStories sample | OpenWebText 32K | 8,648 | 2,189 | 3.9507 |
| OpenWebText sample | TinyStories 10K | 88,949 | 26,601 | 3.3438 |
| OpenWebText sample | OpenWebText 32K | 88,949 | 19,611 | 4.5357 |
图 1 压缩率结果
4.3 分析
在 TinyStories 样本上,TinyStories tokenizer 的压缩率略优于 OWT tokenizer:
4.0908 vs 3.9507优势约 3.4%。这说明在儿童故事领域,专门训练的 10K tokenizer 已经足够有效。
但在 OpenWebText 样本上,差异非常明显:
OWT tokenizer: 4.5357 bytes/token
TinyStories tokenizer: 3.3438 bytes/token
如果用 TinyStories tokenizer 去切 OWT 文本,同样文本需要 26,601 tokens,而 OWT tokenizer 只需要 19,611 tokens。token 数增加约 35.6%。这意味着模型在相同 context length 下看到的真实文本范围更短,训练也更低效。
这说明 tokenizer 具有明显的领域匹配性:TinyStories tokenizer 更适合儿童故事,OWT tokenizer 更适合网页文本。
4.4 Tokenizer 吞吐结果
| tokenizer | 吞吐 MB/s | 编码 825GB Pile 估计秒数 | 估计小时数 |
|---|---|---|---|
| TinyStories 10K | 1.4712 | 560,762.5 | 155.77 |
| OpenWebText 32K | 1.3818 | 597,061.7 | 165.85 |
图 2 吞吐结果
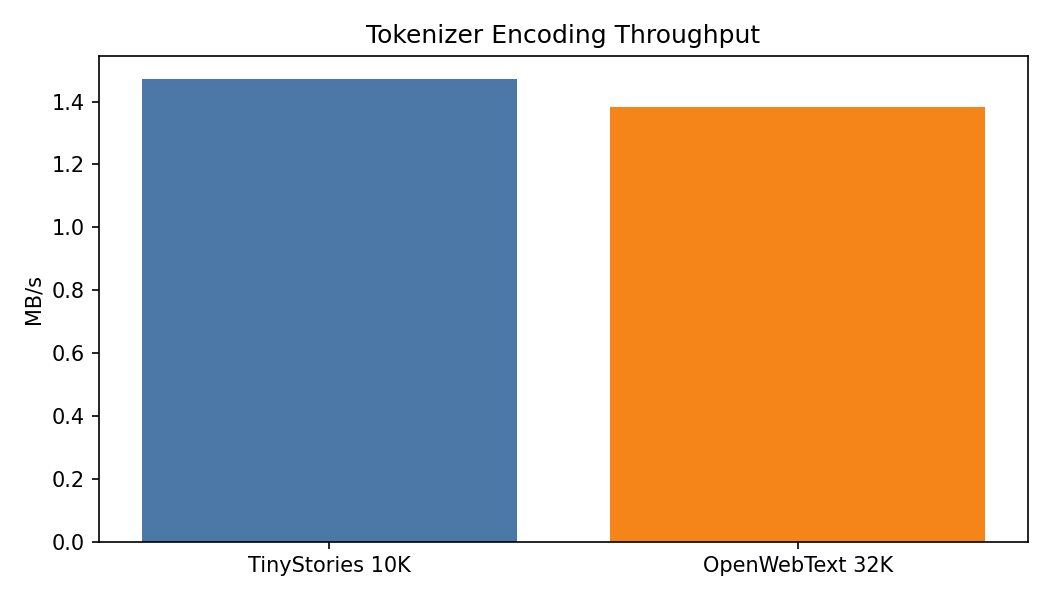
OWT 32K tokenizer 比 TinyStories 10K tokenizer 慢约 6.1%。这也符合预期:更大的词表和更多 merge 规则会带来更复杂的匹配过程。
这个结果也说明,大规模数据集的离线 tokenizer 编码本身就是实际 bottleneck。用当前实现去编码 825GB Pile 需要约 156 到 166 小时,远远不是一个可以忽略的前处理步骤。
5. 主训练实验
“ 接下来比较 TinyStories 和 OpenWebText 上的主训练结果。两个实验使用相同的 Transformer 主体规模、相同 context length、相同 batch size 和相同训练步数。主要差异是数据集和 tokenizer。 ”
5.1 主训练参数对比
| 参数 | TinyStories full baseline | OpenWebText main |
|---|---|---|
| vocab size | 10,000 | 32,000 |
| context length | 256 | 256 |
| num layers | 4 | 4 |
| d_model | 512 | 512 |
| num heads | 16 | 16 |
| d_ff | 1,344 | 1,344 |
| batch size | 64 | 64 |
| total steps | 20,000 | 20,000 |
| tokens processed | 327,680,000 | 327,680,000 |
| optimizer | AdamW | AdamW |
| beta1 / beta2 | 0.9 / 0.95 | 0.9 / 0.95 |
| weight decay | 0.1 | 0.1 |
| LR schedule | warmup + cosine decay | warmup + cosine decay |
5.2 主训练结果对比
| 指标 | TinyStories | OpenWebText |
|---|---|---|
| learning rate | 1e-3 | 3e-3 |
| best val loss | 1.3735 | 3.9623 |
| final val loss | 1.3735 | 3.9649 |
| final / best perplexity | 3.9493 | 52.576 |
| total time | 78.4 min / 4,703.06s | 7,192.44s |
| avg throughput | 69,674 tok/s | 约 45,600 tok/s |
| 是否达到 TinyStories handout 目标 | 是,val loss < 1.45 | 不适用 |
5.3 结果分析
图 3 TinyStory learning rate
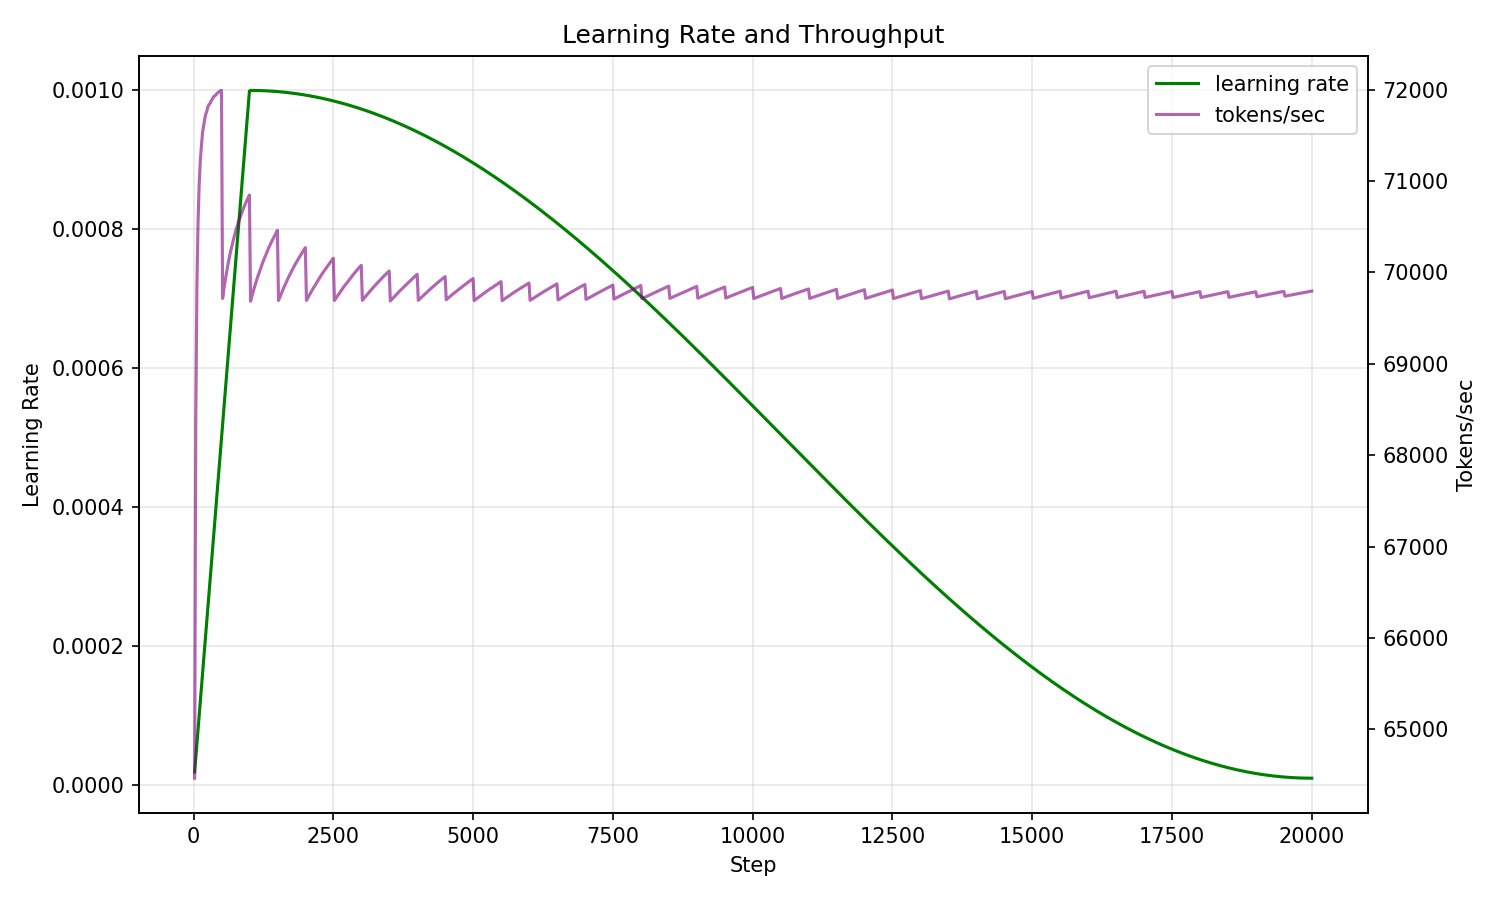
图 4 TinyStory curve
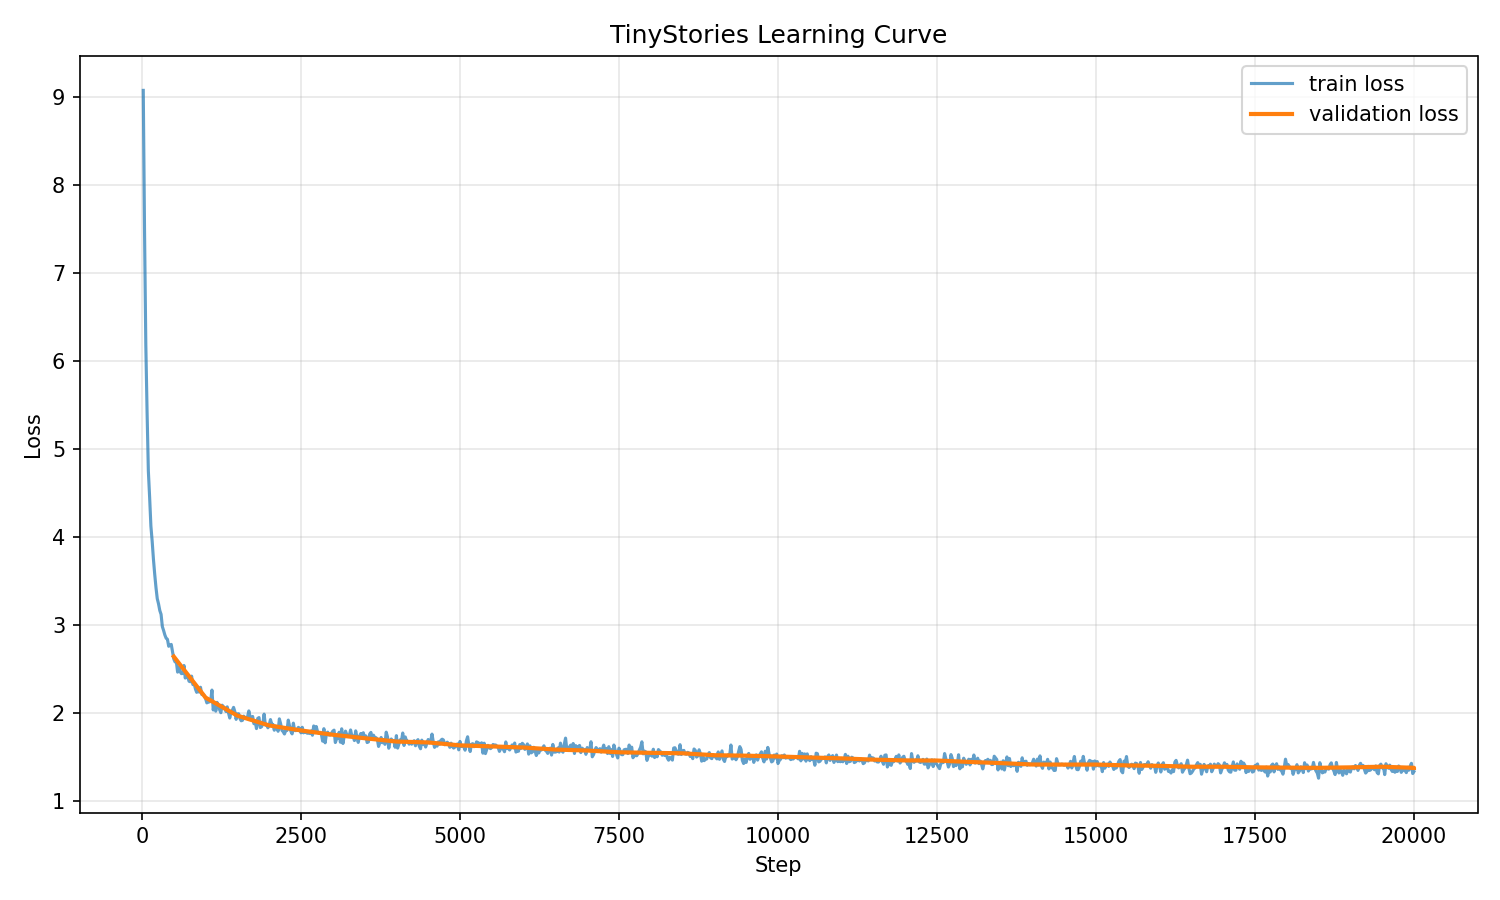
图 5 OpenWebText learning rate
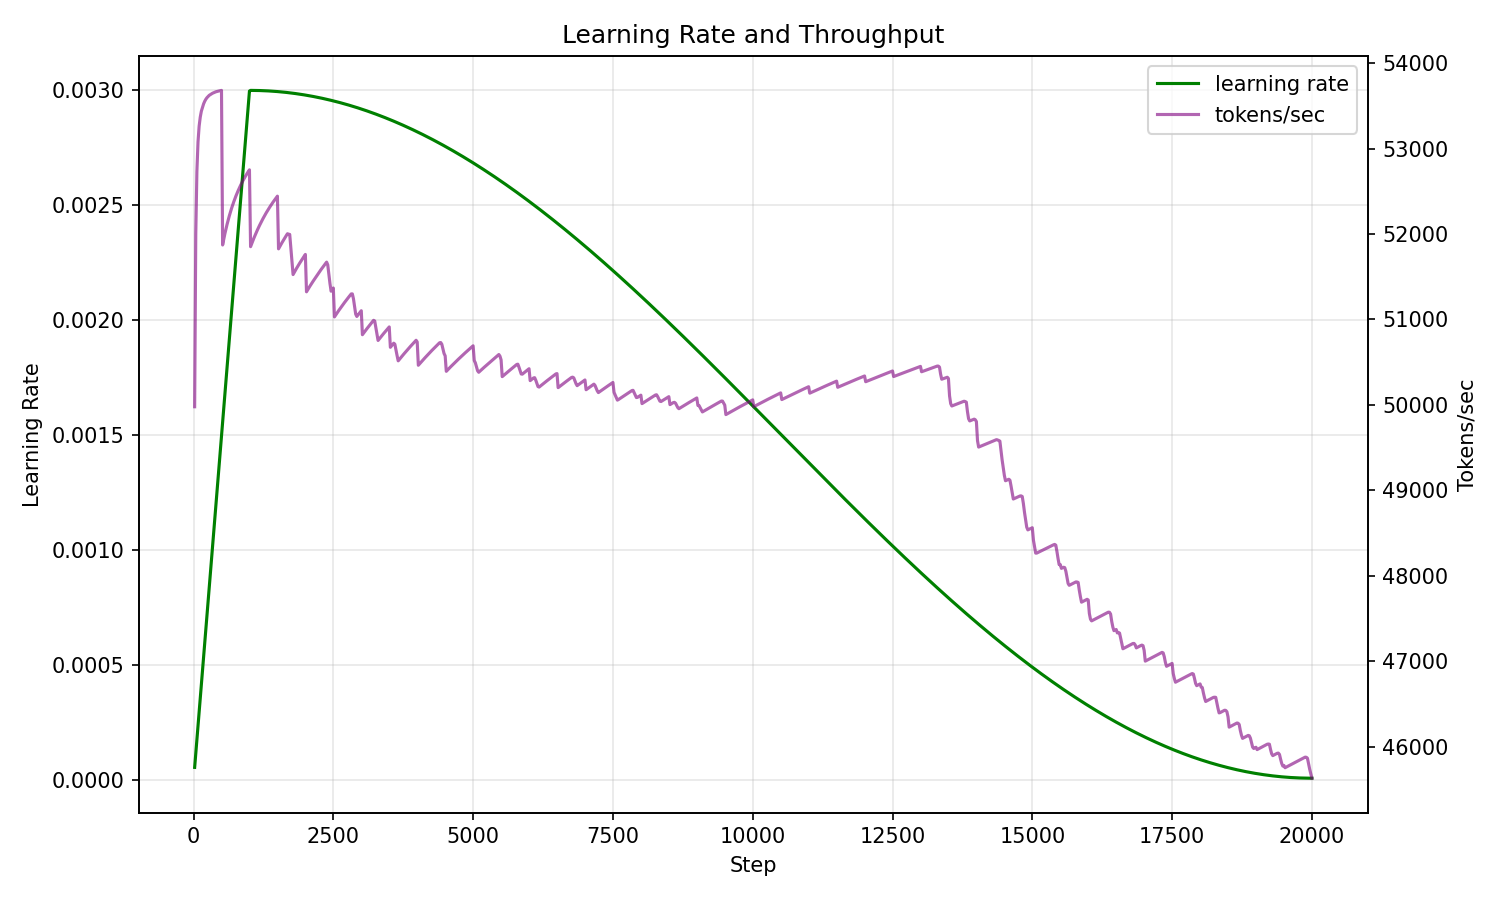
图 6 OpenWebText curve
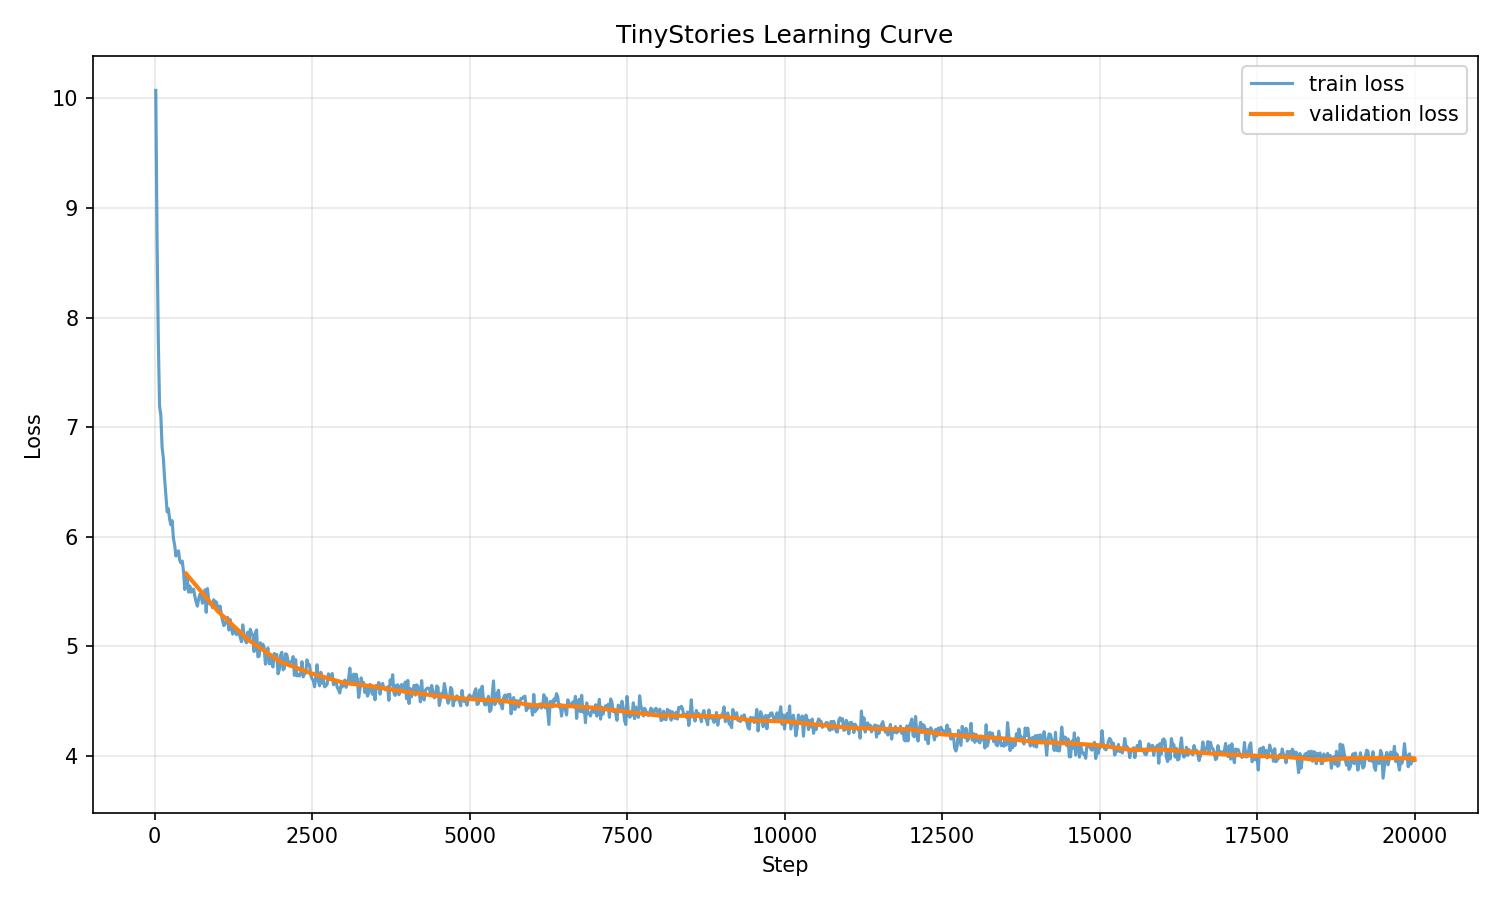
TinyStories full baseline 最终 validation loss 为 1.3735,低于 handout 要求的 1.45,说明 tokenizer、数据加载、模型实现、优化器、学习率调度和验证流程整体有效。生成文本也已经具备基本儿童故事结构,有角色、物体、动作和简单对话。
OpenWebText 的 final validation loss 为 3.9649,perplexity 约 52.6,明显高于 TinyStories。这不是异常,而是数据难度差异导致的合理结果。OWT 数据来源更复杂,包含新闻、论坛、网页、代码片段、噪声文本等,语言分布比 TinyStories 更宽、更长尾。相同模型容量和相同训练 token budget 下,OWT 不可能达到 TinyStories 那样低的 loss。
此外,OWT 的训练速度也更慢。虽然处理的 token 数相同,但 OWT 使用 32K vocab,softmax 和 LM head 的计算更重,因此 throughput 从 TinyStories 的约 69.7k tok/s 降到约 45.6k tok/s,训练时间增加约 52.9%。
6. Learning Rate Sweep
“ 学习率是语言模型训练中最重要的超参数之一。学习率太小,模型学得慢;学习率太大,训练不稳定甚至发散。这里分别在 TinyStories 和 OWT 上做了学习率搜索。 ”
6.1 TinyStories 参数
| 参数 | 数值 |
|---|---|
| 数据集 | TinyStories |
| tokenizer | TinyStories 10K BPE |
| vocab size | 10,000 |
| context length | 256 |
| num layers | 4 |
| d_model | 512 |
| num heads | 16 |
| d_ff | 1,344 |
| batch size | 64 |
| steps per run | 5,000 |
| tokens per run | 81,920,000 |
| warmup steps | 500 |
| lr_min | 1e-5 |
| LR schedule | warmup + cosine decay |
| sweep 范围 | 1e-4 到 1e-1 |
6.2 TinyStories 结果
| learning rate | best val loss | final val loss | best ppl | tokens | time | diverged |
|---|---|---|---|---|---|---|
| 1e-4 | 2.1385 | 2.1432 | 8.49 | 81,920,000 | 21.6 min | False |
| 3e-4 | 1.7870 | 1.7922 | 5.97 | 81,920,000 | 21.6 min | False |
| 1e-3 | 1.5667 | 1.5727 | 4.79 | 81,920,000 | 21.8 min | False |
| 3e-3 | 1.4950 | 1.5027 | 4.46 | 81,920,000 | 22.0 min | False |
| 1e-2 | 1.5217 | 1.5292 | 4.58 | 81,920,000 | 21.7 min | False |
| 3e-2 | 1.7472 | 1.7538 | 5.74 | 81,920,000 | 22.4 min | False |
| 1e-1 | 2.6098 | 2.6159 | 13.60 | 81,920,000 | 22.1 min | False |
图 7 Learning Rate Sweep
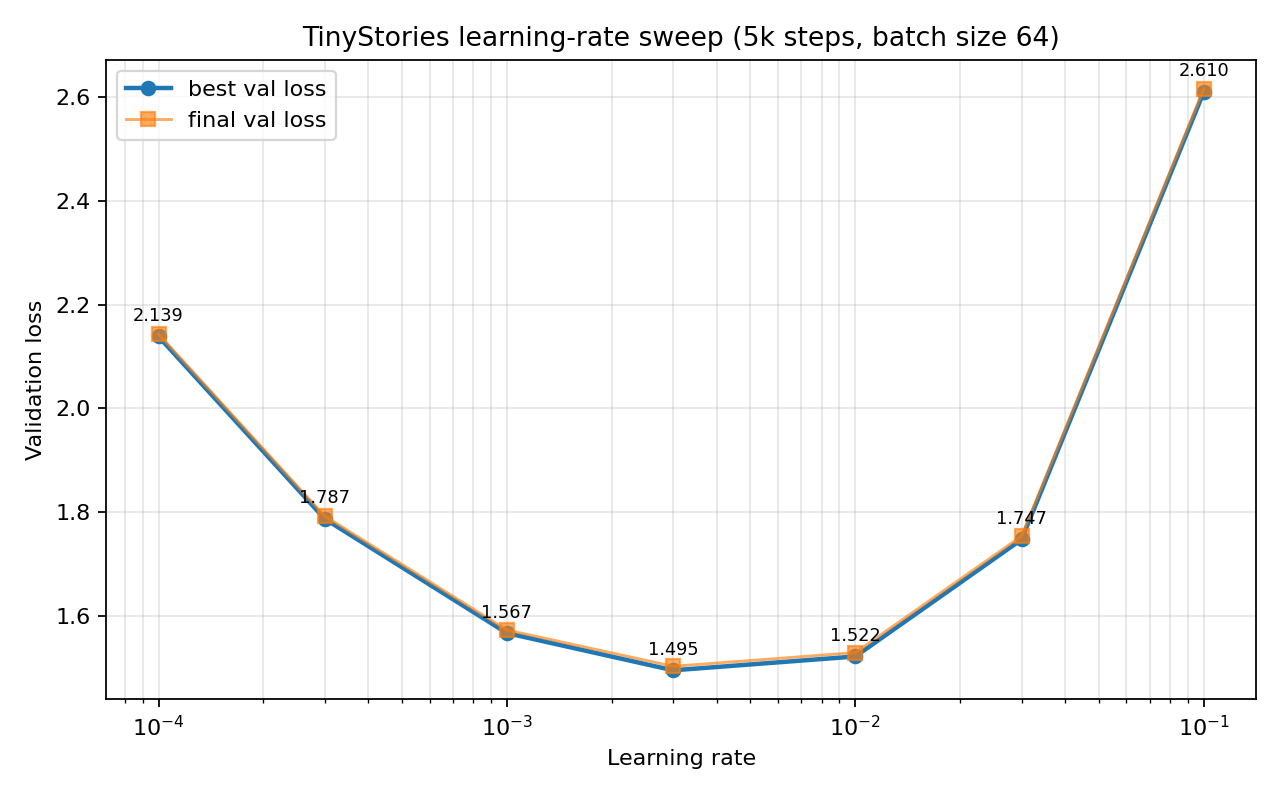
TinyStories 5k-step sweep 的最佳学习率是:
lr = 3e-3
best val loss = 1.4950
结果呈现出典型的 U 形趋势。1e-4 明显欠训练,loss 高;从 3e-4 到 3e-3 持续改善;继续增大到 1e-2 后略微变差;3e-2 和 1e-1 明显过大,优化质量下降。
值得注意的是,TinyStories full baseline 使用的是 1e-3,而不是 sweep 中最好的 3e-3。尽管如此,20k-step full baseline 已经达到 val loss 1.3735,满足 handout 要求。如果追求更低 loss,可以用 3e-3 跑一个完整 20k-step 复验。
6.3 OpenWebText 参数
| 参数 | 数值 |
|---|---|
| 数据集 | OpenWebText |
| tokenizer | OWT 32K BPE |
| vocab size | 32,000 |
| context length | 256 |
| num layers | 4 |
| d_model | 512 |
| num heads | 16 |
| d_ff | 1,344 |
| batch size | 64 |
| steps per run | 5,000 |
| tokens per run | 81,920,000 |
| LR sweep 范围 | 3e-4, 1e-3, 3e-3 |
6.4 OpenWebText 结果
| learning rate | best val loss | 结论 |
|---|---|---|
| 3e-4 | 4.8922 | 学习偏慢 |
| 1e-3 | 4.4757 | 明显改善 |
| 3e-3 | 4.3052 | 当前测试范围最佳 |
图 8 Learning Rate Sweep
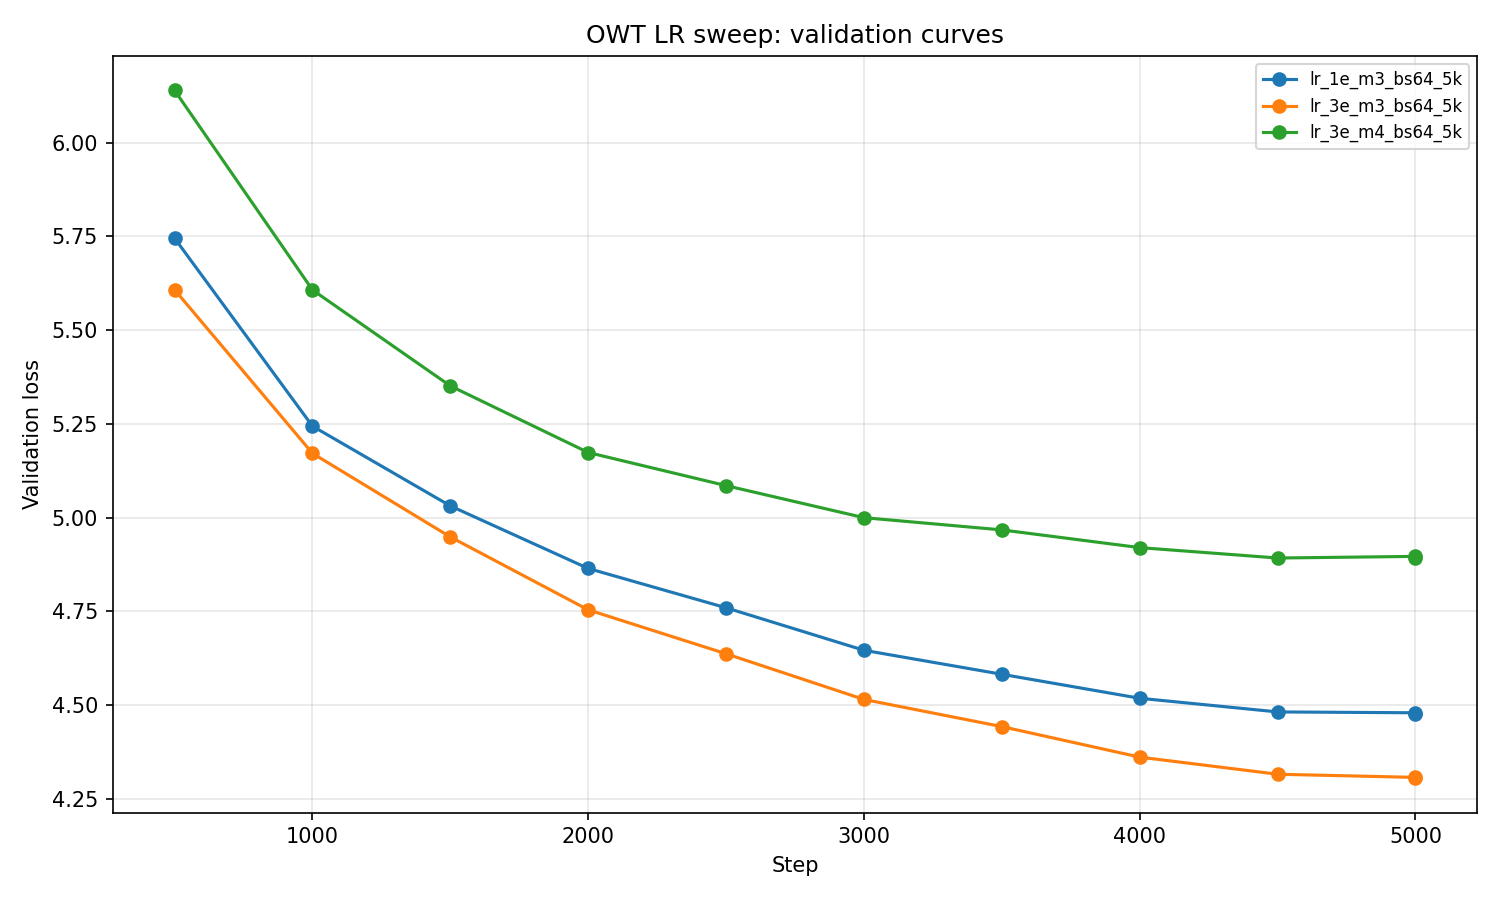
图 9 Learning Rate Sweep best loss
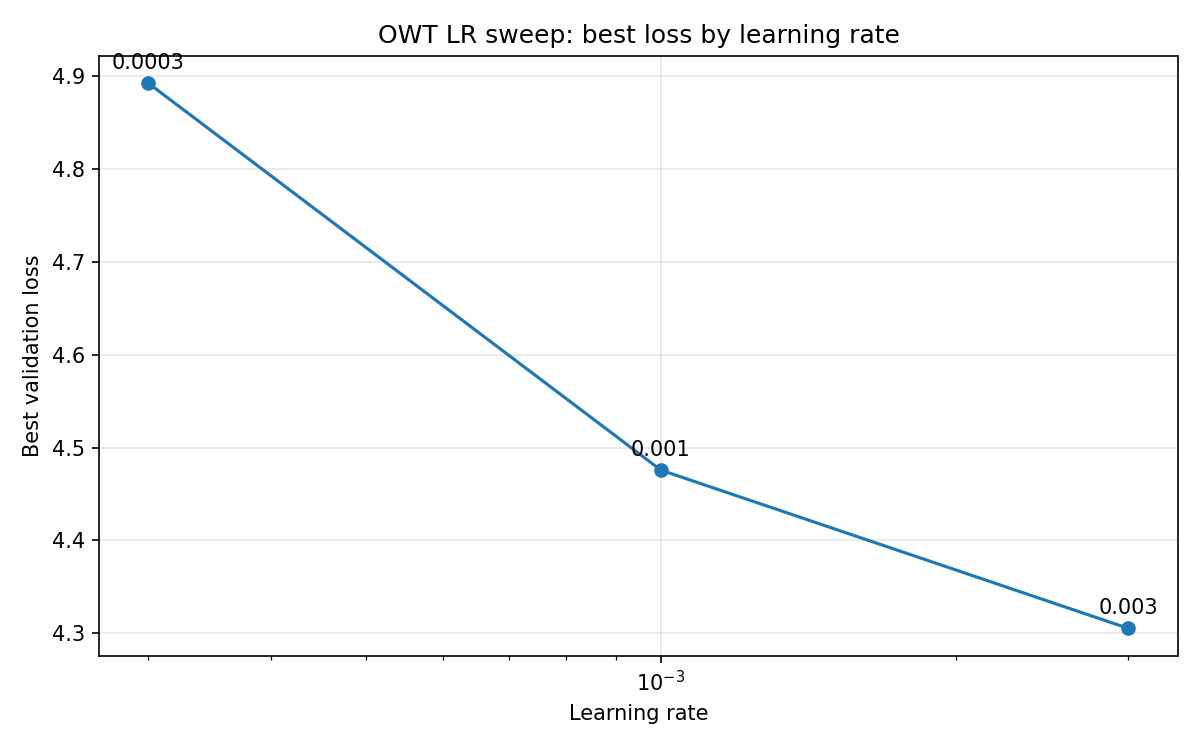
OWT 的 LR sweep 只覆盖了 3 个点,比 TinyStories 更窄,但已经能说明在测试范围内 3e-3 最好。相比 1e-3,3e-3 的 best val loss 进一步下降 0.1705,说明对 OWT 重新调学习率是有必要的。
不过,这个 sweep 不能证明 3e-3 是 OWT 的全局最优学习率,只能说明它是当前搜索范围内的最佳选择。
6.5 高学习率失稳实验
为了观察 edge of stability,还补充了 TinyStories 上的高学习率实验。
| 参数 | 数值 |
|---|---|
| 数据集 | TinyStories |
| learning rate | 1.0 |
| warmup steps | 100 |
| batch size | 64 |
| context length | 256 |
| steps | 5,000 |
| tokens | 81,920,000 |
| best / final val loss | 3.8246 |
| final ppl | 45.82 |
| max observed val loss | 90.3715 |
| max-loss step | 1,800 |
| time | 22.0 min |
| NaN/Inf diverged | False |
图 10 失稳实验
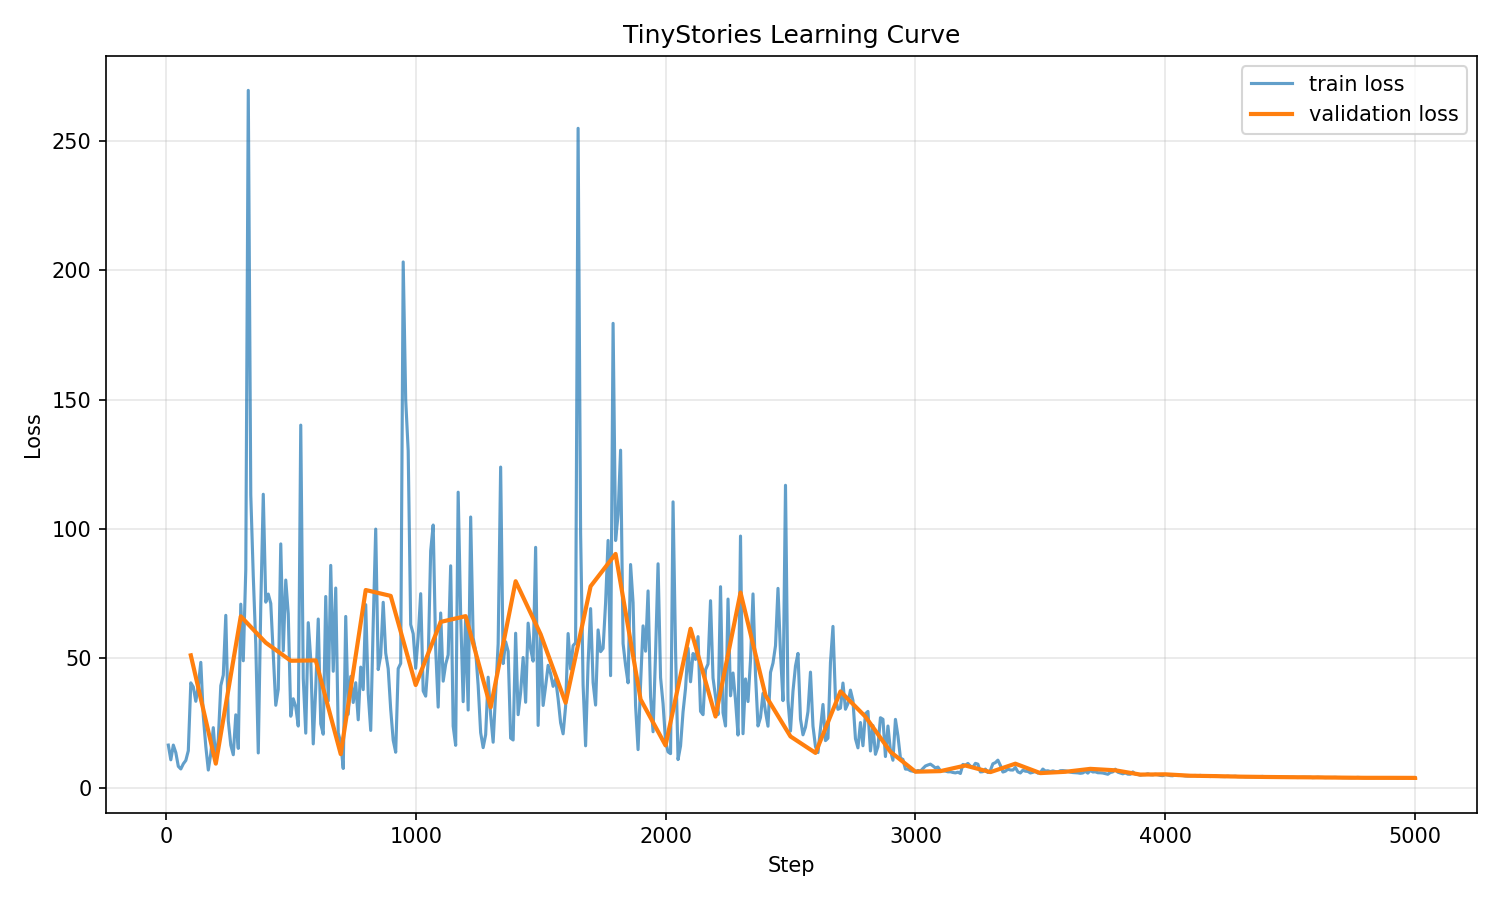
图 11 失稳吞吐以及学习率
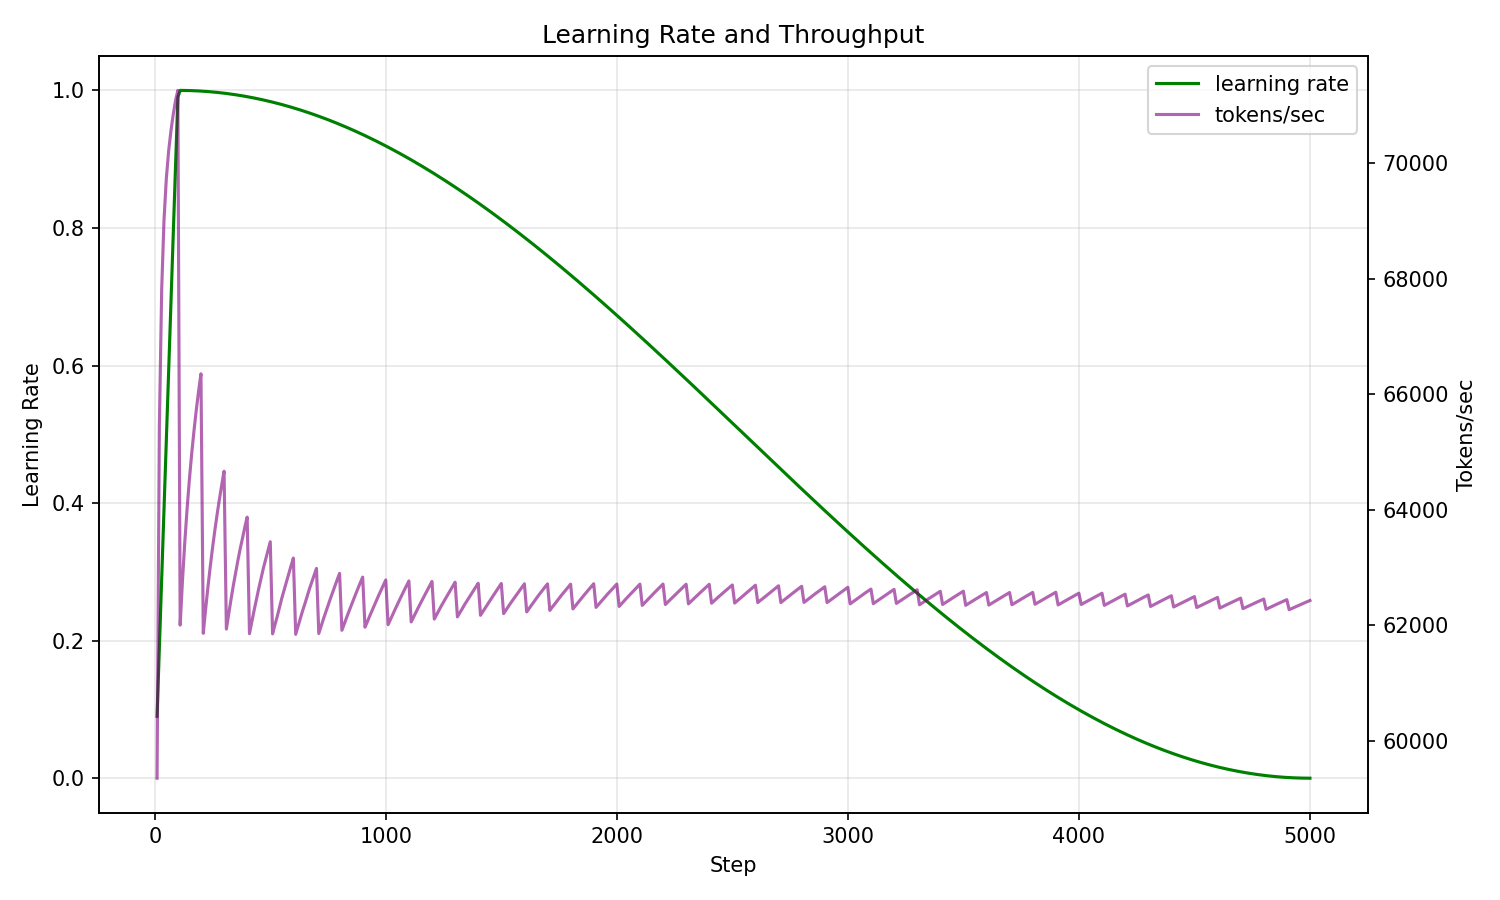
这条 run 没有出现 NaN,因此严格来说不是数值爆炸型发散。但它在 step 100 的 validation loss 已经达到 51.18,在 step 1800 达到 90.37,远高于正常 sweep 中 1.5 到 2.6 的区间。后期 loss 能恢复到 3.82,是因为 cosine decay 把学习率逐渐降到了较正常范围,但早期优化轨迹已经严重受损。
因此,这条曲线可以作为“过大学习率越过稳定边界,导致优化严重失稳”的证据。
7. Batch Size Sweep
“ Batch size 并不是越大越好。大 batch 每一步看到更多 token,梯度更稳定,但在固定 token budget 下会减少参数更新次数,也可能导致显存压力和吞吐下降。 ”
本实验只在 TinyStories 上进行。
7.1 Batch-size sweep 参数
| 参数 | 数值 |
|---|---|
| 数据集 | TinyStories |
| tokenizer | TinyStories 10K BPE |
| context length | 256 |
| 模型规模 | 4 layers, d_model 512, 16 heads, d_ff 1344 |
| batch sizes | 1, 4, 16, 32, 64, 128, 160 |
| token budget | 约 10.24M tokens |
| 学习率缩放 | 3e-3 * sqrt(batch_size / 64) |
| GPU 显存 | 24GB |
| 显存探测 | bs=160 可跑,bs=192 OOM |
7.2 Batch-size sweep 结果
| batch size | lr | steps | tokens | best val loss | final val loss | best ppl | avg tok/s | time |
|---|---|---|---|---|---|---|---|---|
| 1 | 0.000375 | 40,000 | 10,240,000 | 2.3490 | 2.3490 | 10.47 | 11,315 | 15.1 min |
| 4 | 0.00075 | 10,000 | 10,240,000 | 2.0901 | 2.1424 | 8.09 | 35,027 | 4.9 min |
| 16 | 0.0015 | 2,500 | 10,240,000 | 2.0043 | 2.0043 | 7.42 | 46,513 | 3.7 min |
| 32 | 0.00212132 | 1,250 | 10,240,000 | 1.9828 | 1.9988 | 7.26 | 47,565 | 3.6 min |
| 64 | 0.003 | 625 | 10,240,000 | 2.0355 | 2.0507 | 7.66 | 43,229 | 3.9 min |
| 128 | 0.00424264 | 312 | 10,223,616 | 2.1587 | 2.1645 | 8.66 | 31,784 | 5.4 min |
| 160 | 0.00474342 | 250 | 10,240,000 | 2.2550 | 2.2578 | 9.54 | 24,552 | 7.0 min |
7.3 分析
图 12 Batch-size sweep
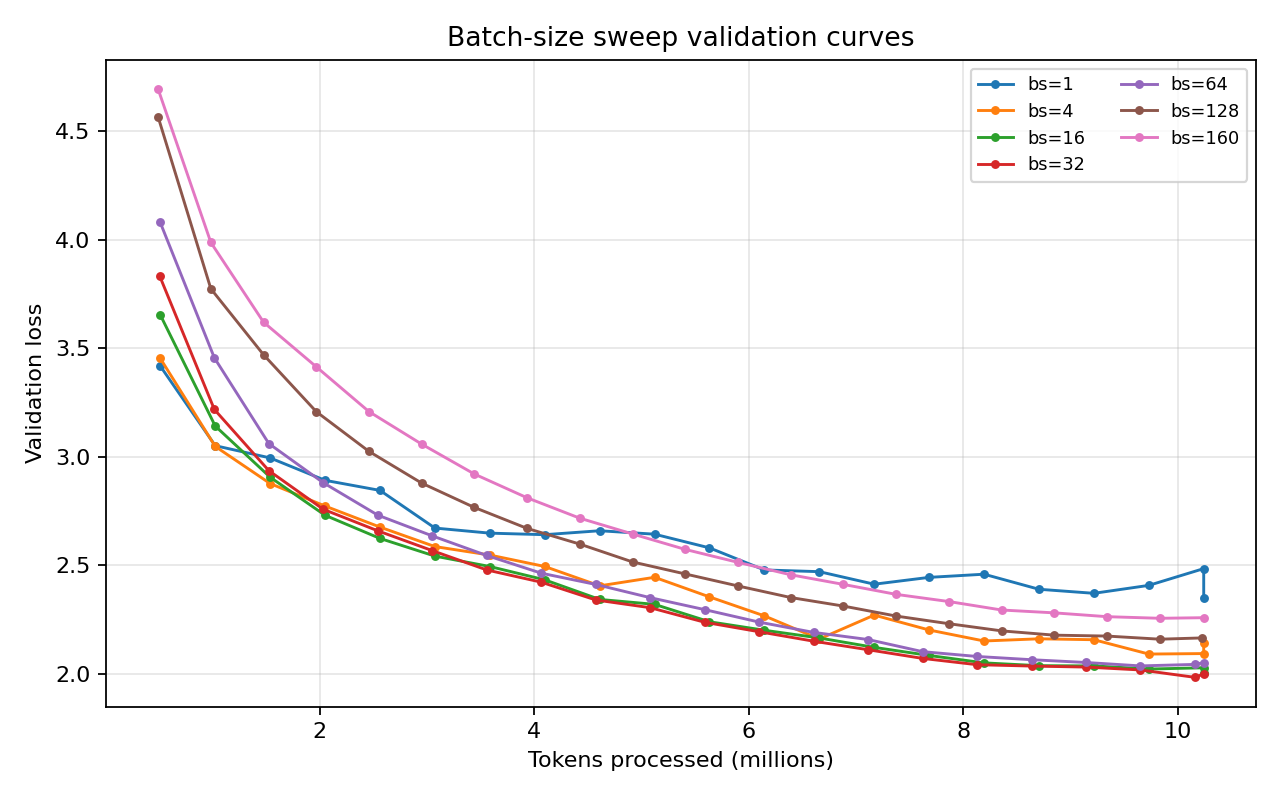
图 13 Batch-size sweep loss token per s
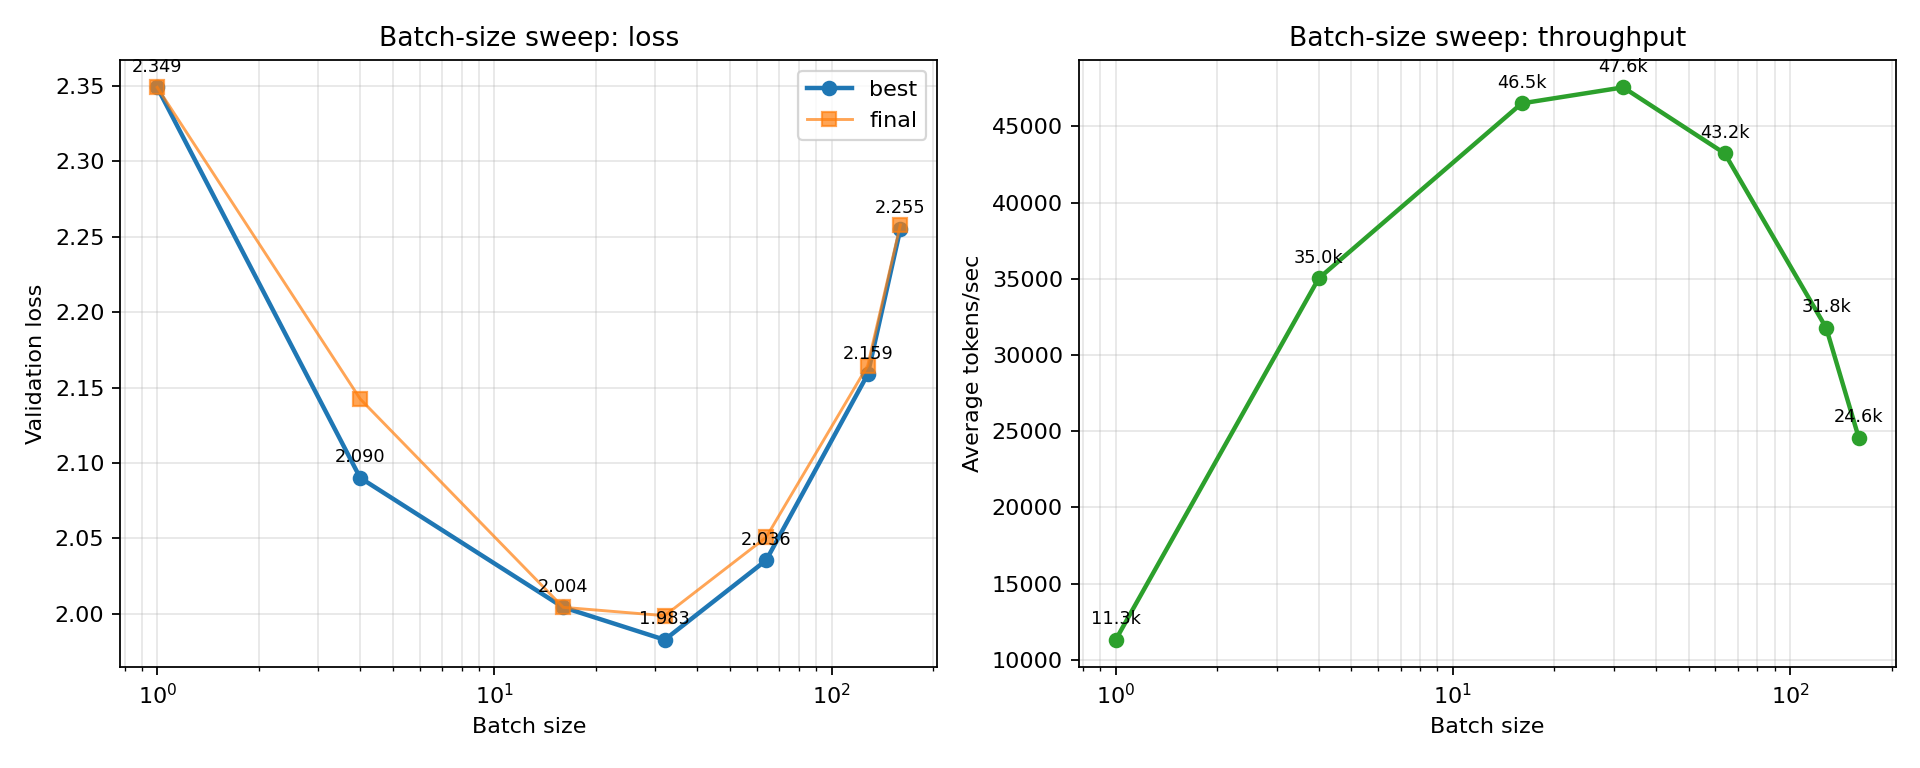
本实验最好的 batch size 是:
batch size = 32
best val loss = 1.9828
avg throughput = 47,565 tok/s
bs=32 相比 bs=64,best val loss 好 0.0527,吞吐还高约 10%。这说明在当前机器和短 token budget 下,bs=32 同时具备较好的优化效果和硬件效率。
bs=1 虽然有 40,000 次参数更新,但每一步只看 256 tokens,梯度噪声太大,validation loss 明显较差。另一方面,bs=160 每一步看 40,960 tokens,但总共只有 250 次更新,而且接近显存上限,吞吐降到 24.6k tok/s,loss 也明显变差。
因此,这个实验直接反驳了“batch size 越大越好”的误解。固定 token budget 下,batch size 需要在梯度稳定性、更新次数、显存占用和吞吐之间折中。
8. 架构消融实验
“ 架构消融实验用于判断 Transformer 中不同组件的实际贡献。本组实验在 TinyStories 上进行,使用 5k steps、81.92M tokens,baseline 使用 TinyStories LR sweep 中的最佳学习率 3e-3。 ”
8.1 架构消融实验参数
| 参数 | 数值 |
|---|---|
| 数据集 | TinyStories |
| tokenizer | TinyStories 10K BPE |
| vocab size | 10,000 |
| context length | 256 |
| num layers | 4 |
| d_model | 512 |
| num heads | 16 |
| d_ff | 1,344 |
| batch size | 64 |
| steps | 5,000 |
| tokens | 81,920,000 |
| baseline LR | 3e-3 |
| baseline 架构 | PreNorm + RMSNorm + RoPE + SwiGLU |
8.2 架构消融结果
| run | variant | lr | best val loss | final val loss | best ppl | steps | time | diverged |
|---|---|---|---|---|---|---|---|---|
baseline_lr3e3 |
baseline | 0.003 | 1.4950 | 1.5027 | 4.46 | 5000 | 20.1 min | False |
no_norm_lr3e3 |
no_norm | 0.003 | 8.235e13 | NaN | Inf | 546 | 2.2 min | True |
no_norm_lr3e4 |
no_norm | 0.0003 | 1.8417 | 1.8475 | 6.31 | 5000 | 19.2 min | False |
no_norm_lr1e4 |
no_norm | 0.0001 | 2.2806 | 2.2886 | 9.78 | 5000 | 19.3 min | False |
post_norm_lr3e3 |
post_norm | 0.003 | 1.5473 | 1.5536 | 4.70 | 5000 | 20.1 min | False |
post_norm_lr1e3 |
post_norm | 0.001 | 1.5712 | 1.5769 | 4.81 | 5000 | 20.9 min | False |
nope_lr3e3 |
no_pos_emb | 0.003 | 1.5731 | 1.5802 | 4.82 | 5000 | 17.8 min | False |
silu_lr3e3 |
SiLU FFN | 0.003 | 1.5058 | 1.5132 | 4.51 | 5000 | 20.3 min | False |
8.3 消融结果分析
图 14 消融结果
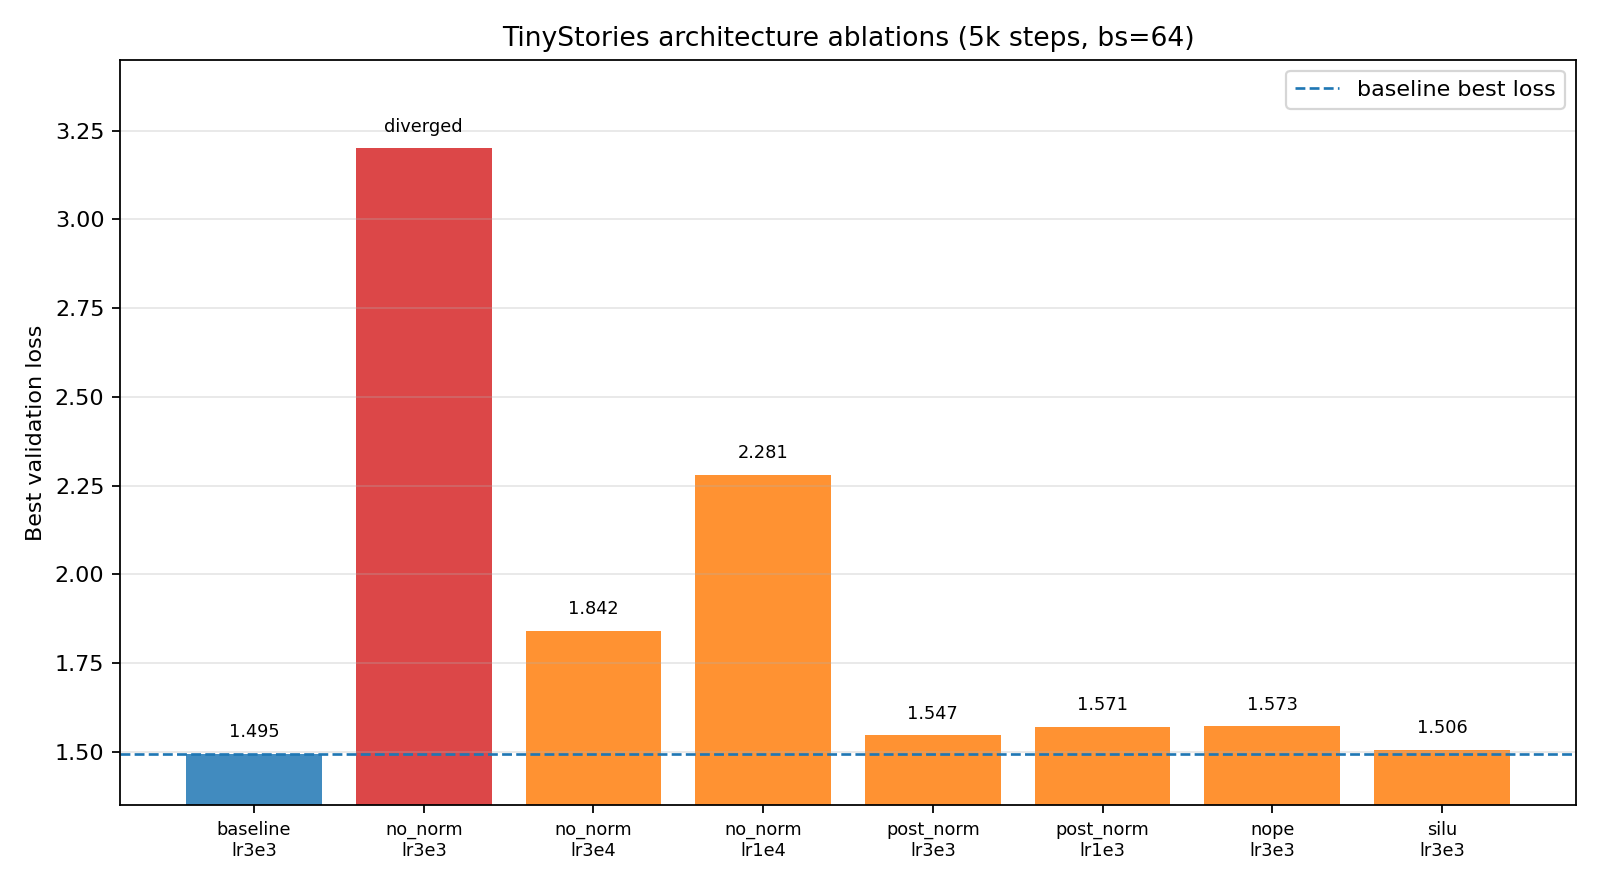
图 15 消融结果curve
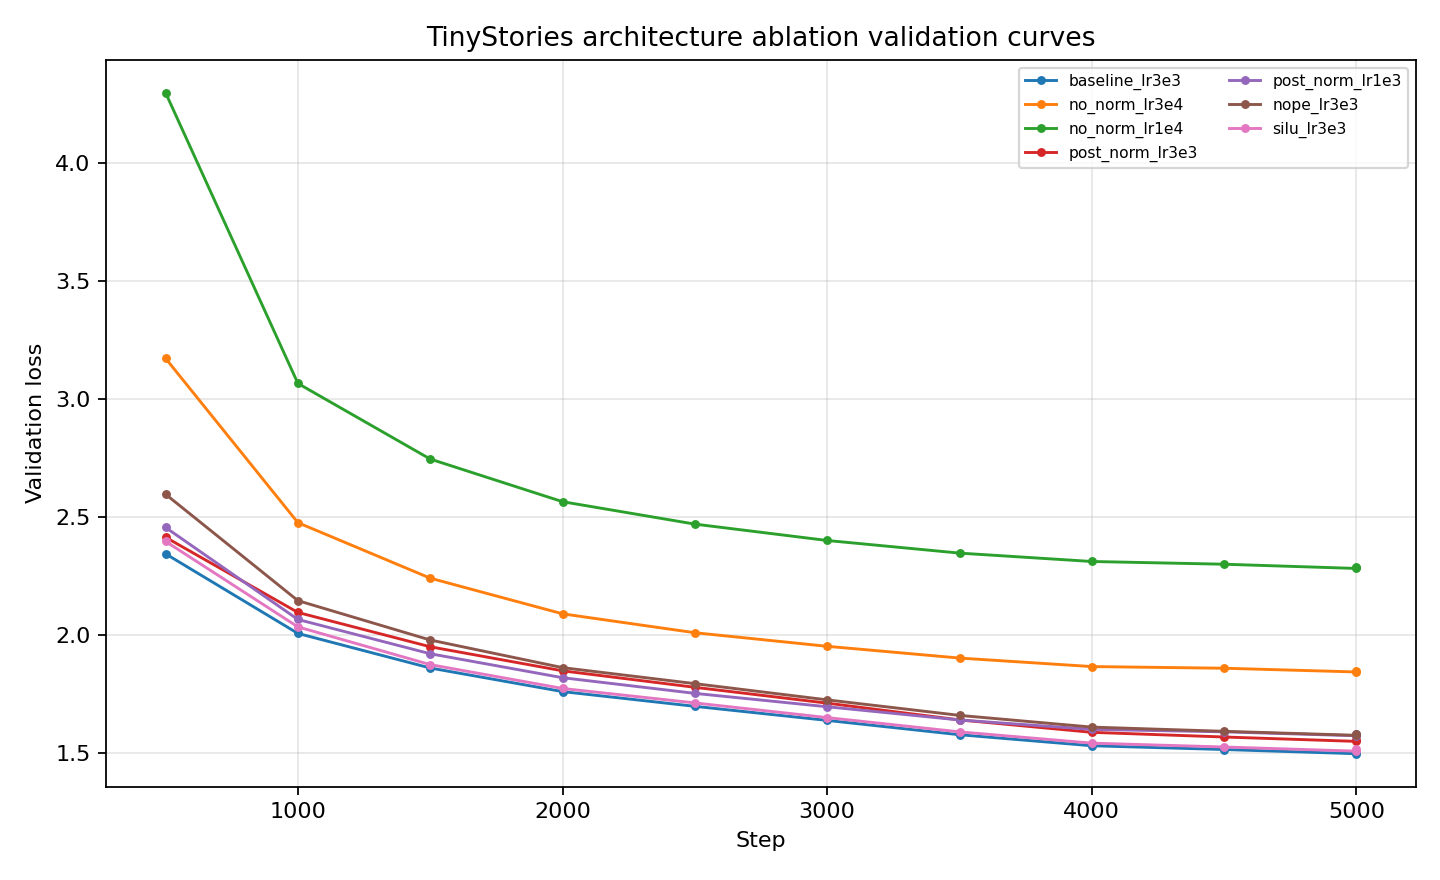
- baseline 的 best val loss 是 1.4950,这是所有消融对比的参考点。
- 首先,去掉 RMSNorm 后,在原最佳学习率
3e-3下模型在 step 546 发散,final loss 变成 NaN。这是非常强的证据,说明 RMSNorm 对训练稳定性非常关键。降低学习率到3e-4后虽然可以稳定训练,但 best val loss 只有 1.8417,明显差于 baseline;再降到1e-4,loss 进一步变差到 2.2806。这说明降低学习率只能救稳定性,不能恢复性能。 - PostNorm 版本没有发散,但也落后于 PreNorm baseline。
post_norm_lr3e3的 best val loss 是 1.5473,比 baseline 差约 0.0523。这与现代 LLM 工程中普遍偏好 PreNorm 的经验一致。 - NoPE 去掉位置编码后,best val loss 为 1.5731,比 baseline 差约 0.0781。说明即使 TinyStories 是相对简单的儿童故事数据,位置信息仍然重要。不过 NoPE 的运行时间更短,这符合去掉 RoPE 计算后速度略快的预期。
- SiLU FFN 替代 SwiGLU 后,best val loss 是 1.5058,只比 baseline 差 0.0108,是所有非灾难性消融中最接近 baseline 的版本。这说明 SwiGLU 有收益,但在这个小模型和短预算设置下,它的影响不如 RMSNorm 或位置编码那么决定性。
9. 生成文本对比
“ 生成文本可以帮助我们从定性角度理解模型学到了什么。虽然生成文本不是严格量化指标,但它能直观反映模型的语言风格、连贯性和数据域差异。 ”
9.1 生成实验参数
| 参数 | TinyStories | OpenWebText |
|---|---|---|
| 模型来源 | TinyStories full baseline | OWT main |
| tokenizer | TinyStories 10K | OWT 32K |
| vocab size | 10,000 | 32,000 |
| context length | 256 | 256 |
| training steps | 20,000 | 20,000 |
| tokens processed | 327.68M | 327.68M |
| prompt 风格 | Once upon a time... |
Once upon a time... |
| 输出文件 | generated_text.txt |
generated_text.txt |
9.2 TinyStories 生成片段
Once upon a time, there was a little dog named Spot. Spot loved to play and run all day long. One day, Spot saw a big red ball in the park. He wanted to play with it, but he didn't know who it belonged to.TinyStories 模型的输出已经有明显儿童故事结构:角色清晰,事件简单,有动作和对话,整体比较连贯。它的问题主要是小模型常见的重复表达、局部逻辑跳跃和结尾不够自然,但整体符合 TinyStories 数据域预期。
9.3 OpenWebText 生成片段
Once upon a time, I would have been met with a few short weeks ago.

Once I had fully realized that I had to go to an airport in West Nile, and would have had to take a few days off the sea by the time I was on a trip to Europe.
OWT 模型的输出词面更像成人文本,句法也更复杂,但整体质量反而更差。它容易出现主题漂移、搭配奇怪、语义不自洽的问题。这与 OWT 的数据难度一致:数据更杂、噪声更多、主题跨度更大,而模型规模和训练预算并没有增加。
因此,TinyStories 生成看起来更“顺”,不代表模型更强,而是因为 TinyStories 任务本身更简单、更封闭。OWT 的 loss 更高、生成更混乱,是同规模模型在更复杂数据上训练不足的自然结果。
10. 实验日志与可复现性
“ 本次实验的日志系统基本满足 handout 要求。各 run 目录下包含 metrics.json、summary.json 和 .log 文件,可以追踪 step、loss、perplexity、wallclock time 等信息。 ”
| 字段 | 含义 |
|---|---|
step |
当前训练步数 |
loss |
当前评估 loss |
perplexity |
exp(loss) |
wallclock_time |
从训练开始到当前评估点的实际时间 |
tokens_processed |
已处理 token 数 |
learning_rate |
当前学习率 |
throughput |
当前或平均 tokens/s |
小结
这组实验完整展示了从 tokenizer 到语言模型训练的基本流程,也清楚体现了 TinyStories 和 OpenWebText 两个数据域的差异。
- TinyStories 方面,10K BPE tokenizer 训练快速、压缩效果合理,full baseline 在 20k steps 后达到 validation loss 1.3735,低于 handout 要求的 1.45。学习率搜索表明
3e-3是 5k-step 短跑中的最佳点,batch-size sweep 表明在固定 token budget 下bs=32比更大的 batch 更有效。架构消融进一步说明 RMSNorm 对稳定性至关重要,PreNorm、RoPE 和 SwiGLU 都对最终效果有不同程度帮助。 - OpenWebText 方面,32K BPE tokenizer 训练成本更高,但更适合网页文本,尤其在 OWT 样本上压缩率明显优于 TinyStories tokenizer。在同样模型规模和训练预算下,OWT main 的 final val loss 为 3.9649,远高于 TinyStories。这是合理结果,因为 OWT 更复杂、更嘈杂、词汇更长尾,同时 32K vocab 也增加了 softmax 计算成本。生成文本也体现了这一点:OWT 输出更像成人网页文本,但整体连贯性和自洽性弱于 TinyStories 模型。
笔者的话
“ 这里展现的是cs336(2025)的第一部分,是笔者第一个跑完的大型实验流程,结果挺有预见性的,帮助对这里的Transformer的大型架构的理解更加的深刻 ”