Transformer|架构演进(0):从 Transformer 架构到现代大模型导览
阅读提示: 笔者打算新开一个系列,想从我们从cs336出发看到的基本模型架构系统性地去了解现代大模型的一些比较新的架构原理,所以在这里先以一个序言来来开始我们新的旅途。对一个领域的学习总是逃不开对这个领域发展历史的了解,这有助于我们更加全面系统地将每一个由Transformer组件演化来的新的部分给纳入我们的认知体系,使它不再是单一的凌乱的知识点。整理和总结是非常重要的:抽离出一系列演化的基本准则以及规律,理解行业,预测风向,都是我们可以借此去做到的。以下展示的仅是作者的个人想法,如果你有什么好的思考,请联系笔者📮好了,这部分不需要什么前置知识,如果你感兴趣,大可以当成科普内容来读,笔者会尽量讲的清晰。祝食用愉快~👼
导言:从哪里开始?
“ 2017 年,Vaswani 等人在论文 Attention Is All You Need 中提出 Transformer。这个模型最初主要服务于机器翻译任务,但在之后几年里,它逐渐成为自然语言处理乃至现代大模型的基础架构。 ”
图 1 简略的演进历史
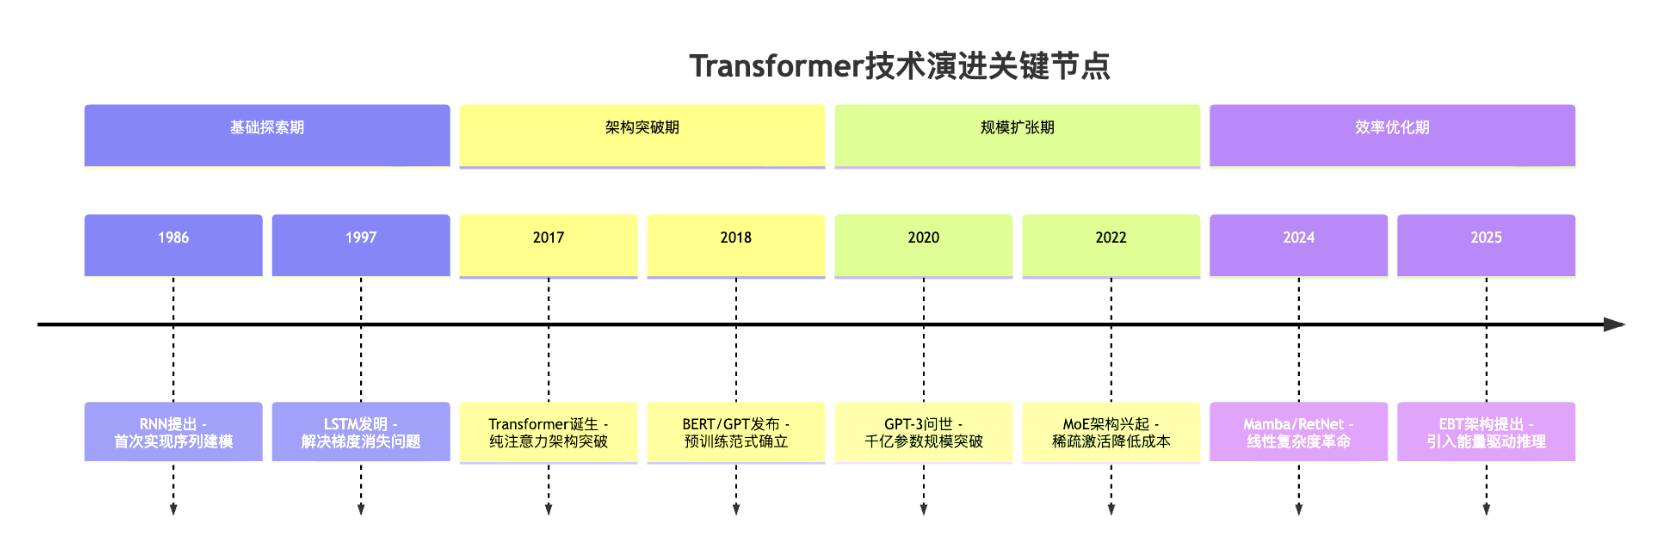
今天我们讨论 GPT、Claude、Gemini、LLaMA、Qwen、DeepSeek、Mistral 等模型时,虽然它们的规模、训练数据、推理系统和后训练方法已经远远超出 2017 年的原始 Transformer,但从模型结构上看,一个重要事实仍然成立:
“ 现代大语言模型的核心骨架并没有脱离 Transformer。 ”
- 它们的基本组成仍然是:
Embedding
+ Positional Encoding
+ Attention
+ Feed-Forward Network
+ Residual Connection
+ Normalization
+ Output Projection- 真正发生变化的是:
“ Transformer 的每个组件,都在更大规模、更长上下文、更低推理成本、更强表达能力和更稳定训练的需求下,被系统性地改造了。 ”
这篇文章是整个系列的序章。我们不会在这里深入推导某一个具体组件,而是先建立一张“架构演进图”。
后续文章会沿着这张地图,分别讨论:
- Vocab、Tokenizer、Embedding 与 LM Head
- Positional Encoding
- Attention
- FFN
- MoE
- Normalization 与 Residual
- Long Context
- Inference Optimization
- Post-training 与 Alignment
笔者私以为,理解现代大模型,最好的方式不是单纯记忆,而是理解:
这些模型为什么会在相同的 Transformer 主干上,对不同组件做出不同的工程选择。
2017 Transformer:原始框架长什么样?
原始 Transformer 是一个 Encoder-Decoder 架构。
在机器翻译任务中,Encoder 读取源语言句子,Decoder 根据 Encoder 的表示逐步生成目标语言句子。
例如:
Input:  I love machine learning.
Output: 我喜欢机器学习。
Encoder 负责理解输入句子,Decoder 负责生成输出句子。
如果把原始 Transformer 抽象成模块,可以写成:
Token IDs
  ↓
Vocab Embedding
  ↓
Add Positional Encoding
  ↓
Transformer Blocks:
    Multi-Head Attention
    Add & Norm
    Feed-Forward Network
    Add & Norm
  ↓
Output Projection
  ↓
Softmax over Vocabulary
其中最重要的两个子层是:
Multi-Head Attention
Feed-Forward Network
Attention 负责让不同 token 之间发生信息交互。
FFN 负责对每个 token 的隐藏表示做非线性变换。
原始 Transformer block 可以粗略写成:
x = LayerNorm(x + MultiHeadAttention(x))
x = LayerNorm(x + FeedForwardNetwork(x))
这种结构后来通常被称为 PostNorm,因为 LayerNorm 放在残差连接之后。
原始 Transformer 中还有几个非常经典的设计:
Sinusoidal Positional Encoding
Multi-Head Attention
ReLU Feed-Forward Network
LayerNorm
Encoder-Decoder Architecture
这些设计构成了现代大模型架构演进的起点。
“ 但是,随着模型规模越来越大、上下文越来越长、部署需求越来越复杂,这些组件几乎都被重新设计过。 ”
Transformer 后的三条主要路线
“ Transformer 提出之后,模型结构逐渐分化成三条主线: ”
Encoder-only
Decoder-only
Encoder-Decoder
这三条路线的区别,主要来自两个问题:
- 模型能看到哪些上下文?
- 模型的训练目标是什么?
Encoder-only:BERT 路线
“ Encoder-only 模型只保留 Transformer Encoder。代表模型是 BERT。 ”
BERT 的 self-attention 是双向的。也就是说,每个 token 可以同时看到它左边和右边的上下文。
例如句子:
The cat sits on the mat.在 BERT 中,sits 可以同时看到:
The cat
on the mat
所以BERT 常用的训练目标是 Masked Language Modeling,简称 MLM(随机掩码训练)。
也就是随机 mask 掉句子中的一部分 token,然后让模型预测它们:
The cat [MASK] on the mat.-
这种训练方式非常适合理解类任务,例如:
- 文本分类
- 情感分析
- 句子匹配
- 信息抽取
- 检索向量模型
- reranker
但是 Encoder-only 模型并不天然适合从左到右生成长文本。 因此,BERT 路线在今天仍然很重要,尤其是在 embedding、retrieval、reranking 和理解类任务中,但它不是现代聊天大模型的主流架构。
(可以见作者26-5-29在实践看法发的ukbFound中Pre-train架构的解析,里面使用的就是MLM掩码训练方式)
Decoder-only:GPT 路线
“ Decoder-only 模型只保留 Transformer Decoder 中的 causal self-attention 部分。代表模型是 GPT 系列。 ”
它的训练目标非常简单:
根据前面的 token,预测下一个 token。也就是:
P(x_t | x_1, x_2, ..., x_{t-1})例如:
The capital of France is模型需要预测下一个 token 可能是:
Paris这种训练方式叫 Causal Language Modeling,也就是常说的 next-token prediction。
Decoder-only 模型有一个非常重要的特点:
“ 它天然适合生成。 ”
无论是写文章、写代码、回答问题、生成 JSON、调用工具,还是进行多轮对话,本质上都可以转成:
给定前文,继续生成后文。非常适合自然语言对话和人机交互的实现,这也是现代通用大语言模型大多采用 decoder-only 架构的重要原因。
Encoder-Decoder:T5 / BART 路线
Encoder-Decoder 模型同时保留 Encoder 和 Decoder。代表模型包括:T5、BART、mT5、UL2 这类模型适合把一个输入序列转换成另一个输出序列。 例如:
翻译:英文 → 中文
摘要:长文章 → 短摘要
问答:问题 + 文档 → 答案
改写:原句 → 改写句
像T5 的一个核心思想是:
“ 把所有 NLP 任务都统一成 text-to-text。 ”
例如输入:
translate English to German: That is good.输出:
Das ist gut.Encoder-Decoder 架构在翻译、摘要、文本转换等任务中仍然很有价值。
这3条路径各有优劣。不过,我们也可以看到,在超大规模通用生成模型中,decoder-only 因为训练目标简单、推理结构自然、扩展性强,逐渐成为主流路线。
为什么现代 LLM 主要走向 Decoder-only?
现代聊天模型、代码模型、通用助手模型和 agent 模型,大多采用 decoder-only 架构。
这不是说Encoder-only 或 Encoder-Decoder 不好,而是因为 decoder-only 更适合大规模通用生成。主要原因有几个:
1. 训练目标足够简单
Decoder-only 模型的预训练目标是:
预测下一个 token这个目标非常通用。
- 互联网上的大量文本、代码、对话、文档,都可以直接转化成训练数据。
- 相比需要人工标签的监督任务,next-token prediction 可以自然利用海量无标注数据。
- 大模型能够由此通过 scaling law 不断扩展
2. 生成能力天然统一
很多任务都可以统一成生成问题。
例如:
问答:问题 → 答案
翻译:源语言 → 目标语言
摘要:长文本 → 摘要
代码:需求 → 代码
推理:题目 → 解题过程与答案
工具调用:用户请求 → 函数调用 JSON- 只要任务能写成 prompt,decoder-only 模型就可以通过继续生成来完成。这让它非常适合 instruction following 和 chat assistant 场景。
3. 容易衔接指令微调和偏好对齐
预训练之后,模型可以通过 instruction tuning 学会遵循人类指令。
例如训练样本可以写成:
User: 请解释什么是梯度下降。
Assistant: 梯度下降是一种优化算法……
这本质上仍然是 next-token prediction。 后续的 SFT、RLHF、DPO、RLAIF、reasoning RL 等方法,也都可以在 decoder-only 基础模型之上继续进行。这使得decoder-only 架构可以非常自然地从预训练过渡到助手模型。
4. 推理时可以使用 KV Cache
自回归生成时,模型每次只生成一个新 token。如果每次生成都重新计算整个上下文,成本会非常高。
因此 decoder-only 模型通常会缓存之前 token 的 Key 和 Value,这就是 KV cache。
KV cache 让长文本生成变得更高效。但它也引出了新的问题:
“ 上下文越长,KV cache 越大。 ”
这直接推动了后来的很多 attention 优化,例如:
MQA
GQA
KV cache compression
PagedAttention
Sliding Window Attention
也就是说,decoder-only 成为主流之后,推理效率和长上下文成本开始成为架构优化的重要驱动力。
现代 LLM 的组件
虽然现代大模型大多采用 decoder-only 架构,但它们内部仍然可以拆成多个核心组件。
一个简化的现代 LLM 结构大概是:
Token IDs
  ↓
Tokenizer / Vocab
  ↓
Token Embedding
  ↓
Transformer Blocks:
    PreNorm
    Attention with RoPE / GQA / QK-Norm
    Residual Connection
    PreNorm
    FFN with SwiGLU or MoE
    Residual Connection
  ↓
Final Norm
  ↓
LM Head
  ↓
Next-token logits
我们可以把现代 LLM 的架构拆成下面几类组件。
1. Vocab、Tokenizer、Embedding 与 LM Head
模型首先需要把文本变成 token。
例如:
"Transformer is powerful"会被 tokenizer 切成若干 token id:
[872, 12345, 318, 4567]这些 token id 会被映射成向量,这一步就是 token embedding。
最后,模型还需要通过 LM Head 把 hidden state 映射回词表空间,得到每个 token 的预测概率。
这一部分看起来只是“查表”和“线性分类”,但实际上隐藏着很多重要问题:
- 词表多大合适?
- input embedding 和 output LM head 是否共享?
- 大词表会带来多少参数成本?
- 大模型为什么有时反而不共享 embedding?
- 未来能不能设计更小、更高效的 tiny embedding?
2. Positional Encoding
Attention 本身并不知道 token 的顺序。
如果没有位置编码,模型很难区分:
狗咬人
人咬狗
原始 Transformer 使用正弦位置编码。
后来的模型又出现了很多不同方案:
Learned Absolute Position Embedding
Relative Position Bias
RoPE
ALiBi
NTK Scaling
YaRN
现代长上下文模型中,位置编码尤其关键。
因为上下文长度已经从早期的几百、几千 token,扩展到:32K、128K、1M+
但是,长上下文不是简单地把位置编码拉长就能解决的。它同时涉及:
- 位置外推能力
- attention 计算成本
- KV cache 显存成本
- 长上下文训练数据
- 长距离检索能力
- 模型是否真的会使用远处信息
所以 positional encoding 是现代 LLM 架构演进中的关键模块之一。
3. Attention
Attention 是 Transformer 的核心。
原始 Transformer 使用 Multi-Head Attention。多个 attention head 可以让模型从不同角度建模 token 之间的关系。
但是现代大模型遇到了一个非常实际的问题:
“ 推理时 KV cache 太大。 ”
在标准 Multi-Head Attention 中,每一层、每一个 head 都需要缓存历史 token 的 K 和 V。当模型变大、层数变多、上下文变长时,KV cache 会迅速成为推理显存瓶颈。
因此出现了:
Multi-Query Attention
Grouped-Query Attention
KV Cache Compression
FlashAttention
Sliding Window Attention
Sparse Attention
QK-Norm
MLA 类结构
这些方法的目标并不完全相同:
- 有些是为了减少 KV cache;
- 有些是为了提升推理吞吐;
- 有些是为了降低 attention 显存;
- 有些是为了增强长上下文稳定性;
- 有些是为了提升大模型训练稳定性。
因此,现代 attention 已经不只是原始论文中的 MHA,而是变成了一个同时服务于能力、效率和稳定性的复杂模块。
4. FFN
Transformer block 中除了 attention,另一个重要组件是 FFN。
原始 Transformer 使用ReLU FFN。后来很多模型使用GeLU FFN
而现代 LLM 中更常见的是:
SwiGLU FFNFFN 在大模型中非常重要,因为它通常占据大量参数。
可以粗略理解为:
“ Attention 负责 token 之间的信息交互,FFN 负责对每个 token 的表示进行复杂非线性变换。 ”
很多研究和经验都表明,FFN 层对模型的知识存储、模式变换和能力表达非常重要。
因此,FFN 的演进不仅是激活函数从 ReLU 换成 SwiGLU,它背后反映的是:
“ 模型如何用更高效的方式增加非线性表达能力。 ”
5. MoE
MoE,全称是 Mixture of Experts。它是近年来大模型扩展的重要路线。
普通 dense 模型中,每个 token 都经过同一套 FFN。MoE 模型中,有很多个 expert,每个 token 只被路由到其中少数几个 expert。
例如:
64 个 experts
每个 token 激活 top-2 experts
这样模型可以拥有很大的总参数量,但每个 token 实际激活的参数量相对较小。 也就是说,MoE 试图解决的问题是:
“ 如何增加模型容量,而不同比例增加每个 token 的计算量? ”
这对于大规模模型非常重要。但是 MoE 也带来了新的复杂性:
- router 怎么训练?
- expert 会不会负载不均衡?
- expert collapse 怎么避免?
- 多机训练中的 all-to-all 通信成本如何处理?
- 推理时 batch 较小时是否真的高效?
- 是否需要 shared expert?
- 前几层是否应该保持 dense,也就是 first-K-dense?
所以 MoE 不只是一个简单的“参数变多技巧”,其实是一整套稀疏计算架构。
6. Normalization 与 Residual
Normalization 和 residual connection 决定了深层 Transformer 是否容易训练。
原始 Transformer 使用 Post-LayerNorm:
x = LayerNorm(x + Sublayer(x))现代 LLM 更常用 PreNorm:
x = x + Sublayer(Norm(x))同时,很多模型从 LayerNorm 转向 RMSNorm。
典型现代结构是:
x = x + Attention(RMSNorm(x))
x = x + FFN(RMSNorm(x))
这样做的核心原因是:
“ 深层大模型训练需要更稳定的梯度传播。 ”
模型越深、参数越大、训练步数越长,normalization 和 residual 的设计越关键。在小模型中看起来只是细节的问题,在千亿级参数模型中可能会直接决定训练是否稳定。
现代优化的需求来源
现在我们可以回答一个更本质的问题:
“ 为什么 Transformer 的这些组件都需要被优化? ”
图 2 架构参数量的增大
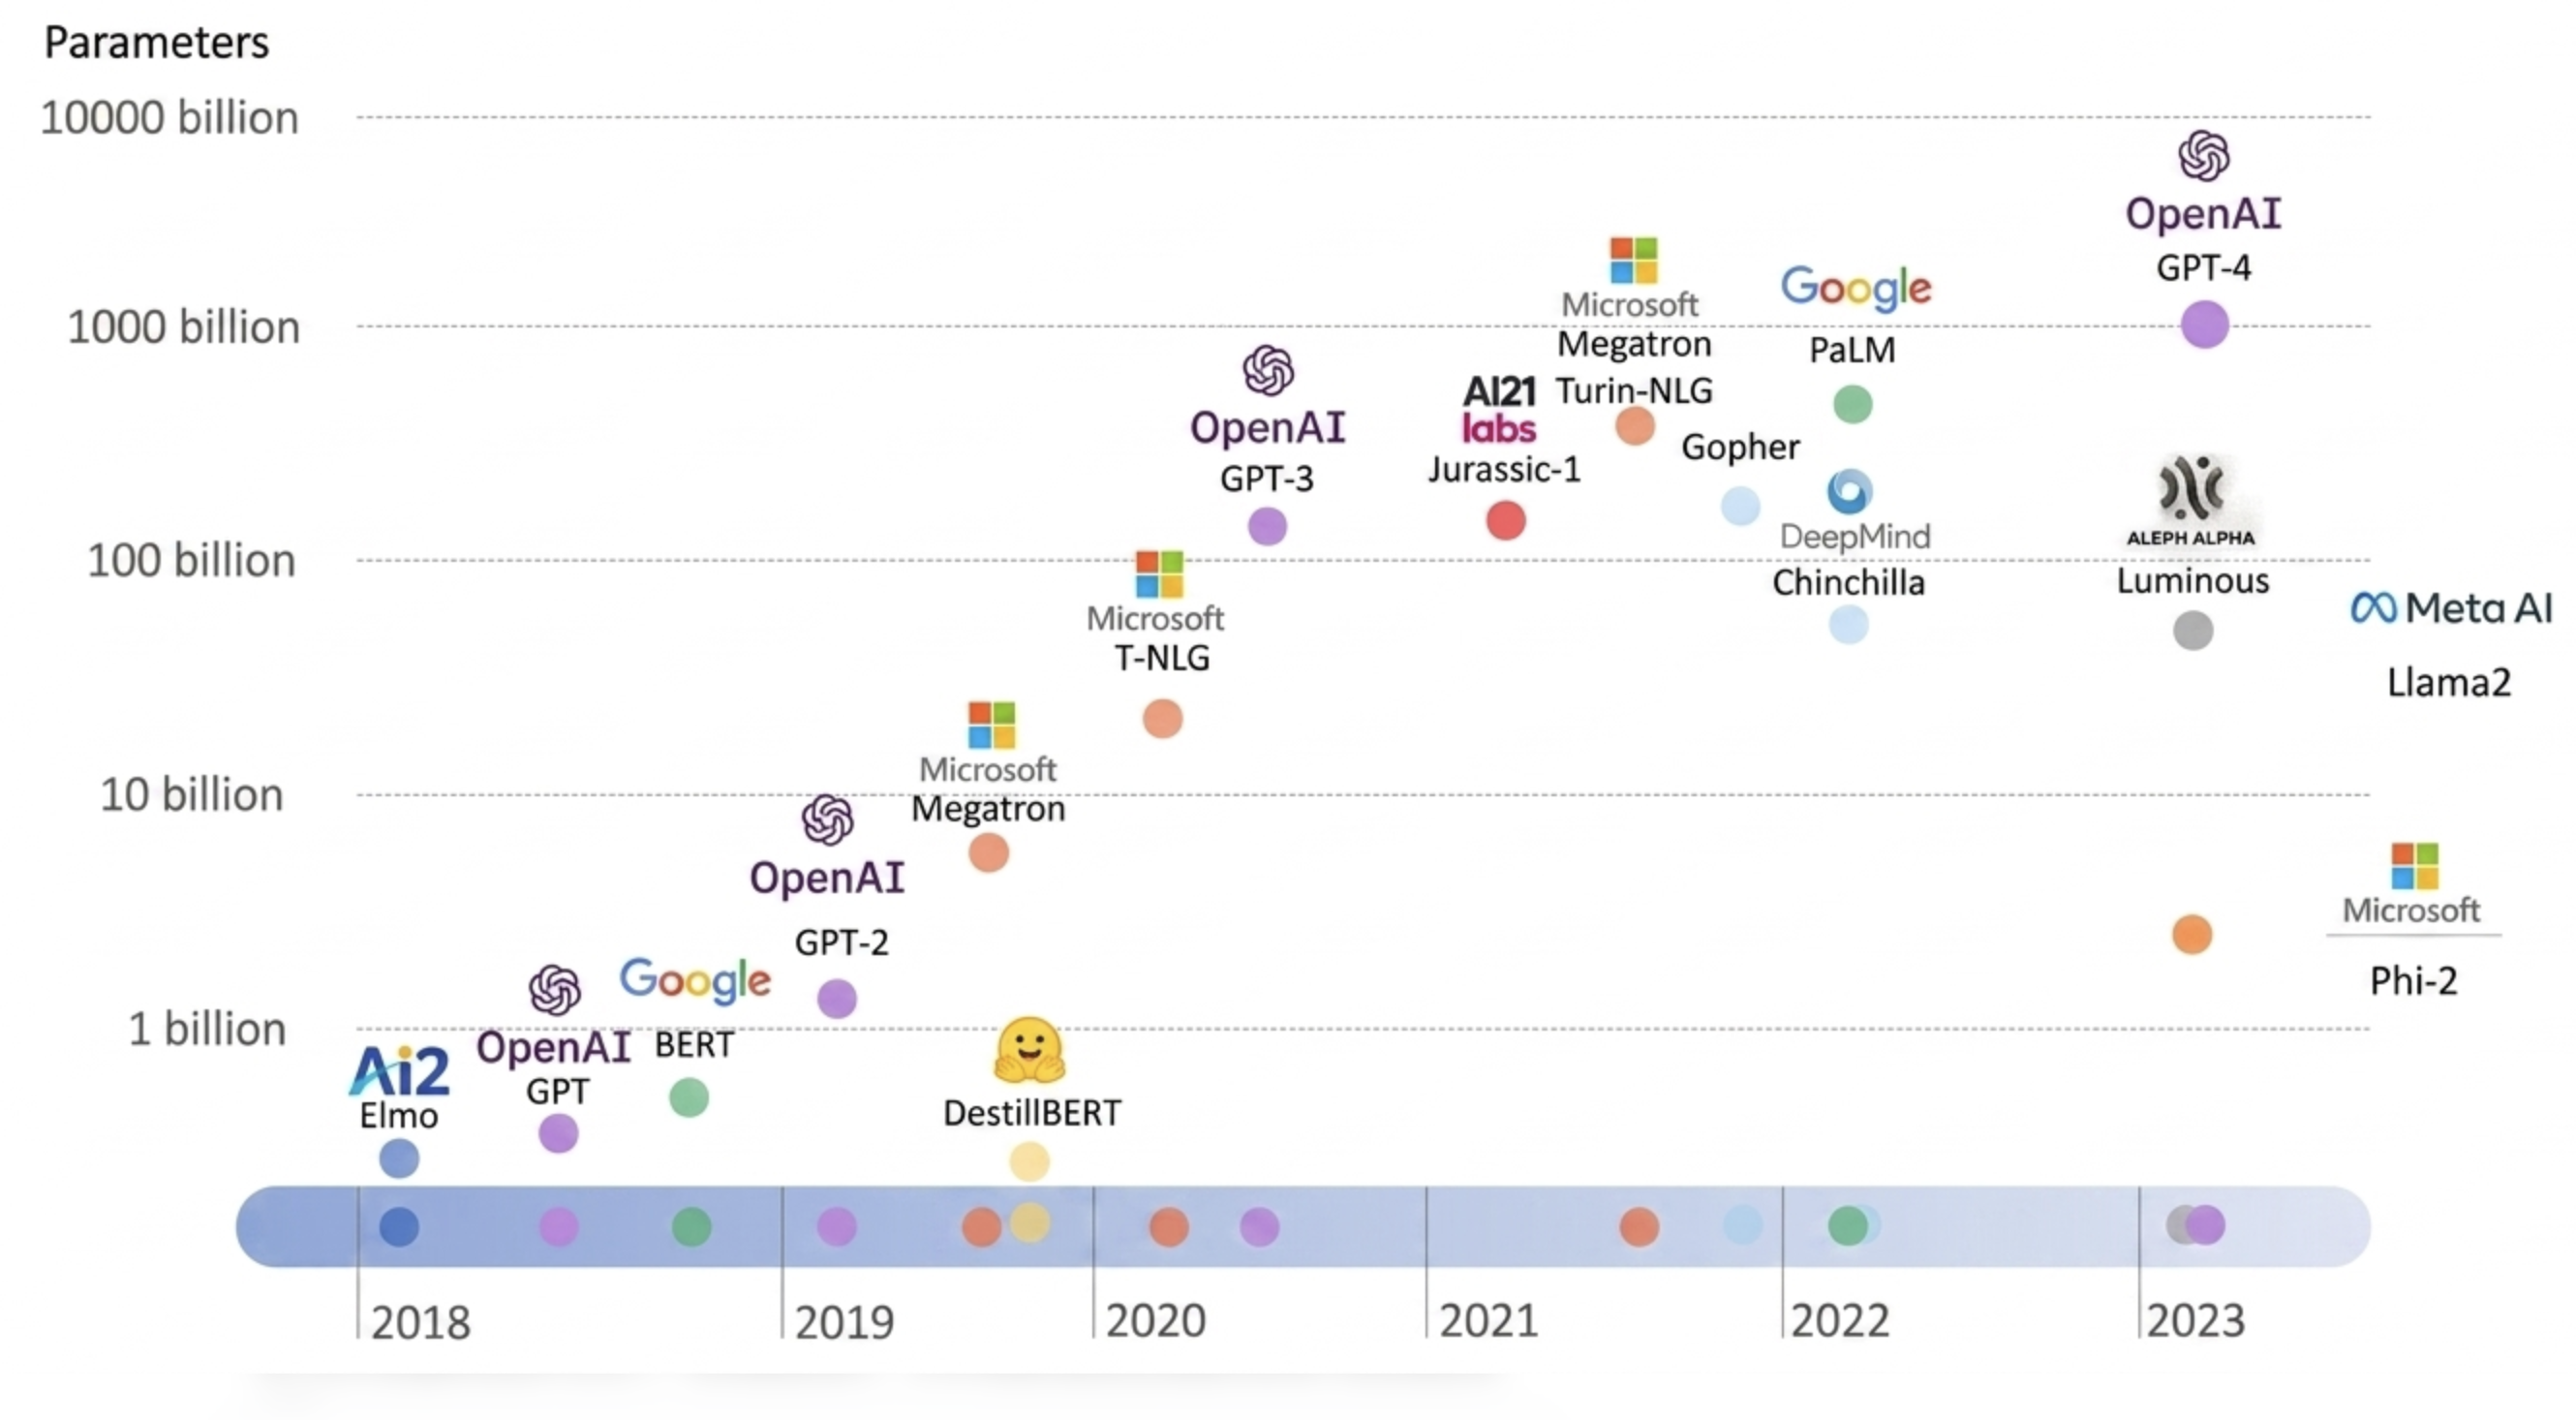
笔者个人理解的原因是大模型的发展不断制造新的需求压力。
1. 模型规模变大
2017 年的 Transformer 和今天的大模型不是一个量级。
-
当模型越来越大时,会出现:
- 训练更不稳定
- 梯度更难控制
- 激活值更容易异常
- 学习率和初始化更敏感
- 显存和通信压力更大
因此需要新的组件:
PreNorm
RMSNorm
QK-Norm
Residual Scaling
Better Initialization
MoE
这些方法本质上都是为了让更大的模型可以稳定训练。
2. 上下文变长
早期 Transformer 的上下文长度通常比较短。
-
但是现代模型需要处理:
- 长文档
- 多轮对话
- 代码仓库
- 法律合同
- 科研论文
- agent memory
- 工具调用历史
这推动了以下组件的出现:
RoPE
NTK Scaling
YaRN
GQA
Sliding Window Attention
Sparse Attention
KV Cache Optimization
长上下文是一个系统能力。它要求位置编码、attention 机制、训练数据和推理系统一起配合。
3. 推理成本变高
大模型不仅要训练出来,还要能服务用户。(需求是很重要的)
-
推理阶段的主要瓶颈包括:
- 模型权重显存
- KV cache 显存
- decode latency
- batch throughput
- 多用户并发
- 长上下文成本
因此出现了:
GQA
MQA
Quantization
PagedAttention
Continuous Batching
Speculative Decoding
Distillation
现代 LLM 架构设计已经不能只考虑训练效果,还必须考虑部署成本。一个模型即使训练指标很好,如果推理成本过高,也很难成为真正可用的产品级模型。
4. 表达能力要求更强
-
现代模型要处理的任务越来越复杂:
- 数学推理
- 代码生成
- 多语言理解
- 长文本分析
- 工具调用
- 结构化输出
- 多模态理解
这推动了以下优化方式的出现:
SwiGLU
MoE
Larger FFN
Better Data Mixture
Reasoning Post-training
其中 MoE 是一个典型例子。优化是为了在可控计算成本下增加模型容量。
5. 模型从语言模型变成助手
原始语言模型只需要学会预测下一个 token。
-
但现代助手模型还需要:
- 遵循指令
- 拒绝不安全请求
- 保持对话风格
- 使用工具
- 输出结构化结果
- 进行多步推理
- 在不确定时表达不确定
这推动了:
Instruction Tuning
RLHF
DPO
RLAIF
Tool-use Tuning
Reasoning RL
(严格来说,这些不完全属于 Transformer block 内部的架构优化。但是它们决定了模型最终呈现出来的行为。)
因此,理解现代 LLM 时,不应当只看模型结构,还要看训练目标和后训练方法。
从 2017 Transformer 到现代 LLM
“ 我们先在这里总结一下涉及到的主流内容: ”
| 模块 | 2017 Transformer | 现代 LLM 常见做法 | 主要原因 |
|---|---|---|---|
| 架构 | Encoder-Decoder | Decoder-only 为主 | 通用生成、扩展简单 |
| Embedding | 输入/输出多为独立权重 | tied 或 untied,视规模而定 | 参数效率与表达能力权衡 |
| Position | Sinusoidal PE | RoPE、NTK Scaling、YaRN | 相对位置建模与长上下文 |
| Attention | Multi-Head Attention | MQA、GQA、QK-Norm | 降低 KV cache,增强稳定性 |
| FFN | ReLU FFN | GeLU、SwiGLU | 更强非线性表达 |
| Capacity | Dense | Dense 或 MoE | 更大容量,更低激活计算 |
| Normalization | Post-LayerNorm | PreNorm、RMSNorm | 深层训练稳定 |
| Context | 较短 | 32K、128K、1M+ | 长文档、代码、agent 场景 |
| Training | 监督翻译为主 | 大规模 next-token pretraining | 通用语言建模 |
| Post-training | 基本没有 | SFT、RLHF、DPO、RL | 指令遵循与偏好对齐 |
| Inference | 常规解码 | KV cache、量化、spec decoding | 降低服务成本 |
如何展开?
这个系列会按照组件逐一展开。示例如下:
1. 这个组件在 Transformer 中负责什么?
2. 原始 Transformer 是怎么做的?
3. 随着模型变大、上下文变长、部署变复杂,它遇到了什么问题?
4. 后续出现了哪些变体?
5. 每个变体解决了什么问题?
6. 它带来了什么代价?
7. 它适合用在什么场景?
8. 当前前沿趋势是什么?
小结
“ 从 2017 年的 Transformer 到今天的现代大模型,最重要的变化不局限于某一个单点技巧,而是整个架构在大规模训练和大规模部署中的系统性进化。 ”
- Transformer 的骨架仍然是:
Attention
+ FFN
+ Residual
+ Normalization- 但是每个部分都被重新设计优化过:
Embedding 更关注参数效率和词表表达;
Position Encoding 更关注长上下文;
Attention 更关注 KV cache、吞吐和稳定性;
FFN 更关注非线性表达;
MoE 更关注容量扩展;
Normalization 更关注深层训练稳定;
Inference 更关注服务成本;
Post-training 更关注助手行为。
所以,笔者认为理解现代大模型最好的方式,不是孤立记忆,而是建立一张架构图。我们得以了解到:
“ 现代 LLM 以Transformer为主干,围绕规模、上下文、效率、稳定性和能力进行大量针对性的组件级重构。 ”
笔者的话
“ 非常兴奋我们将要开始讲一段新的故事,我预感到这将是一个长长的系列,笔者这次要更加负责一点,回到最原始的文献去看每一个架构的诞生,会做的尽量更加仔细,希望能对你有帮助。有任何建议或者想要补充以及后续有兴趣看的架构组件部分可以练习笔者,十分欢迎👏 ”
参考文献
这里涉及到了部分后续解析的时候会详细讲到的内容以及相关涉及到的论文
- Vaswani et al., 2017. Attention Is All You Need.
- Devlin et al., 2018. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding.
- Radford et al., 2018. Improving Language Understanding by Generative Pre-Training.
- Radford et al., 2019. Language Models are Unsupervised Multitask Learners.
- Raffel et al., 2020. Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer.
- Lewis et al., 2020. BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension.
- Kaplan et al., 2020. Scaling Laws for Neural Language Models.
- Brown et al., 2020. Language Models are Few-Shot Learners.
- Hoffmann et al., 2022. Training Compute-Optimal Large Language Models.
- Su et al., 2021. RoFormer: Enhanced Transformer with Rotary Position Embedding.
- Zhang and Sennrich, 2019. Root Mean Square Layer Normalization.
- Shazeer, 2020. GLU Variants Improve Transformer.
- Shazeer, 2019. Fast Transformer Decoding: One Write-Head is All You Need.
- Ainslie et al., 2023. GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints.
- Fedus et al., 2021. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity.
- Dao et al., 2022. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness.