深度学习|发展脉络与学习路线图
阅读提示: 笔者做了一直想做的内容,感觉我有点想个科普学家,马上要考试了,我还没推完RoPE的内容,暂且先整理这些内容吧。由于一直对整个领域的内容缺乏一个全面系统的清晰了解,所以一直想着整理相关的深度学习的东西,也只是一个比较粗浅的介绍。但也许对每个人这都会有些帮助。祝食用愉快~🤩
图 1 深度学习
前引:机器学习
什么是机器学习
“ 在深度学习出现之前,人类已经在研究如何让计算机“从数据中学习规律”这件事上探索了数十年。核心思想出奇地简单:我们收集了一堆输入(比如病人的年龄、血压、肿瘤大小)和对应的输出(比如是否复发),想要找到一个函数 ,让 。这个寻找的过程,就叫机器学习。 ”
-
而机器学习大致分为三类:
- 监督学习(Supervised Learning):有标准答案。你给模型一堆“问题+答案”,让它学规律。比如预测房价、识别垃圾邮件、诊断肿瘤良性/恶性。
- 无监督学习(Unsupervised Learning):没有标准答案。你给模型一堆数据,让它自己发现结构。比如把患者分成几个亚群、把高维数据压缩到2D平面上画图。
- 强化学习(Reinforcement Learning):通过试错和奖励来学习。模型(智能体)在环境中学着做动作,做对了给糖,做错了挨打。AlphaGo 就是这条路。
线性回归
“ 如果输出是一个连续数字(比如房价、肿瘤大小、血糖值),最简单的假设就是:输出和输入之间是线性关系。也就是说,所有输入特征加权求和,再加上一个偏置,就是预测值。 ”
公式(线性回归模型):
损失函数(均方误差,Mean Squared Error):
解析解(当数据量不大时,可以直接算出来的最优解):
-
解释:
- 是输入特征向量(如 [年龄, 血压, 肿瘤直径])
- 是权重向量,每个特征对预测结果的“贡献度”
- 是偏置,即当所有输入为0时的基准值
- 是损失函数,计算预测值和真实值之间的平方误差平均值。为什么用平方?因为误差有正有负,平方后都变正,且对大误差惩罚更重(离群点会更显眼)
- 解析解 是矩阵的协方差结构,逆矩阵求解等价于找到让整体误差最小的闭式解
“ 线性回归是几乎所有预测问题的基准线(Baseline)。如果一个问题连线性回归都打不过,哈哈哈说明你搞了个花里胡哨的模型但并没有什么真正的进步。它的优点是可解释性极强。 ”
逻辑回归
“ 很多医学问题不是预测一个数值,而是二选一:良性/恶性,阳性/阴性,复发/未复发。线性回归直接输出一个范围无限的数字,不太适合表示概率。于是统计学家在1958年(没错,和感知机同一年)发明了一个巧妙的办法:把线性输出通过一个S型函数(Sigmoid)压缩到0和1之间,把它当作“概率”。 ”
公式(逻辑回归):
损失函数(交叉熵损失,Cross-Entropy Loss):
-
解释:
- 是 Sigmoid 函数,输出永远在 之间,当 时接近1,当 时接近0
- 表示“给定输入 ,输出为1的概率”
- 交叉熵损失衡量的是“预测概率分布”和“真实分布(0或1)”之间的差异。如果你预测恶性概率是99%(),而真实就是恶性(),损失很小;如果你预测1%()而真实是恶性,损失会爆炸性增长(因为 是一个绝对值很大的负数,前面还有负号)
- 逻辑回归在医学领域被使用了几十年。它简单、可解释、对数据量要求不高。在罕见病研究中,如果你只有100个病例、20个临床指标,用一个深度神经网络纯属大炮打蚊子,而且极易过拟合。逻辑回归配合正则化(L1/L2)可以稳健地告诉你哪些指标(如“LDH水平”、“特定基因突变”)对诊断罕见病最有判别力。
支持向量机(SVM)
“ 线性回归和逻辑回归都在试图画一条分界线把两类分开。但如果有无数条直线都能分开数据,哪一条才是最好的?直觉上,你应该选那条“离两边数据点都最远”的线——因为中间地带最宽,容错率最高,对新数据的泛化能力最强。 ”
支持向量机(Support Vector Machine, SVM) 的核心思想就是:最大化间隔(Maximize Margin)。
公式(SVM 的优化目标,软间隔版本):
-
解释:
- 是权重向量的模长平方,最小化它等价于最大化间隔宽度(因为间隔宽度与 成反比)。这相当于“让分类通道尽可能宽”
- 是 Hinge Loss(合页损失)。如果样本被正确分类且离边界超过1个单位,损失为0;如果在边界附近或分错了,损失线性增长
- 是正则化系数,控制“对错误样本的惩罚力度”。 越大,越不能容忍分错; 越小,越追求宽通道,允许一些异常值被误分
核技巧(Kernel Trick): SVM 还有一个杀手锏。如果数据在二维平面上线性不可分(比如一类在内圈,一类在外圈),SVM 不用像神经网络那样加很多层,而是用一个核函数(Kernel Function) 直接把数据映射到更高维度。你会发现在高维空间里,不可分的数据可能突然变得可分了。
高斯核函数(RBF Kernel):
-
解释:
- 这个公式计算两个样本之间的“相似度”。如果两个样本很接近,核函数值接近1;如果相距很远,值接近0
- 它隐含地把数据映射到了一个无穷维的空间,在这个空间里几乎任何数据都是线性可分的
- 最神奇的是:我们不需要显式计算这个无穷维映射,只需要在原空间计算这个核函数值就够了——这就是核技巧的魔力
- 在2000年代到2010年代初,SVM 是机器学习界的绝对王者。在图像分类(ImageNet之前)、文本分类、生物信息学(基因表达数据分类)上,SVM + 手工设计特征(如SIFT、HOG)是标准配置。它的数学优雅、泛化界有理论保证、对小样本效果好。在医学影像的早期应用中,SVM 经常用来对提取好的特征(如纹理、形态学指标)做分类。
决策树与随机森林
“ 线性模型和SVM都假设决策边界是某种光滑曲线(直线或超平面)。但现实世界的决策往往像流程图一样:先看年龄是否大于50,再看血压是否高于140,再看肿瘤标记物是否超标,一步步分支下去。决策树(Decision Tree)就是来干这个的。 ”
概念: 决策树通过递归地选择最优划分特征和划分阈值,把数据分到越来越小的子集里,直到子集足够“纯净”(里面几乎都是同一类)。
信息增益(Information Gain):
其中熵(Entropy)定义为:
-
解释:
- 是数据集 的熵,衡量混乱程度。如果数据集中正负样本各占50%,熵最大(最混乱);如果100%是同一类,熵为0(最纯净)
- 是用特征 划分数据后,熵减少了多少。减少得越多,说明这个特征越有用
- 决策树贪婪地选择信息增益最大的特征和阈值进行划分,递归构建
随机森林(Random Forest):
“ 一棵决策树容易过拟合(对训练数据死记硬背,新数据一来就傻眼)。那“既然一棵树不靠谱,那就造一片森林。” ”
- Bagging(自助聚合):从原始数据中有放回地随机抽取多个子集,每个子集训练一棵决策树
- 随机特征子集:在每个节点划分时,不考察所有特征,只随机选一小部分特征来挑最佳划分
- 投票:所有树各自给出分类结果,多数票胜出(分类)或取平均(回归)
- 随机森林在表格型医学数据(如电子病历、实验室检查结果、基因突变位点)上表现极佳。它不需要你标准化数据,能自动处理非线性关系和特征交互,而且天然告诉你哪些特征最重要(通过统计每棵树里各特征被用于划分的次数和带来的纯度提升)。在罕见病研究中,这往往比黑盒神经网络更受临床医生欢迎——医生需要知道“为什么模型说这个孩子是罕见代谢病?因为它发现血乳酸和丙酮酸比例异常,且同时伴有某种基因变异”,而随机森林的决策路径本身就是这样的解释。
梯度提升树
“ 如果说随机森林是“多个弱学习器并行投票”,那么梯度提升树(Gradient Boosting Decision Trees, GBDT)就是“多个弱学习器串行纠错”。核心思想极其精妙:第一个树做出一个粗糙预测,第二个树专门学习第一个树的错误,第三个树学习前两个树的残留错误,以此类推,最后把所有树的结果加起来,得到精准预测。 ”
公式(加法模型,Additive Model):
其中第 棵树拟合的是负梯度(伪残差):
-
解释:
- 是最终模型,由 棵弱决策树 加权求和组成
- 每棵新树不看原始标签 ,而是看当前模型的预测误差(残差 )
- 这个残差实际上就是损失函数对当前预测值的负梯度,所以叫“梯度提升”
- 新树的目标就是把这些残差拟合得尽量小,从而逐步修正总体的偏差
XGBoost / LightGBM: GBDT 的思想出现得很早,但2014年陈天奇的 XGBoost 和后来的 LightGBM 通过工程优化(正则化、二阶泰勒展开近似、直方图加速、按叶子生长而非按层生长)让它变成了 Kaggle 竞赛的核武器。在结构化数据上,精心调参的 XGBoost 经常能打败深度学习模型。
医学数据中有大量的结构化表格:血常规、生化指标、基因型、家族史、用药史。对这类数据,梯度提升树依然是2024年的黄金标准。原因:
- 它天然处理异质特征(连续的年龄和离散的基因突变 coexist)
- 对特征缺失值有优雅的处理(把缺失当作一个分裂方向)
- 对异常值比神经网络更鲁棒
- 训练快、需要数据少、可解释性强(SHAP值分析)
在罕见病研究中,很多数据集只有几百个病例但几百个特征(高维小样本),此时 XGBoost 配合正则化往往比深度学习更稳健。
无监督学习
不是所有数据都有标签。医生面对罕见病时,往往先遇到的困惑是:“这些患者表现出来的症状五花八门,他们真的是同一种病吗?还是其实分成好几个亚型?” 这时候没有“标准答案”,你需要无监督学习来发现数据中隐藏的结构。
K-means 聚类:“物以类聚”
公式(K-means 目标函数):
-
解释:
- 把数据分成 个簇(cluster), 是第 个簇中的样本集合
- 是第 个簇的中心(均值向量)
- 目标是最小化所有样本到其所属簇中心的距离平方和
- 算法反复迭代:先随机初始化中心→把每个样本分到最近的中心→重新计算中心→再分配……直到收敛
- 在医学中,K-means 常被用来发现疾病亚型。例如,把乳腺癌患者的基因表达数据聚成几类,可能发现一类对激素治疗敏感,另一类对化疗敏感,从而指导精准治疗。对罕见病,聚类可能发现“临床表现相似但基因背景不同”的几个亚群,提示它们可能是不同的疾病实体。
主成分分析(PCA)
“ 医学数据经常有几百个特征(基因表达、影像组学、生化指标),人脑无法直观想象。但是如果把数据投影到这些方向上,降到2D或3D,不就可以了吗? ”
公式(PCA的数学本质):
对数据矩阵 (已中心化)进行奇异值分解(SVD):
取前 个主成分( 的前 列)作为投影矩阵 ,降维后数据:
-
解释:
- 的列向量是主成分方向,即数据方差最大的方向
- 的对角线元素是奇异值,代表每个主成分上数据“展开”的程度。奇异值越大,说明这个方向承载的信息越多
- 降维后的 保留了原始数据的大部分方差(通常选前 个主成分,使累积方差贡献率>95%)
- PCA 不是随便压缩,而是无损压缩信息量的最优线性变换
PCA 在医学影像和组学中无处不在。比如把病理切片的成千上万个纹理特征降到10个主成分,然后做可视化或输入下游分类器。它可以去除多重共线性(特征间高度相关),减少噪声,防止维度灾难。
传统机器学习的“阿喀琉斯之踵”
“ 传统机器学习在表格数据、小样本、需要强可解释性的场景下依然强大,但它有几个结构性缺陷,正是这些缺陷催生了深度学习: ”
| 具体表现 |
|---|
| 模型本身不处理原始数据。图像必须先人工设计SIFT/HOG特征,文本必须先人工做TF-IDF/Bag-of-Words。这需要领域专家花数月。 |
| 图像有空间结构,文本有序列结构,语音有时间结构。线性模型和树模型把它们展平后,空间/序列关系全部丢失。 |
| SVM 在百万级数据上训练很慢;树模型在特征数爆炸时(如图像每个像素一个特征)根本没法工作。 |
| 单层/浅层模型对复杂函数(如“图像中有猫”)的逼近能力有限。 |
| 如何把图像特征向量 + 文本特征向量 + 音频特征向量融合?传统方法靠拼接后接SVM,很粗糙。 |
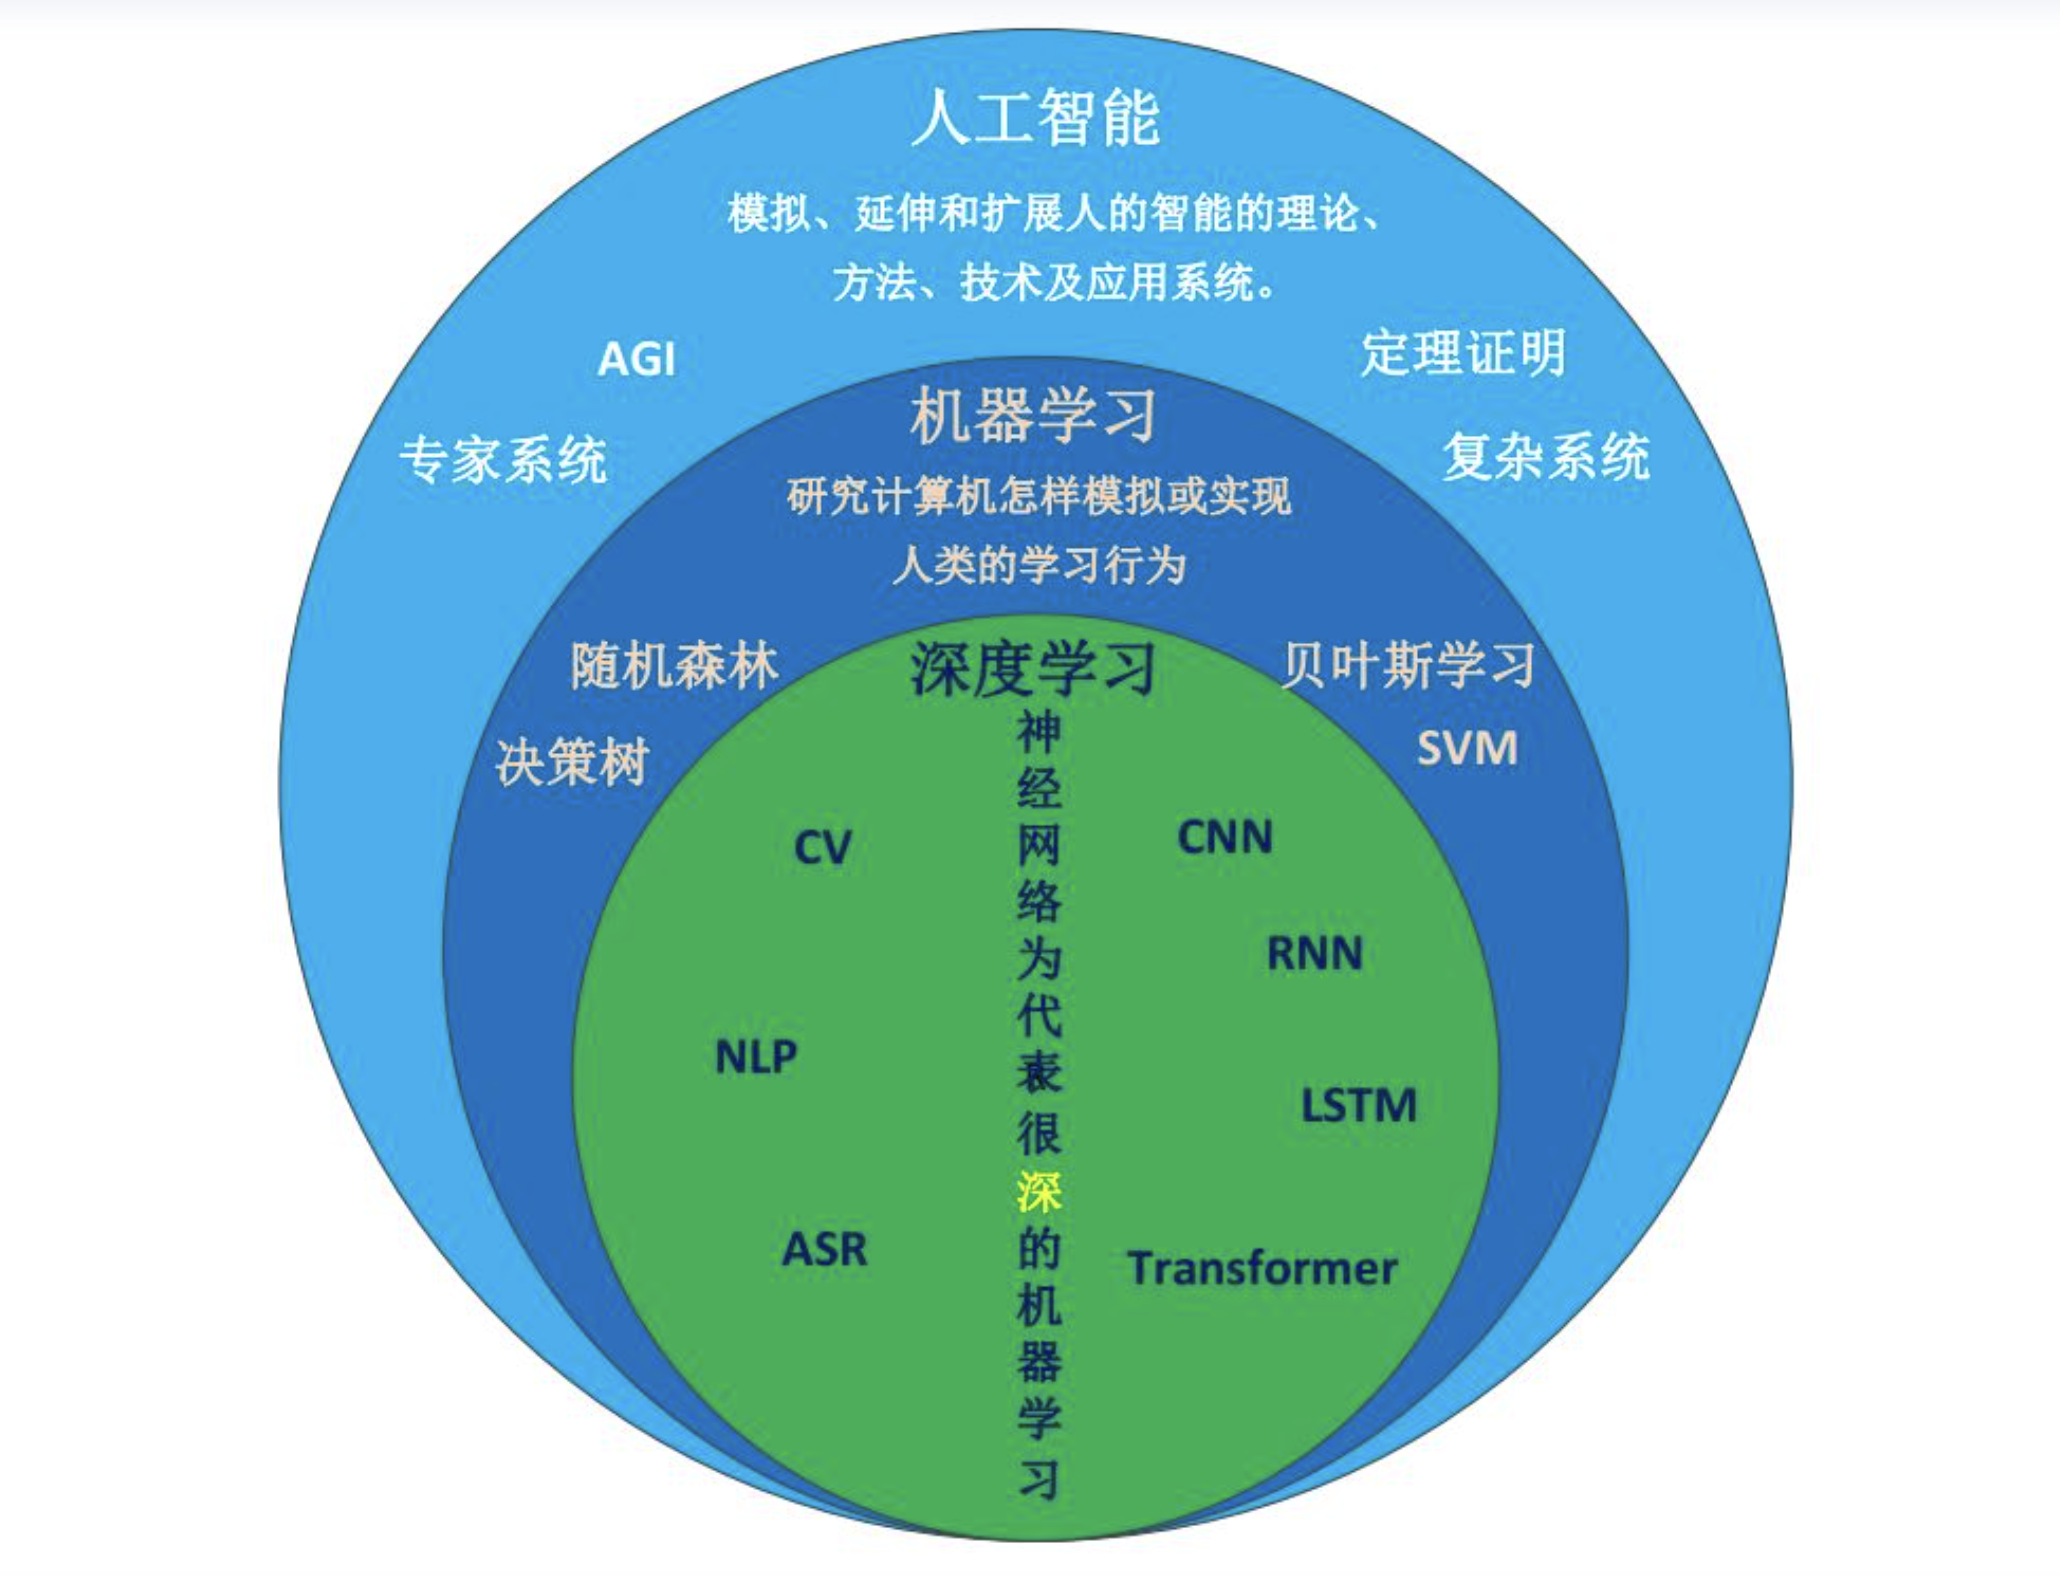
- 传统机器学习并没有消亡。也许我们可以这样看,恰恰相反,现代机器学习是一个光谱:左边是线性回归,中间是随机森林/XGBoost,右边是 Transformer/GPT。一个成熟的AI研究者应该根据数据形态选择你的武器:
图 2 AI领域的大体流派分类
“ 前戏有点长了,接下来让我们进入深度学习的领域 ”
一、感知机与神经网络
1.1 感知机(1958 年)
“ 在深度学习还没有这个名字的时候,一位叫 Frank Rosenblatt 的心理学家从 neurons(神经元)中汲取了灵感,于是他造出了感知机(Perceptron)——世界上第一个能“学习”的机器。 ”
- 感知机是一个二分类器。给它输入一组数字(比如一只猫的体重、尾巴长度、胡须密度),它输出 0(不是猫)或 1(是猫)。
- 现实世界的大量问题,本质上都是“是或否”的决策。邮件是不是垃圾邮件?图片里有没有人脸?肿瘤是不是恶性?这些都可以先被抽象成一个二分类问题。
- 核心公式(感知机决策规则):
-
解释:
- :第 个输入特征(比如胡须密度)
- :第 个特征的权重(胡须有多重要?)
- :偏置项(阈值,相当于“底线信心”)
- :符号函数,结果大于0输出+1,小于0输出-1
- 整个式子的意思是:把输入按重要性加权求和
“ 感知机只认线性——如果问题是“猫和狗”且两类可以被一条直线分开,他工作得很好;但如果问题需要一条曲线分界,就会一脸懵。这就是著名的线性不可分问题。感知机无法解决 XOR(异或)问题 ”
1.2 多层感知机(MLP)与反向传播(1986 年)
“ 为了能处理曲线分界,科学家们做了一件非常聪明的事:在中间加几个“传话层”(隐藏层)。每个隐藏层神经元先对输入做一次加权求和,再通过一个非线性激活函数(比如 Sigmoid)扭曲一下结果,再传给下一层。 ”
- 这就是多层感知机(Multi-Layer Perceptron)。它通过堆叠多个非线性变换层,把简单的线性分类器变成可以逼近任意复杂函数的万能拟合器。理论上,只要有足够的隐藏层神经元,它可以逼近任何连续函数。
- 而现实世界的规律很少是线性的。房价不随面积线性增长,肿瘤恶性概率不随细胞大小线性变化。非线性激活函数让网络可以学习弯曲的决策边界。
- 核心公式(单隐层神经元前向传播):
-
解释:
- 是线性加权后的结果(和感知机一样)
- 是 Sigmoid 激活函数,把任意实数压缩到 之间,形状像一条S型曲线
- 这个压缩操作引入了非线性:如果没有它,多层线性叠加本质上仍然只是一层线性变换
反向传播(Backpropagation):
“ 但怎么训练这个多层网络?1986年,Hinton 等人复兴了反向传播算法:从错误中学习,并把锅一层一层往前甩。 ”
- 损失函数(以均方误差为例):
然后用链式法则(Chain Rule)计算每一层权重对最终损失的梯度
详细可见我们的blog——Transformer反向传播系列!
-
解释:
- 这个式子表示“损失函数 对权重 的敏感度”
- 通过链式法则,我们可以从输出层(最靠近错误的地方)一直倒推到输入层(最前面的权重)
- 知道敏感度后,就可以更新权重:,其中 是学习率
1.3 从 Sigmoid 到 ReLU
“ Sigmoid 在很长时间内都是默认选择,但它有一个致命的缺陷:当输入很大或很小时,Sigmoid 的输出几乎不再变化(饱和),导致梯度接近0。在反向传播中,接近0的梯度意味着难以继续往下传播信息。 ”
于是,一个函数被引入:ReLU(Rectified Linear Unit)。
-
解释:
- 如果 ,输出 本身;如果 ,输出 0
- 优点是:正区间的梯度恒为1,不会饱和;计算极其简单(只需要比较和取最大)
- 缺点是:负区间永远输出0,可能导致某些神经元“死亡”(Dead ReLU)
二、卷积神经网络(CNN)
2.1 为什么 MLP 看不了图片?
“ 假设你有一张 1000×1000 像素的彩色照片。如果把它展平成一个向量输入给 MLP,输入维度是 。如果第一层有1000个神经元,权重矩阵的大小就是 亿个参数。这在30年前,连超级计算机都吃不消。 ”
一个更根本的问题是:MLP 不理解空间关系。它把像素展平后,上下相邻的像素和相距甚远的像素在输入向量中地位平等。但图像中,一个猫耳朵的像素和旁边的猫耳朵像素显然应该被一起考虑。
“ 图像具有局部相关性和平移不变性。一个检测“竖直边缘”的特征,不应该因为这张边缘出现在图片左上角还是右下角就改变检测方式。 ”
2.2 卷积
“ CNN(Convolutional Neural Network,卷积神经网络)引入了卷积核(Kernel/Filter) 的概念。卷积核是一个小矩阵(比如 或 ),它在整张图像上滑动,每到一个位置就和当地的像素做 逐元素相乘再相加。 ”
公式(二维离散卷积):
-
解释:
- 是输入图像, 是卷积核(大小为 )
- 是输出特征图上的位置
- 卷积核就像一块小印章,在图像上逐位置盖章,每个位置输出一个数值
- 这个数值反映了“该局部区域和卷积核模式的相似度”
-
用途:
- 参数共享:同一个卷积核扫描整幅图像,所以无论边缘出现在哪里,都用同一组参数检测。这大大减少了参数量。
- 局部连接:每个输出只依赖输入的一个小邻域,而不是全图。这符合图像的局部统计特性。
- 平移不变性:如果猫从图像左边移到右边,卷积核依然能检测到它,因为检测逻辑不依赖于绝对位置。
“ 而当它扫完整张图,就画出一张“竖线分布图”——这就是特征图(Feature Map)。 ”
2.3 池化(Pooling)
“ 卷积之后通常会接一个池化层(通常是 Max Pooling)。池化也是一个滑动窗口,但操作更简单:在每个窗口内取最大值(或平均值)。 ”
-
作用:
- 降维:把特征图尺寸缩小一半,减少后续计算量
- 抗干扰:如果猫的胡须稍微偏移了2个像素,Max Pooling 依然能捕获到这个特征,因为它只关心“这个区域有没有强响应”
- 扩大感受野:经过几轮“卷积+池化”后,深层的神经元实际上“看”的是原始图像上很大一片区域,而不是 的小格子
“ CNN 的奇妙之处在于,浅层卷积核学习低级特征(边缘、颜色、纹理),深层卷积核学习高级特征(眼睛、轮胎、人脸轮廓),更深层学习语义概念(猫、狗、汽车)。这就像一个人类视觉系统。 ”
2.4 从 LeNet 到 AlexNet 到 VGG
- LeNet(1998):Yann LeCun 设计,用于识别手写邮政编码。5层,几万个参数。它是CNN的“亚当和夏娃”。
- AlexNet(2012):Hinton 的学生 Alex Krizhevsky 设计,8层,6000万参数。在 ImageNet 图像分类竞赛上把错误率从 26.2% 降到 15.3%。这是深度学习的“ iPhone 时刻”。关键改进:ReLU + Dropout + GPU训练。
- VGG(2014):牛津大学,把网络加深到 16-19 层,全部使用 的小卷积核。证明了“深度”本身就是特征提取能力。
三、ResNet 与残差学习
3.1 网络越深,效果越差?
“ 按照直觉,如果 8 层的 AlexNet 很好,那 80 层应该已经让人看了就“瘫倒在椅子上”了吧? ”
但现实很残酷:当网络层数超过 20 层后,训练集准确率反而开始下降。这是优化问题。深层网络出现了梯度消失/爆炸:反向传播时,梯度连乘几十层,要么趋于 0,要么爆炸到无穷大。
“ 问题是:让网络直接学习“从输入到输出”的映射 ,对于深层网络来说真是太难了。 ”
3.2 残差学习
“ 2015年,何恺明(Kaiming He)等人提出了一个极其简单但违反直觉的想法:与其让网络学 ,不如让它学 ,也就是输入和输出之间的残差(Residual)。然后输出变成: ”
- 公式(残差块,Residual Block):
其中 是若干层卷积+激活的堆叠, 通过一条捷径(Skip Connection / Shortcut) 直接加到输出上。
-
解释:
- 是输入, 是输出
- 是“要学的残差映射”,如果最优映射就是恒等映射(identity),那 只需要学零映射(什么都不做),这比学一个复杂的变换容易得多
- 反向传播时,梯度可以通过 的捷径直接回传,永远不会完全消失
- 从优化角度,残差学习把问题简化了。如果增加层数没有帮助,残差块可以“选择”把权重推向0,让这层退化为恒等映射(),至少不会损害性能。
- 从梯度角度,捷径像一条高速公路,让梯度可以不经过任何中间层直接回流。这解决了深层网络的梯度消失问题。
3.3 ResNet 的成就
- ResNet 最深做到了 152 层(甚至后来有 1000+ 层的实验版),并在 ImageNet 上碾压了所有对手。
- ResNet 后来成为计算机视觉的默认骨架。从检测、分割到病理图像分析,ResNet 及其变体(DenseNet、ResNeXt 等)统治了视觉领域很多年,直到 Vision Transformer(ViT)出现。
四、RNN、LSTM 与 Seq2Seq
4.1 为什么 CNN 处理不了序列?
-
图像有空间结构,但语言、股票、DNA、心电图有的是时间或顺序结构。它们的特点是:
- 长度不固定(一句话可以3个字,也可以300个字)
- 上下文依赖(“它很好吃”中的“它”指代前文提到的某个名词)
- 顺序敏感(“我爱你”和“你爱我”意思完全不同)
“ CNN 对这种变长、顺序依赖的数据力不从心。虽然可以用 1D 卷积,但它只能捕获局部固定窗口,无法处理长距离依赖。 ”
4.2 RNN
“ RNN(Recurrent Neural Network)引入了一个核心概念:隐藏状态(Hidden State)。 ”
公式(RNN 前向传播):
-
解释:
- :第 时刻的输入(比如句子中第 个词的词向量)
- :上一时刻的隐藏状态(过去的记忆)
- :当前时刻更新后的隐藏状态(现在的记忆)
- :当前时刻的输出(比如预测下一个词)
- :权重矩阵,在所有时间步共享(参数共享)
- :激活函数,把记忆压缩到合理范围
- 参数共享意味着无论句子多长,模型的参数量不变。这解决了变长序列的问题。
- 隐藏状态理论上可以保留之前所有时间步的信息,使网络具备“记忆”。
4.3 长程依赖与梯度消失(再次)
“ RNN 在理论上能记住任意远的过去,但实践中,当序列较长时(比如100个词),反向传播经过100步的连乘,梯度会指数级衰减或爆炸。这意味着RNN 实际上只能记住最近几个时间步的内容,早期的信息几乎无法影响现在的决策。 ”
1997年,Hochreiter 和 Schmidhuber 发明了 LSTM(Long Short-Term Memory,长短期记忆网络),用一种复杂的门控机制来解决这个问题。LSTM 有三个门:输入门(决定放多少新信息进去)、遗忘门(决定擦除多少旧记忆)、输出门(决定输出多少当前记忆)。
LSTM 的公式比较复杂(涉及6个矩阵乘法和3个门控函数),核心思想是:给记忆加一个“保险箱”。重要的信息直接存进去,不受梯度连乘的影响;不重要的信息在门控下慢慢被遗忘。
GRU(Gated Recurrent Unit)是 LSTM 的简化版,合并了部分门,效果接近但参数更少。
4.4 Seq2Seq
“ RNN/LSTM 解决了一个序列的处理问题,但机器翻译需要两个序列:输入一句法语,输出一句英语。于是出现了 Seq2Seq(Sequence-to-Sequence) 架构: ”
- Encoder(编码器):一个 RNN 把输入句子(如法语)压缩成一个上下文向量(Context Vector)——一个固定长度的隐藏状态。
- Decoder(解码器):另一个 RNN 从这个上下文向量开始,一个词一个词地生成输出句子(如英语)。
- 但上下文向量是固定长度的。无论输入句子是5个词还是500个词,都要被压缩进同一个向量。这就像要求你无论读什么书,最后都只能用一段话来总结。500个词的信息显然会严重丢失。
“ 但是呢,这个痛点,催生了一个革命性发展——* ”
五、注意力机制
5.1 注意力机制的直觉
“ 我们知道,人类阅读时,眼睛不会均匀扫过每一个字。读到“猫坐在___上”时,你会在“垫子”、“椅子”、“键盘”几个词上多停留一会儿;读到不重要的虚词时,你会快速略过。 ”
注意力机制(Attention) 就是想让机器也学会这种“聚焦”能力。
5.2 注意力在 Seq2Seq 中的首次登场(2014)
“ Dzmitry Bahdanau 等人提出:解码器在生成每个输出词时,不应该只盯着那个固定的上下文向量,而应该回头去看编码器的所有隐藏状态,并决定“此刻我最需要关注输入的哪些部分”。 ”
公式(加性注意力 / Additive Attention):
其中注意力权重 由以下方式计算:
-
解释:
- :编码器第 个时间步的隐藏状态(输入句子中第 个词的“表征”)
- :解码器第 个时间步的隐藏状态(生成第 个词时的“状态”)
- :计算“此刻解码器状态 和编码器状态 有多配”
- :经过 Softmax 归一化后的注意力权重,总和为1
- :加权求和后的“上下文向量”,是此刻真正相关的输入信息的聚合
- 在翻译 “I love you” → “Je t’aime” 时,生成 “Je”(我)应该关注 “I”;生成 “t’aime”(爱你)应该关注 “love you”。注意力让解码器每一步都能动态选择看哪里。
- 这彻底解决了 Seq2Seq 的信息瓶颈问题:让输出方按需索取信息。
5.3 自注意力(Self-Attention)
“ 传统的注意力发生在编码器和解码器之间(Cross-Attention)。但很快研究者发现:为什么不把注意力用在输入序列内部?让句子中的每个词都去“看看”其他词,并根据语义相关性决定“我应该多关注谁”。 ”
这就是Self-Attention(自注意力)。它的核心是:一个词的语义,往往取决于它的上下文。“bank”在“river bank”和“bank account”中意思完全不同。通过自注意力,“bank”可以去看看左边是“river”还是“account”,从而调整自己的语义表征。
你们知道,它终于要出场了对吧?
六:Transformer
6.1 2017 年:《Attention Is All You Need》
“ Google Brain 的研究员们在2017年扔出了一篇论文,标题极其嚣张:“注意力就是你所需要的一切”。他们提出了 Transformer,一个完全抛弃 RNN 和 CNN,纯粹用注意力机制来处理序列的架构。 ”
这听起来像是疯狂之举——RNN 统治了序列模型20年,CNN 统治了图像模型5年,总是大胆呀,你居然说不要就不要了?
但 Transformer 做到了。它不仅在机器翻译上碾压了当时的 SOTA,更重要的是,它开启了大模型的时代。
6.2 Scaled Dot-Product Self-Attention
“ Transformer 的核心是自注意力层。它的工作方式比 Seq2Seq 的注意力更简洁、更强大。 ”
公式(缩放点积注意力,Scaled Dot-Product Attention):
-
解释(这是最重要的公式之一,虽然老生常谈,但请务必理解):
- (Query,查询):你可以把它理解为“我(当前词)想提问:谁和我有关?”
- (Key,键):序列中每个词提供的“身份标签”——“我有什么信息可以提供?”
- (Value,值):序列中每个词实际携带的“语义内容”
- :计算查询和键的匹配程度(点积)。点积越大,表示相似度越高。
- :缩放因子。 是键向量的维度。当维度很大时,点积的数值会非常大,导致 Softmax 进入极端饱和区(梯度消失)。除以 可以保持数值稳定。
- :把匹配分数变成概率分布(总和为1),得到注意力权重
- 最后乘以 :根据注意力权重,从所有值向量中加权提取信息
- 全局视野:每个词在一层内就可以和所有其他词直接交互。而 RNN 需要一步一步传递,100个词需要100步;Transformer 只需要1层(虽然计算量是 )。
- 并行计算:RNN 必须按顺序计算(因为 依赖 ),无法并行。Transformer 计算每个词的注意力时,可以同时在GPU上计算所有位置。
- 长程依赖不再是问题:“远距离”的词和“近距离”的词在注意力计算中地位平等。第1个词和第100个词的点积,跟第99个词和第100个词的点积一样直接。
6.3 多头注意力(Multi-Head Attention)
“ 单一的注意力机制可能只能捕获一种关系。比如一个词只能问“谁和我是主谓关系?”。但语言中有多重关系:主谓、动宾、修饰、指代、共指等等。 ”
Multi-Head Attention 的想法很朴素:我们与其只开一次会议,不如同时开 场会议(通常 或 16),每场会议关注不同的关系模式。最后再把这些会议的结果拼接起来。
-
解释:
- :第 个“头”的投影矩阵,把原始的 投影到不同的子空间
- 每个 head 独立计算注意力,捕获不同的语义关系
- 最后 Concat 拼接,再用 线性投影融合
6.4 位置编码(Positional Encoding)
“ RNN 天然知道顺序,因为它一步一步读内容。但是Transformer 一次性看所有词,对位置不敏感。“我爱你”和“你爱我”对它来说,如果词向量相同,初始计算结果完全一样! ”
所以 Transformer 给每个词的位置加了一个位置编码(Positional Encoding),原始的架构通常是正弦/余弦函数:
-
解释:
- 是词在序列中的位置(0, 1, 2, …)
- 是维度索引
- 用不同频率的正弦/余弦波,让每个位置有一个独特的“位置指纹”
- 这个编码和词向量直接相加,让模型知道“这个词是在句首还是句尾”
“ 这部分内容可以详见——模型演进的Position Encoding 部分 ”
6.5 Transformer 的整体架构:编码器-解码器
-
Transformer 论文最初是为机器翻译设计的,包含左右两部分:
- Encoder(左):由 个相同的层堆叠,每层有 Multi-Head Self-Attention + Feed-Forward Network。只处理输入序列。
- Decoder(右):也由 个相同层堆叠,每层有 Masked Self-Attention(只能看已生成的词,不能偷看未来)+ Cross-Attention(看编码器的输出)+ Feed-Forward。
Feed-Forward Network(FFN)是一个简单的两层全连接网络:
也就是先升维(通常 到 ),再降维回来,中间用 ReLU。
LayerNorm 和残差连接:Transformer 的每一层都有 Add & Norm(残差连接 + Layer Normalization)。残差连接就是 ResNet 的遗产;LayerNorm 是在特征维度上做归一化,保证训练稳定。
七、预训练与大模型
7.1 监督学习的瓶颈
“ Transformer 出来后,大家最初还是用它做监督学习:收集几万对“英法翻译句对”,训练模型。但标注数据太贵了。一个医学专家标注一份病历可能要30分钟,一台GPU训练一天要几百美元。而类比人类幼崽学语言,只需要听和读,不需要父母逐字逐句地“标注”哪句是正确翻译。 ”
一个想法出现了:为什么我们不让文本数据本身作为监督信号呢?
语言天然有结构:如果遮住句子中的一部分词,模型可以根据上下文猜出被遮住的词是什么。不需要人工标注,数据自己监督自己。
这就是自监督学习(Self-supervised Learning)。
7.2 BERT:双向编码器表征(2018)
“ Google 的 BERT(Bidirectional Encoder Representations from Transformers)是 Transformer Encoder 的纯熟运用。 ”
BERT 训练时,随机遮住输入句子中 15% 的词(比如用 [MASK] 替换),然后让模型根据上下文双向预测被遮住的词是什么。
训练目标(Masked Language Modeling, MLM):
-
解释:
- 从语料库 中采样句子
- 遮住其中一些词,记为
- 模型根据上下文 预测被遮住的词的概率分布
- 损失函数是负对数似然(Negative Log-Likelihood),也就是让模型给正确的词分配更高的概率
“ BERT 还同时训练了下一句预测(Next Sentence Prediction, NSP):给定两个句子A和B,判断B是不是A的下一句。这帮助模型学习句子间关系。 ”
- 双向上下文:预测“我爱吃[MASK]”中的
[MASK]时,BERT 可以同时看“我爱吃”和“和火锅”。而GPT(后面讲)只能从左往右看。 - 学到的表征是通用的语言理解向量。在下游任务(情感分析、问答、命名实体识别)中,只需要在BERT顶上接一个轻量层,微调少量参数即可。
7.3 GPT:生成式预训练(2018-2020)
“ OpenAI 走了另一条路。他们没有用双向Encoder,而是用了Transformer Decoder(只保留Masked Self-Attention,去掉Cross-Attention)。 ”
GPT 的核心思想:给定前面的词,预测下一个词。这叫自回归(Autoregressive) 建模。
训练目标(Autoregressive Language Modeling):
-
公式解释:
- :序列中第 个词(token)
- :第 个词之前的所有词(上下文)
- :给定前文,模型预测下一个词是 的概率
- 损失是所有位置的对数概率之和的负数(让模型尽可能给真实出现的词高概率)
- 生成能力:GPT 天生就是“写作者”。因为它训练时就在不停地“写下一个词”,所以它可以直接用来生成文本、代码、对话。
- 统一框架:理论上,任何任务都可以被格式化为“文本生成”。翻译 = “将英文翻译成法文:Hello → “;问答 = “问题:法国首都是?答案:”。只要提示(Prompt)写得好,模型不需要改结构就能做多种任务(Zero-shot/Few-shot)。
-
从GPT-1到GPT-3的跃迁:
- GPT-1(2018):1.17亿参数,Transformer Decoder,12层
- GPT-2(2019):15亿参数,24层,生成新闻文章几乎以假乱真
- GPT-3(2020):1750亿参数,96层,96层注意力头,在大量任务上不需要微调就能直接做(In-context Learning)
7.4 涌现能力(Emergent Abilities)与 Scaling Laws
“ 当模型参数从百万级推到十亿、百亿、千亿级时,研究者发现了一件神奇的事:模型不是线性变强,而是在某个规模阈值后突然“开窍”。 ”
比如,GPT-3 在 100 亿参数以下时,做三位数加法准确率接近 0;但超过某个阈值后,准确率突然飙升到 90% 以上。这种在规模临界点突然出现的、小模型完全没有的能力,被称为涌现能力(Emergent Abilities)。
同时Scaling Laws(缩放定律)是 OpenAI 在2020年提出的一个规律:
-
公式解释:
- :模型在测试集上的损失(Loss),越低越好
- :模型参数量
- :常数,通过实验拟合得到
- 这个公式表明:测试损失和模型规模之间存在幂律关系——只要模型够大、数据够多、算力够强,性能就会可预测地提升。
这给了工业界一个清晰的工程路线图:如果我想把错误率降低一半,我大概需要把模型扩大多少倍、数据扩大多少倍。hhh于是这直接推动了后来的“大模型军备竞赛”。
八、多模态与通用人工智能的雏形
8.1 Vision Transformer(ViT)(2020)
“ CNN 在图像界统治了8年,直到 Google 的研究者问了一个问题:既然 Transformer 在文本上这么强,为什么不直接用它处理图像? ”
ViT 的核心思想:把图像切成小块(Patch),把每个 patch 当作一个“词”(Token),然后直接输入 Transformer。
一个example的具体做法:一张 的图像,切成 的 patch,得到 个 patch。每个 patch 展平后通过线性投影成一个向量(比如768维),然后加入位置编码,输入标准的 Transformer Encoder。
-
解释:
- :第 个图像 patch 的像素向量
- :线性投影矩阵,把 patch 像素映射到 Transformer 的维度
- :一个可学习的分类 token(类似 BERT 的 [CLS]),最终用它做分类
- :位置编码,告诉模型每个 patch 在原图上的位置
- 统一架构:不再需要 CNN 和 Transformer 两套系统。文本和图像用同一个 backbone(Transformer),为多模态融合铺平道路。
- 全局注意力:CNN 的感受野需要很多层才能扩大;ViT 在第一层就可以让任意两个 patch 直接交互。
- 大数据优势:ViT 在中小数据集上不如 ResNet(因为缺少归纳偏置/Inductive Bias),但在 ImageNet-21K(1400万张图)或 JFT-300M(3亿张图)上训练后,ViT 反超 CNN。
8.2 CLIP(2021)
“ OpenAI 的 CLIP(Contrastive Language-Image Pre-training)做了一件更疯狂的事:它同时训练一个图像编码器(ViT)和一个文本编码器(Transformer),让它们在同一个向量空间里对齐。 ”
训练目标(对比学习损失,Contrastive Loss):
-
解释:
- :一个训练 batch 中的图像-文本对数量(比如32对)
- :第 张图像的向量表征(图像编码器输出)
- :第 段文本的向量表征(文本编码器输出)
- :向量内积(点积),衡量相似度
- :温度系数,控制分布的尖锐程度
- 第一项:对于第 张图像,希望它和配对的文本 的相似度远高于和其他 个文本的相似度
- 第二项:对于第 段文本,希望它和配对的图像 的相似度远高于和其他 个图像的相似度
- 简单说:把匹配的图像-文本对拉近,把不匹配的对推开
- CLIP 学完后,你可以用自然语言做图像分类。不需要专门的分类头,只需要把标签变成文本(如“一张猫的照片”、“一张狗的照片”),看图像和哪个文本最相似。
- 这是迈向多模态大模型的关键一步:文本和图像不再是两个隔离的世界了。
8.3 大模型时代:从 GPT-3 到 GPT-4 到多模态 AGI
-
2022-2024年,大模型经历了爆炸式发展:
- ChatGPT(2022):基于 GPT-3.5,用 RLHF(人类反馈强化学习)训练,让模型学会“说人话”、遵循指令、拒绝有害请求。
- GPT-4(2023):多模态(能看图),推理能力显著提升,通过律师资格考试、SAT数学高分。
- GPT-4o / Gemini / Claude:原生多模态(文本+图像+音频+视频),实时交互。
RLHF 的核心公式(PPO 优化目标,简化版):
其中 是新旧策略的概率比, 是优势函数估计。
-
解释:
- PPO(Proximal Policy Optimization)是一种强化学习算法
- 目标是不让模型在一次更新中步子迈太大(clip 操作),同时朝着人类偏好标注的方向优化
- 这解决了“大模型会说有害内容/胡说八道”的问题
小结
- 让我们以暂且生物医疗发展为主题,把整条脉络用一张图串起来:
+========================================================================================+
|                    AI & Deep Learning: From Statistics to GPT                         |
|                         A Roadmap for  AI Applications                                |
+========================================================================================+

 Time:  1958   1970s   1986    1995    1998    2006    2012    2014    2017    2020   2022-24
        |       |       |       |       |       |       |       |       |       |       |
        v       v       v       v       v       v       v       v       v       v       v
      Perceptron       MLP    SVM    LeNet  XGBoost  AlexNet Seq2Seq  Transf.  GPT-3   GPT-4
      (Rosenblatt)   +Backprop       (Lecun) (Chen)  +ReLU   +Attn   (Vaswani) +ViT   +ChatGPT
                           |                     |                     |
                           |                     |                     |
+==========================+                     |                     |
|  DATA LAYER (Choose your weapon)               |                     |
+==========================+                     |                     |
| Structured Tables (EHR)  |---> Classical ML   |                     |
| Images (WSI/CT/MRI)      |---> Deep Learning   |                     |
| Sequences (Text/Gene)    |---> Transformer     |                     |
| Multi-modal              |---> Medical Fusion  |                     |
+==========================+                     |                     |
                           |                     |                     |
+==========================+                     |                     |
|  CLASSICAL ML            |                     |                     |
|  (Small Sample / Struct.)|                     |                     |
+==========================+                     |                     |
|  Linear Regression       |                     |                     |
|    y = w^T x + b         |                     |                     |
|  Logistic Regression     |                     |                     |
|    P(y=1) = sigmoid(...) |                     |                     |
|  SVM + Kernel            |                     |                     |
|    K(x,x')=exp(-g||d||^2)|                     |                     |
|  Random Forest           |                     |                     |
|    H(D) = -sum p log p   |                     |                     |
|  XGBoost / GBDT          |                     |                     |
|    F_M = sum a_m h_m(x)  |                     |                     |
|  K-means / PCA           |                     |                     |
|    J = sum ||x-mu||^2    |                     |                     |
+==========================+                     |                     |
         |                  |                     |                     |
         |  BOTTLENECKS     |                     |                     |
         v                  v                     v                     v
+==========================+=====================+=====================+
| Linear Non-separable  ->  Feature Eng. Hell  ->  Gradient Vanishing -> |
|    MLP / Kernel Trick        CNN (Auto-features)   ResNet y=F(x)+x    |
|                                                                         |
| Long-range Dep.     ->  Fixed Context Vector  ->  Sequential Comp.  -> |
|    LSTM / Attention       Seq2Seq + Attention       Transformer      |
+==========================+=====================+=====================+
         |                  |                     |                     |
         v                  v                     v                     v
+==========================+  +=====================================+  +====================+
|  DEEP LEARNING           |  | TRANSFORMER ERA                     |  | MEDICAL AI         |
|  FOUNDATIONS             |  |                                     |  | APPLICATIONS       |
+==========================+  +=====================================+  +====================+
|  MLP + Backprop (1986)   |  |  Transformer (2017)                 |  |  AMIE (Dialogue)   |
|    chain rule dL/dw      |  |  softmax(QK^T/sqrt(dk))V           |  |  Pathology Transf. |
|                          |  |                                     |  |    MSI/BRAF/KRAS   |
|  CNN / LeNet (1998)      |  |  BERT - Bidirectional (2018)       |  |  Multi-modal CDSS  |
|    (I*K)(i,j) sliding    |  |  Masked Language Modeling           |  |    Image+Text+Lab  |
|                          |  |                                     |  |                    |
|  AlexNet / VGG (2012-14) |  |  GPT - Autoregressive (2018)       |  |  Rare Disease      |
|    ReLU + Dropout + GPU  |  |  -sum log P(x_t | x_<t)             |  |    Mining (Self-   |
|                          |  |                                     |  |    Play + Critic)  |
|  ResNet (2015)           |  |  ViT / CLIP (2020-21)               |  |                    |
|    y = F(x) + x          |  |  Image = Sequence of Patches        |  |  Drug Discovery    |
|                          |  |  Text-Image Alignment               |  |    AlphaFold / RL  |
|  RNN / LSTM (1997)       |  |                                     |  |                    |
|    h_t=tanh(W*h_t-1+...) |  |  GPT-3 / Scaling Laws (2020)        |  |  Clinical NLP      |
|                          |  |  L(N) = (Nc/N)^alpha                |  |    BERT on EHR     |
|  Seq2Seq + Attn (2014)   |  |                                     |  |                    |
|    e_t = sum alpha_t,i h |  |  RLHF / ChatGPT (2022-24)          |  |                    |
|                          |  |  PPO Human Preference Alignment     |  |                    |
+==========================+  +=====================================+  +====================+


+========================================================================================+
|                              FOUR ETERNAL TENSIONS                                     |
|                                                                                          |
|  1. Expression vs. Trainability    |    2. Local vs. Global                           |
|     Deeper = harder to optimize    |       CNN local -> RNN sequential -> Transformer global |
|                                                                                          |
|  3. Data Efficiency vs. Scale      |    4. Supervised vs. Self-Supervised              |
|     Small data: need inductive bias|       Labels -> Text masks -> Human feedback (RLHF) |
|     Big data: brute force scaling  |                                                   |
+========================================================================================+
核心主线
“ 于是我们可以发现深度学习的发展伴随着几个常见的话题: ”
- 表达能力 vs. 可训练性:更深的模型能表达更复杂的函数,但更难训练。ResNet、BatchNorm、Transformer 都是为了让“更深”成为可能。
- 局部感知 vs. 全局关联:CNN 擅长局部,RNN 擅长顺序,Transformer 通过注意力实现全局。今天的模型试图统一两者。
- 数据效率 vs. 规模效应:小模型需要精巧的归纳偏置(CNN 的平移不变性);大模型靠海量数据和参数, brute force 地学习一切。
- 监督标注 vs. 自监督信号:从“人工标注数据”到“文本/图像自己标注自己”,再到“人类反馈作为奖励信号”,学习的门槛越来越低,规模越来越大。
笔者的话
“ 写在最后:笔者慢慢整理资料整理了蛮久的,一直想做这次的内容,之后还会再慢慢消化,里面很多内容笔者自己也需要在细细考虑,目前做出来的目的是为了梳理清楚整个领域的脉络,如果有帮助到你,那真是太好了。当然,深度学习这个故事还没有结束。我们发现:今天的模型依然不知道“自己知道什么”(缺乏可靠的不确定性估计),依然在幻觉(hallucination),依然没有真正的因果推理和世界模型。但回看这条从感知机到大模型的发展脉络,所以说我们有理由相信:下一个 breakthrough,可能就藏在某个现在还看似疯狂的 idea 里。让我们打破第四面墙来发问:哈哈哈哈,你会成为那个“弗兰肯斯坦”吗? 👽 ”
参考文献
没有统计文献,依靠搜索的相关资料拼凑的~