Transformer|架构演进(6):Position Encoding 系统(3)——从 RoPE 到长上下文 Scaling
阅读提示: 最近真是高产似母猪(不是),我很兴奋我也许将要有几个师弟师妹了。也许你会很疑惑为什么直接跳过了RoPE,笔者这里要解释一下,因为打算推导RoPE的原始论文,所以工作量有点大,简单清晰梳理出来更是有点头大,所以就先把介绍部分扯出来了,但是这样可以让人先形成一个比较清晰的认知,也是多多易善吧。其实潜台词是下次更新就要等有点年头了,笔者也要准备许多汇报和期末。不说伤心事了,让我们开始吧。祝食用愉快~💔
导言
前两篇里,我们已经讲了两类基础位置编码。
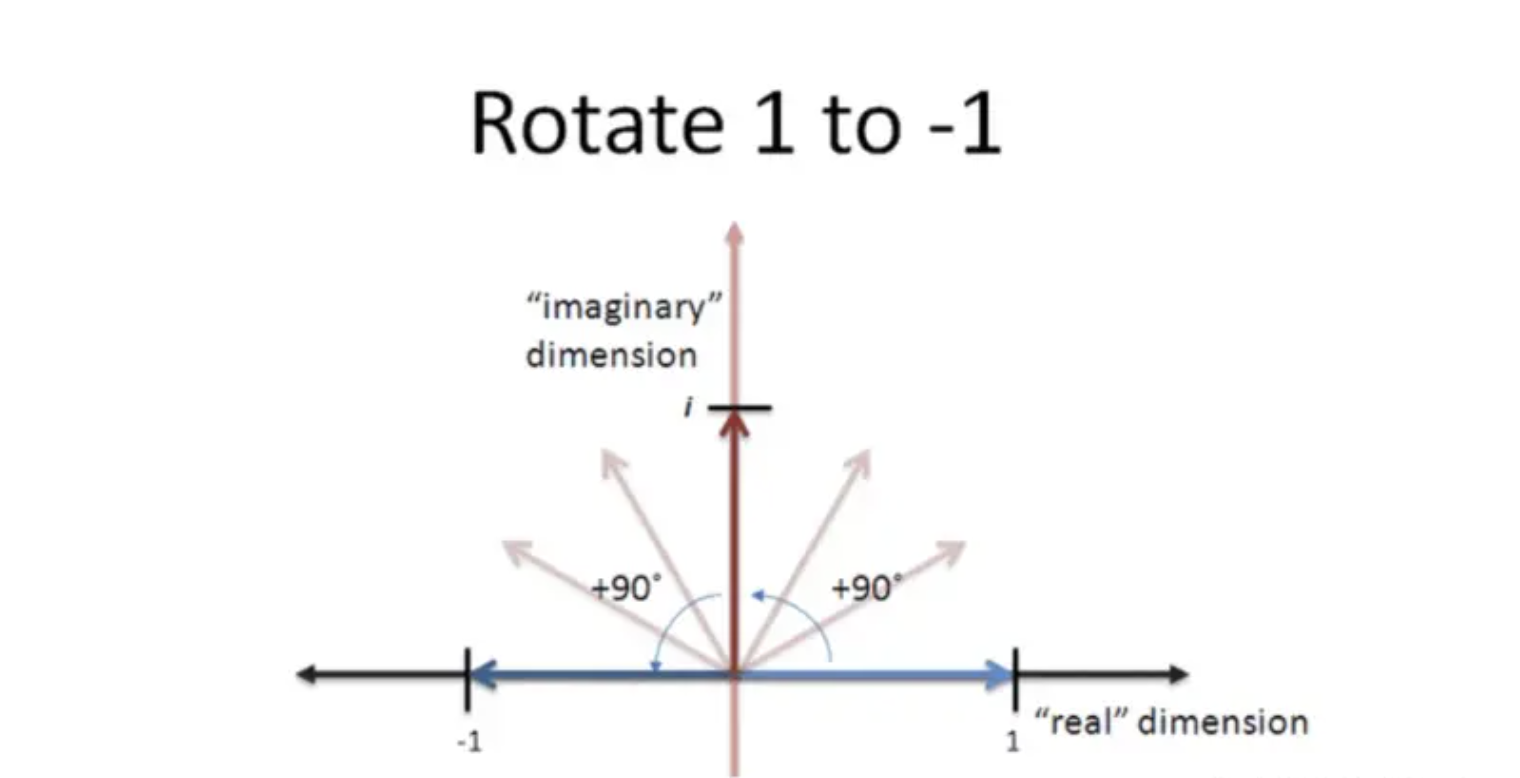
图 1 旋转位置编码
第一类是 绝对位置编码。它回答的问题是:
“ 这个 token 在第几个位置? ”
原始 Transformer 的 sinusoidal positional encoding 和 BERT/GPT-2 的 learned absolute position embedding 都属于这个方向。
第二类是 相对位置编码。它回答的问题是:
“ query token 和 key token 相距多远? ”
Shaw et al.、Transformer-XL、T5 Relative Position Bias、DeBERTa 都在这个方向上做了不同形式的探索。
但是现代 decoder-only LLM 的主流路线,并没有停留在传统绝对位置编码或传统相对位置 bias 上,而是大量转向了 RoPE:Rotary Position Embedding。
而RoPE 后来又衍生出一整套长上下文扩展方法,例如:
- Position Interpolation;
- NTK-aware Scaling;
- Dynamic NTK Scaling;
- YaRN;
- LongRoPE;
- LLaMA 3.1 风格的分频段 RoPE scaling;
- 以及一些更前沿的 xPos、KERPLE、CoPE、NoPE 等替代范式。
我们这一篇不做 RoPE 的完整数学推导。RoPE 的数学细节值得单独开一篇来推。本文的目标是先建立一个清晰完整的认知:
“ 现代 LLM 为什么选择 RoPE?RoPE 为什么需要 scaling?各种 scaling 方法分别在解决什么问题?长上下文模型的未来趋势是什么? ”
认知主线
“ 位置编码的发展,可以用一条非常清晰的逻辑线串起来。我们再简单回顾一下 ”
1. 绝对位置阶段:让模型知道“我在哪里”
原始 Transformer 的问题是 self-attention 本身没有顺序感。
所以最早的方法很直接:给每个位置一个向量,然后加到 token embedding 上。
这解决了顺序感问题,但它把位置看成单点属性。
2. 相对位置阶段:让 attention 知道“你离我多远”
Attention 本质上是 token pair 之间的关系。
所以后续研究发现,只知道每个 token 的绝对位置不够。模型更需要知道:
“ query 和 key 相隔多少? ”
这就出现了 Shaw、Transformer-XL、T5 relative bias 等方法。
3. RoPE 阶段:用旋转把绝对位置和相对距离统一起来
RoPE 的漂亮之处在于:它用绝对位置决定 Q/K 的旋转角度,但两个位置做 attention 点积时,结果自然依赖相对位置差。
简单说:
“ RoPE 用绝对位置做旋转,但 attention score 里体现的是相对距离。 ”
这让它非常适合 decoder-only LLM。
4. RoPE Scaling 阶段:把训练长度扩展到更长上下文
原始 RoPE 通常在某个训练上下文长度内工作良好,例如 2K、4K、8K。
但现代 LLM 需要 32K、128K、1M+ 上下文。
这时问题是:
“ 一个只在短上下文中训练过的 RoPE 模型,如何稳定处理远超训练长度的位置? ”
于是出现了 Position Interpolation、NTK Scaling、YaRN、LongRoPE 等方法。
5. 后 RoPE 阶段:作为系统工程的一部分
今天的长上下文能力,不是单靠位置编码就能解决的。
-
它同时涉及:
- RoPE scaling;
- long-context continued pretraining;
- 长文档数据配比;
- attention kernel;
- KV cache 显存;
- GQA/MLA/KV compression;
- retrieval 和 memory;
- long-context evaluation;
- 模型是否真的会使用中间位置的信息。
所以,位置编码已经从一个“数学函数选择问题”,变成了“长上下文系统设计问题”。
RoPE 为什么成为现代 LLM 主流?
“ RoPE 最早由 RoFormer 提出。它的核心思想不是把位置向量加到 token embedding 上,而是在 attention 的 Q 和 K 上施加旋转。 ”
假设位置为 的 query 是 ,位置为 的 key 是 。
RoPE 会对它们做位置相关旋转:
其中 和 是由位置决定的旋转矩阵。
然后 attention score 是:
由于旋转矩阵的性质,这个点积会自然依赖 。
这就是 RoPE 的核心优势:
“ 它在 Q/K 几何结构里注入位置,使 attention score 天然带有相对距离信息。 ”
RoPE 相比绝对位置编码的优势
绝对位置编码是:
位置和内容在输入层相加后纠缠在一起。
RoPE 则是在 Q/K 里编码位置。它不直接改变 token embedding,而是改变 query-key 匹配方式。
这更贴合 attention 的机制。
RoPE 相比传统 relative bias 的优势
T5 Relative Bias 是给 attention logits 加一个距离 bias。
RoPE 则不是额外加一个标量偏置,而是改变 Q/K 的几何关系。
这使它可以在每个 head 的连续向量空间里表达更细粒度的位置关系。
同时,RoPE 不需要为每个相对距离学习一张 bias 表,也不需要 Shaw-style 的 relative value。
对 decoder-only 生成和 KV cache 来说,RoPE 的工程实现也比较自然。
原始 RoPE 不够长?
RoPE 的位置编码本质上是多频率旋转。
-
不同维度对应不同频率:
- 高频维度变化快;
- 低频维度变化慢。
这和正弦位置编码非常相似,也可以从 Fourier features 的角度理解。
问题在于:模型训练时只见过某个最大长度,比如 4K 或 8K。
如果推理时直接输入 32K、128K,RoPE 的旋转角度会进入模型从未见过的范围。
这会导致两类问题。
高频维度的相位外推问题
高频维度变化很快,位置稍微增加就会产生较大相位变化。
当位置远超训练长度时,高频维度会出现大量训练中没见过的相位组合。
模型可能无法稳定解释这些位置。
长距离注意力分布异常
RoPE 影响的是 attention score。
当位置超出训练范围后,Q/K 点积结构可能出现分布偏移,导致 attention score 过大、过小或模式异常。
-
这会表现为:
- perplexity 上升;
- 长距离检索失败;
- attention 混乱;
- 局部能力下降;
- 模型在长上下文中“看不见”或“不使用”远处信息。
Position Interpolation
“ 这之后于是诞生了许多Scaling的方法,我们一个一个来了解 ”
最直观的扩展方法是 Position Interpolation。
假设模型原本训练长度是 ,现在希望扩展到 。
如果直接把位置从 到 喂给 RoPE,就是 extrapolation。
Position Interpolation 的做法是把新位置压缩回旧范围。
也就是把位置 映射成:
或者写成 scale factor :
这样,原本 到 的位置,被压缩进 到 的范围。
为什么 interpolation 比 extrapolation 稳定?
直接 extrapolation 会让模型看到训练中从未见过的位置相位。
而 interpolation 让所有位置仍然落在训练长度范围内。
这就像把一张长地图压缩到模型熟悉的窗口里。
模型不会看到超出训练范围的极端位置,因此更稳定。
Chen et al. 的 Extending Context Window of Large Language Models via Positional Interpolation 证明和实验都表明,Position Interpolation 比直接外推更稳定,并且可以用少量 fine-tuning 把 LLaMA 系列扩展到更长上下文。
Position Interpolation 的问题
Position Interpolation 的代价也很明显——它把所有距离都压缩了。
如果扩展 8 倍,那么原本相邻 token 的位置间隔也会变成原来的 。
这会损害局部位置分辨率。
语言模型非常依赖局部结构,例如相邻词、标点、括号、代码缩进。如果局部位置被压得太密,模型可能更难区分近距离关系。
这推动了后面的频率分段 scaling。
NTK-aware Scaling
“ NTK-aware Scaling 来自社区实践和后续分析。它的核心直觉是:RoPE 的不同频率维度承担不同职责,不应该统一缩放。 ”
高频维度主要负责局部位置。
低频维度主要负责长距离趋势。
如果对所有频率统一压缩,就会伤害局部信息。
所以 NTK-aware Scaling 试图调整 RoPE 的 base 或频率分布,让低频部分更适应长上下文,同时尽量保留高频部分的局部能力。
改 base 的直觉
RoPE 的频率通常类似:
其中 是 RoPE base。
增大 会让频率整体变低,也就是让位置变化更慢。
这有助于长上下文,因为更长的位置范围内相位变化不会那么剧烈。
但如果所有频率都变慢,局部分辨率又会受损。
因此 NTK-aware 的核心不是简单增大 base,而是让不同维度以更合理的方式变化。
Dynamic NTK Scaling
Dynamic NTK Scaling 则进一步根据实际推理长度动态调整 scaling。
如果当前上下文没有超过训练长度,就尽量保持原始 RoPE。如果超过训练长度,再逐步调整频率。
这比固定 scaling 更柔和。它的目标是:
“ 短上下文尽量不变,长上下文再拉伸。 ”
这一点非常重要,因为很多长上下文模型不仅要处理 128K 文档,也要保持 1K、2K、4K 对话和普通问答能力。
YaRN
“ YaRN 是 RoPE 长上下文扩展中非常经典的方法之一。 ”
图 2 YaRN
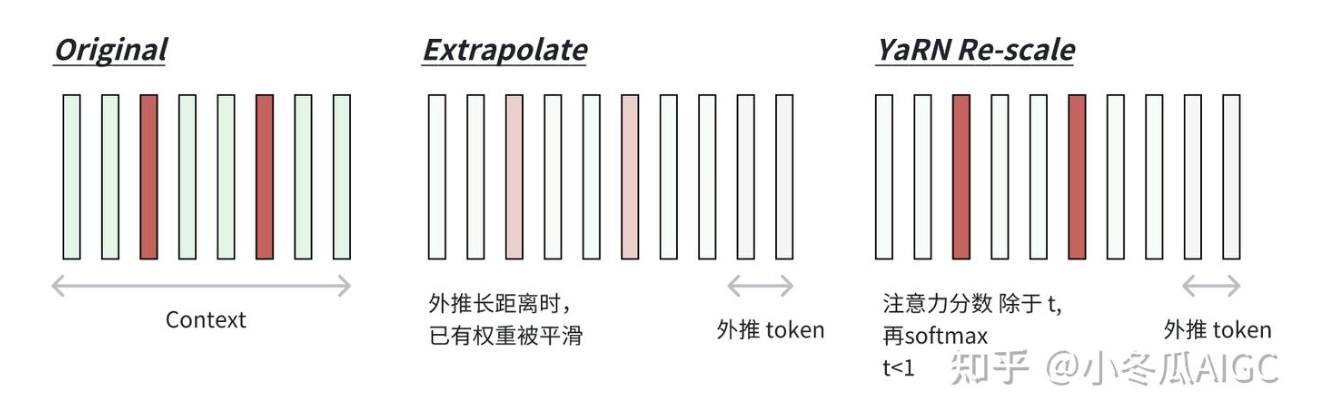
它的核心目标是解决 Position Interpolation 和 NTK-aware Scaling 的折中问题。
YaRN 的思想可以概括为:
“ 不同频率区间承担不同功能,因此应该按频段采用不同的插值策略,并配合 attention logit scaling 稳定训练和推理。 ”
为什么需要分频段?
RoPE 的不同维度频率不同。高频维度看局部,低频维度看长程。
-
如果要扩展上下文,我们真正想做的是:
- 保留高频维度的局部能力;
- 拉伸低频维度的长程能力;
- 中间频率平滑过渡。
这就是 YaRN 的基本思路。
NTK-by-parts 的直觉
YaRN 中常提到 NTK-by-parts。
-
直觉上,它把 RoPE 频率维度分成不同区域:
- 高频区域:尽量保留,不要过度缩放;
- 低频区域:允许更强缩放,支持远距离;
- 中间区域:平滑插值,避免突变。
“ 这样可以避免 Position Interpolation 的“一刀切压缩”。 ”
Attention scaling 为什么重要?
长上下文下,attention logits 的统计分布会改变。
序列越长,softmax 里候选 key 越多,极值行为也会变化。
如果不调整 attention scale,模型可能出现 attention 过尖或过散的问题。
YaRN 引入 attention scaling 或 temperature 调整,用来稳定长上下文下的 attention 分布。
这说明长上下文扩展不只是位置频率问题,也涉及 attention 数值稳定性。
YaRN 的意义
YaRN 的意义在于,它把社区里很多 RoPE scaling 经验系统化了。他的思想是:
“ RoPE scaling 应该区分频率维度,同时关注 attention logits 的数值尺度。 ”
这让它成为很多长上下文模型的重要参考方案。
LongRoPE
“ LongRoPE 是进一步把 RoPE scaling 推到极长上下文的代表方法。 ”
它的目标非常激进:把预训练 LLM 的 context window 扩展到 2M tokens 量级,同时尽量保持短上下文能力。
LongRoPE 的核心观点是:Position Interpolation 不应该只考虑一个统一 scale factor。
-
它发现存在两种非均匀性:
- 不同 RoPE 维度需要不同 scaling;
- 不同 token 位置也可能需要不同 scaling。
因此 LongRoPE 通过搜索找到更合适的非均匀 rescaling 参数。
LongRoPE 的三个关键点
LongRoPE 主要有三点创新。
- 第一,非均匀位置插值。
它不再使用单一缩放,而是在不同维度和位置上采用不同 scaling,以更好保留原始 RoPE 信息。
- 第二,渐进式扩展。
它先把模型扩展到 256K,并进行少量 fine-tuning,然后再基于扩展后的模型继续插值到 2048K。这比一步到位更稳定。
- 第三,短上下文恢复。
长上下文扩展很容易损害原始短上下文性能。LongRoPE 会重新调整短长度下的 scaling 因子,恢复短上下文能力。
LongRoPE 说明了什么趋势?
LongRoPE 说明,长上下文 RoPE scaling 已经从简单公式进入搜索和系统工程阶段。
LongRoPE 的关注在于:
“ 哪些维度、哪些位置更关键?如何非均匀地缩放?如何分阶段训练?如何保短又保长? ”
这代表了一个趋势:
“ 极长上下文靠位置编码、训练策略、搜索、数据和评测共同解决。 ”
LLaMA 3.1 风格的 RoPE Scaling
“ 我们来看一个具体的例子: ”
LLaMA 3.1 系列采用了面向长上下文的 RoPE scaling 配置。
公开配置中可以看到类似:
"rope_scaling": {
  "factor": 8.0,
  "low_freq_factor": 1.0,
  "high_freq_factor": 4.0,
  "original_max_position_embeddings": 8192,
  "rope_type": "llama3"
}-
这种设计明显体现了分频段思想:
- 高频部分和低频部分采用不同处理;
- 保留短上下文局部分辨率;
- 扩展长上下文可用范围。
它背后的逻辑和 YaRN、NTK-by-parts 是一致的:
“ 高频保局部,低频扩长程,中间平滑过渡。 ”
RoPE Scaling 方法的对比
“ 可以把几种典型 RoPE scaling 方法放在一起看。 ”
| 方法 | 核心思想 | 优点 | 代价 / 局限 |
|---|---|---|---|
| Position Interpolation | 把新位置线性压缩回训练长度范围 | 简单稳定,少量微调有效 | 局部位置分辨率下降 |
| NTK-aware Scaling | 调整频率/base,改善长程相位分布 | 比统一插值更合理 | 依赖经验和实现细节 |
| Dynamic NTK | 根据实际长度动态调整 | 短上下文更少受影响 | 推理实现更复杂 |
| YaRN | 分频段插值 + attention scaling | 兼顾局部和长程,系统性强 | 超参和实现较复杂 |
| LongRoPE | 非均匀维度/位置缩放 + 渐进扩展 | 支持百万级上下文 | 需要搜索、微调和系统工程 |
| LLaMA3-style scaling | 工业化分频段 scaling | 实用、兼容主流 LLM | 具体细节和数据训练同样关键 |
这些方法的共同目标都是:
“ 尽量让模型在长上下文下看到“熟悉而可用”的位置相位,同时不要毁掉短上下文能力。 ”
RoPE Scaling 不是长上下文的全部
“ 这里必须强调一个重要观点:位置编码扩展,不等于模型真的拥有长上下文能力。 ”
很多模型可以设置 128K context window,也可以通过 RoPE scaling 在形式上支持更长输入,但这不代表模型真的能稳定使用远处信息。
长上下文能力至少包括五个层面。
位置可表示
模型必须能为远位置生成合理的位置编码。
这是 RoPE scaling 解决的问题。
Attention 可计算
长序列 full attention 是 。
如果上下文到 128K 或 1M,attention 计算和显存会非常巨大。
需要 FlashAttention、block attention、sparse attention、sliding window、linear attention 等系统支持。
KV cache 可承受
自回归推理时,KV cache 与序列长度线性增长。
长上下文下,KV cache 往往成为瓶颈。
因此需要 GQA、MQA、MLA、KV compression、paged attention 等方法。
数据中真的有长依赖
如果训练数据都是短文本,模型即使位置编码支持长上下文,也不会学会使用远距离信息。
长上下文模型需要长文档、代码仓库、多轮对话、书籍、论文、工具轨迹等训练数据。
模型真的会用中间信息
即使输入很长,模型也可能只关注开头和结尾。
Lost in the Middle 这类研究发现,模型对上下文中间位置的信息使用能力往往较差,相关信息放在开头或结尾时表现更好。
这说明 long context evaluation 不能只看最大长度,还要看不同位置的信息提取能力。
RoPE 之外的其他前沿范式
“ 虽然 RoPE 是现代 LLM 主流,但它不是唯一方向。这里简要介绍一些值得关注的替代或补充路线。 ”
ALiBi
ALiBi 不使用 position embedding,而是给 attention logits 加线性距离惩罚:
不同 head 使用不同斜率 。
它的优势是简单、无参数、外推自然。
但它的表达能力相对有限,并且在很多现代 LLM 中没有像 RoPE 那样成为主流。
xPos
xPos 可以看作 RoPE 的一个增强版本。它在旋转的基础上加入指数衰减,用来改善长距离 attention 的稳定性。
它试图保留 RoPE 的相对位置优势,同时让长度外推更稳定。
KERPLE
KERPLE 把相对位置编码看成 kernelized positional difference。
它用条件正定核等工具来构造适合长度外推的相对位置 bias,并指出 ALiBi 可以看作其框架中的一种特例。
这类方法的价值在于提供了更理论化的 relative position 设计视角。
CoPE
CoPE,也就是 Contextual Position Encoding,提出一个很有意思的问题:
“ 位置一定要按 token 数递增吗? ”
图 3 CoPE
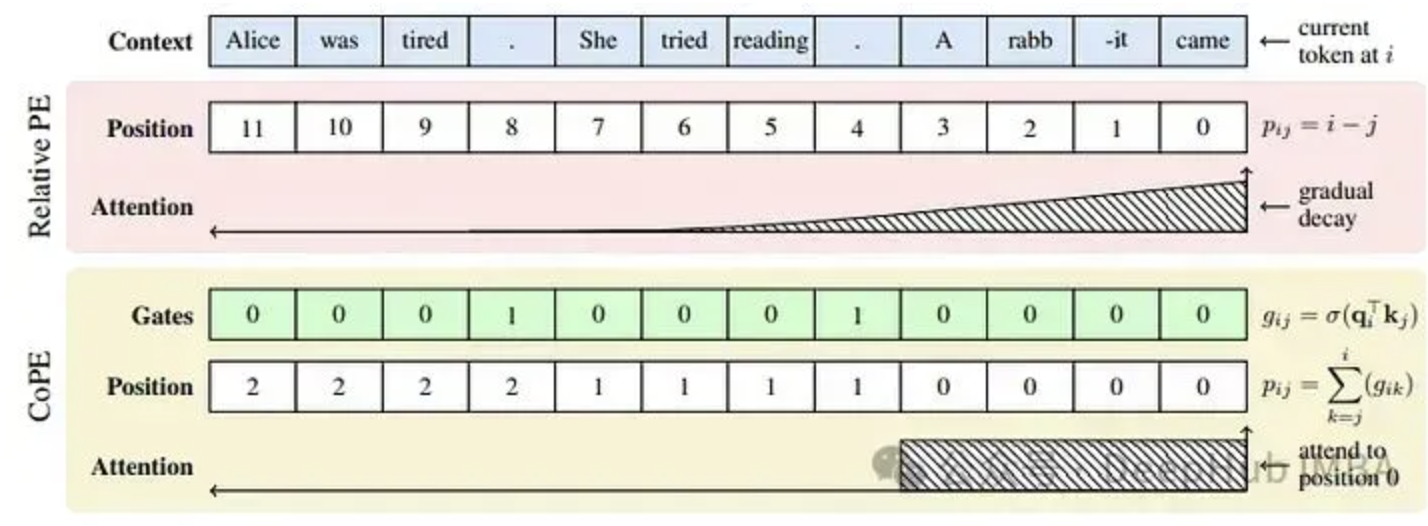
传统位置编码默认每个 token 都让位置加 1。
但有些任务需要模型关注“第几个句子”“第几个名词”“第几个关键实体”,而不只是第几个 token。
CoPE 让位置增量由内容决定,即模型学会“哪些 token 应该被计数”。这使位置可以依赖上下文,而不是固定 token index。
这代表一个非常值得关注的方向:
“ 位置编码从静态 index 走向内容感知的动态位置。 ”
NoPE
有些研究发现,decoder-only Transformer 在某些设置下即使没有显式 positional encoding,也能表现出一定长度泛化能力。
NoPE 的现象提醒我们:causal mask、训练数据分布、attention pattern 本身也会引入位置相关结构。
这不意味着位置编码不重要,而是说明位置感可能不只来自显式 PE,也可能来自 architecture 和 optimization 的隐式偏置。
位置编码会走向哪里?
“ 从目前趋势看,位置编码未来大概率会沿着几条线发展。 ”
RoPE 仍会是短中期主流
RoPE 已经深度进入现代 LLM 架构和推理系统。
它和 KV cache、GQA、FlashAttention、主流框架都高度兼容。
因此,短中期内,RoPE + scaling 仍然会是主流路线。
Scaling 会越来越非均匀、数据驱动、模型相关
早期 scaling 是一个全局 factor。
后续变成频段 scaling。
LongRoPE 已经走向维度/位置非均匀 scaling 和搜索。
未来很可能出现更自动化的方法,根据模型、数据、目标长度和评测指标自动找到 scaling 策略。
位置编码会和 attention 架构共同设计
长上下文不是位置编码单独能解决的。
-
未来的位置机制会和这些模块一起设计:
- sliding window attention;
- global token attention;
- retrieval attention;
- memory tokens;
- recurrent memory;
- KV compression;
- linear attention;
- state space model hybrid。
也就是说,位置编码会从“输入向量的一部分”变成“上下文系统的一部分”。
动态位置和语义位置会变重要
传统位置是 token index。
但人类理解长文档时,不只是按 token 编号,而是按段落、章节、实体、事件、代码块、函数结构来组织信息。
CoPE 这类方法提示了一个方向:
“ 未来的位置可能不只是 token count,而是内容相关、结构相关、任务相关的动态坐标。 ”
-
例如:
- 第几个句子;
- 第几个代码块;
- 第几个函数;
- 第几个实体出现;
- 当前 token 所属章节;
- 当前信息在检索 memory 中的位置。
这可能会成为超长上下文和 agent memory 的关键。
长上下文评测会推动位置机制进化
未来更重要的是:
- 多跳长程推理;
- 中间位置鲁棒性;
- 长代码仓库理解;
- 长对话状态保持;
- 多文档冲突整合;
- 时间线和事件顺序建模;
- million-context 下的信息选择。
“ 这些评测会倒逼位置编码从“能表示远位置”走向“能有效使用远信息”。 ”
小结
从工程和研究角度看,RoPE 是当前最重要的核心方法。Position Interpolation、NTK Scaling、YaRN、LongRoPE、LLaMA3-style scaling 都是在围绕 RoPE 做长上下文扩展。
但未来的位置机制不会只停留在 RoPE scaling 上。
它会越来越多地和 long-context data、attention architecture、KV cache compression、retrieval memory、dynamic position、semantic structure 结合。
“ 位置编码已经从“给 token 一个位置”演化为“让模型在超长上下文中稳定组织、检索和使用信息”的系统问题。 ”
笔者的话
“ 这里对整个位置编码的整体梳理就到这里结束了,但是为了深度理解,还是得深入到经典的论文本身去探索,所以笔者还是需要去对照RoPE的文章去推导理解一遍,因为工作量比较大,需要较多的时间,于是就放在这部分整体概览的后面来详细讲了,这将会花掉我许多时间,不过这很值得,毕竟这是一个相当重要的里程碑时刻。我相信有了一个整体的了解对之后我们具体的对RoPE以及YaRN和NTK Scaling的部分的具体展开就有了准备了吧。 ”
参考文献
- Su et al., 2021. RoFormer: Enhanced Transformer with Rotary Position Embedding.
RoPE 原始论文。
https://arxiv.org/abs/2104.09864
- Chen et al., 2023. Extending Context Window of Large Language Models via Positional Interpolation.
Position Interpolation,RoPE 长上下文扩展经典方法。
https://arxiv.org/abs/2306.15595
- Peng et al., 2023. YaRN: Efficient Context Window Extension of Large Language Models.
分频段 RoPE scaling 和 attention scaling。
https://arxiv.org/abs/2309.00071
- Ding et al., 2024. LongRoPE: Extending LLM Context Window Beyond 2 Million Tokens.
非均匀 RoPE scaling 和渐进式百万级上下文扩展。
https://arxiv.org/abs/2402.13753
- Press et al., 2022. Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation.
ALiBi。
https://arxiv.org/abs/2108.12409
- Sun et al., 2022. A Length-Extrapolatable Transformer.
xPos,改进 RoPE 长度外推。
https://arxiv.org/abs/2212.10554
- Chi et al., 2022. KERPLE: Kernelized Relative Positional Embedding for Length Extrapolation.
用 kernel 视角统一和扩展 relative position bias。
https://papers.neurips.cc/paper_files/paper/2022/file/37a413841a614b5414b333585e7613b8-Paper-Conference.pdf
- Golovneva et al., 2024. Contextual Position Encoding: Learning to Count What’s Important.
CoPE,内容相关的动态位置编码。
https://arxiv.org/abs/2405.18719
- Kazemnejad et al., 2023. The Impact of Positional Encoding on Length Generalization in Transformers.
系统比较 APE、T5 RPE、ALiBi、RoPE、NoPE 等在长度泛化任务中的表现。
https://proceedings.neurips.cc/paper_files/paper/2023/hash/4e85362c02172c0c6567ce593122d31c-Abstract-Conference.html
- Liu et al., 2023. Lost in the Middle: How Language Models Use Long Contexts.
分析长上下文模型对不同位置相关信息的使用能力。
https://arxiv.org/abs/2307.03172