扩散模型|基本原理与发展脉络
阅读提示: 这是笔者在Transformer学习外的拓展观察,这篇从原始的视角与发展的历史来讲述了扩散模型的基本情况,属于个人理解与科普整理,不需要什么基础就可以阅读。祝食用愉快~🐮
导言
“ 我们一直默认主流大语言模型采用的是 自回归生成:给定前文,一个 token 一个 token 地往后生成。这也是 GPT 类模型最经典的方式。 ”
如果用一个比喻,自回归模型像是在“盖砖头”:先放第一块,再根据已经放好的砖决定下一块怎么放。它的优点是简单、稳定、训练目标清晰;缺点是生成过程天然有顺序依赖,前面错了后面容易被带偏,而且每一步主要基于已经生成的前缀,不能在生成过程中真正反复修改全局。
扩散模型则是另一种完全不同的生成范式。
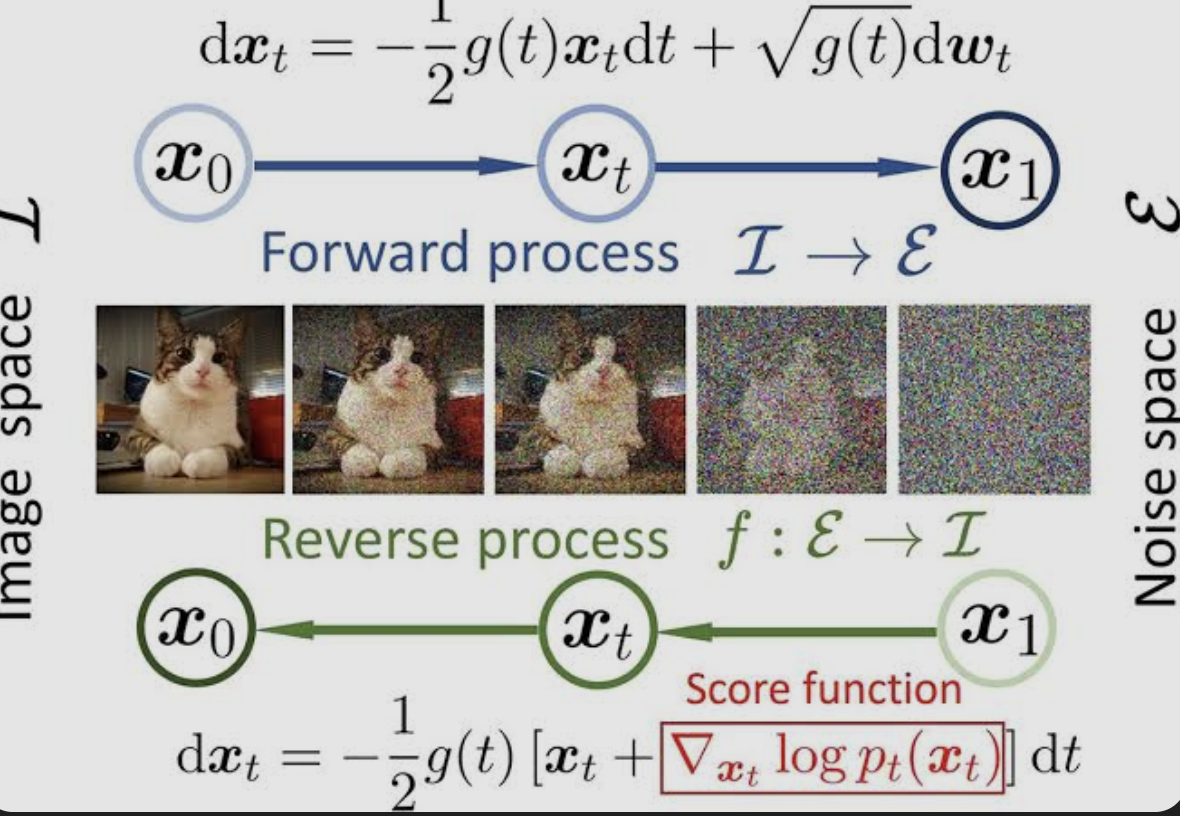
如果自回归是“盖砖头”,扩散模型更像是“捏陶土”或者“雕刻”:一开始是模糊轮廓,经过一轮轮修正,整体结构逐渐浮现。
图 1 逐渐浮现的图像
两个范式:自回归和扩散
自回归模型:从左到右生成
自回归语言模型的目标是分解联合概率:
也就是说,模型每一步只预测下一个 token。
例如:
法国 的 首都 是 → 巴黎生成时也是一步步来:
先生成 token 1
再生成 token 2
再生成 token 3
...
这种方式非常适合文本,因为文本本身就是离散序列。但它也有一些天然限制。
- 第一,生成必须串行。第 个 token 没生成出来之前,第 个 token 不能生成。
- 第二,误差会累积。如果前面生成错了,后面会在错误上下文上继续生成。
- 第三,它更像局部扩展。虽然 Transformer 可以通过 attention 看很长上下文,但生成决策仍然是单向展开的。
扩散模型:从噪声中反复去噪
扩散模型的基本思路完全不同。
过程为:
带噪样本 → 更干净的样本可以把它拆成两个过程。
第一个是 前向加噪过程。
从真实数据 出发,不断加入噪声,得到越来越混乱的样本:
当 足够大时, 基本接近纯噪声。
第二个是 反向去噪过程。
模型学习从噪声一步步还原数据:
训练时,模型看到的是被加噪后的样本 ,它要预测其中的噪声,或者预测干净样本,或者预测从 到 的去噪方向。
这就是扩散模型的核心:
“ 通过多次迭代不断修正全局结构。 ”
扩散模型的发展
“ 扩散模型有一条比较清晰的发展路线。 ”
早期思想:扩散概率模型和 score matching
扩散模型的思想可以追溯到更早的扩散概率模型和 score-based generative modeling。
核心问题是:如果我们知道数据分布附近每个点应该往哪里移动,才能更接近真实数据流形,那么就可以从随机噪声出发,一步步沿着这个方向走回真实数据分布。
这类方法和 score matching、Langevin dynamics 有密切关系。
DDPM:现代扩散模型的经典形式
2020 年 Ho、Jain 和 Abbeel 提出的 Denoising Diffusion Probabilistic Models,通常简称 DDPM,是现代扩散模型的关键节点。DDPM 把扩散模型训练简化成非常清晰的去噪目标:给模型一个带噪样本,让它预测加进去的噪声。
这使得扩散模型变得稳定、易训练,并在图像生成中快速发展。
DDIM:减少采样步数
DDPM 的一个问题是采样慢,因为它通常需要很多去噪步。
DDIM,也就是 Denoising Diffusion Implicit Models,提出了一种更快的采样方式,可以用更少步数生成高质量样本。DDIM 论文报告在一些设置下可以比 DDPM 快 10 到 50 倍,同时保留较好质量。
这解决的是扩散模型早期非常关键的痛点:
“ 生成质量高,但采样太慢。 ”
Guided Diffusion:提升条件生成质量
随后,扩散模型开始大量用于条件生成。
比如给定类别、文本、图像条件,让模型生成符合条件的样本。
Dhariwal 和 Nichol 的 Diffusion Models Beat GANs on Image Synthesis 通过更好的架构和 classifier guidance,让扩散模型在图像质量上达到甚至超过当时强大的 GAN 模型。
后来的 classifier-free guidance 又成为文本生成图像模型中的常用技巧。
Latent Diffusion:在潜空间里扩散
直接在像素空间做扩散非常贵。
Latent Diffusion Models 的核心思想是:先用 autoencoder 把图像压缩到低维 latent space,再在 latent space 中做扩散生成,最后再解码回图像。
Stable Diffusion 就是这个路线的代表。它让高分辨率图像生成的计算成本大幅降低,使扩散模型真正走向大规模应用。
DiT:把扩散模型的大脑换成 Transformer
传统图像扩散模型常用 U-Net 作为 denoising network。
DiT,也就是 Diffusion Transformer,提出用 Transformer 替代 U-Net,在 latent patches 上做去噪。Peebles 和 Xie 的 Scalable Diffusion Models with Transformers 显示,DiT 有很强的 scaling trend:模型越大、计算越多,FID 越好。
这一步非常重要,因为它把扩散模型和 Transformer scaling law 连接起来。
DDPM 的核心
扩散模型有很多形式。这里先以最经典的 DDPM 为例。
前向加噪过程
给定真实样本 ,扩散模型定义一个逐步加噪过程:
其中:
- 是第 步的噪声强度;
- 是第 步带噪样本;
- 越大,噪声越多。
经过很多步后, 接近标准高斯噪声。
一个非常有用的性质是,可以直接从 采样任意时刻的 :
其中:
这表示: 是干净样本 和噪声 的加权混合。
当 小时, 主要像原图;当 大时, 主要像噪声。
反向去噪过程
图 2 去噪
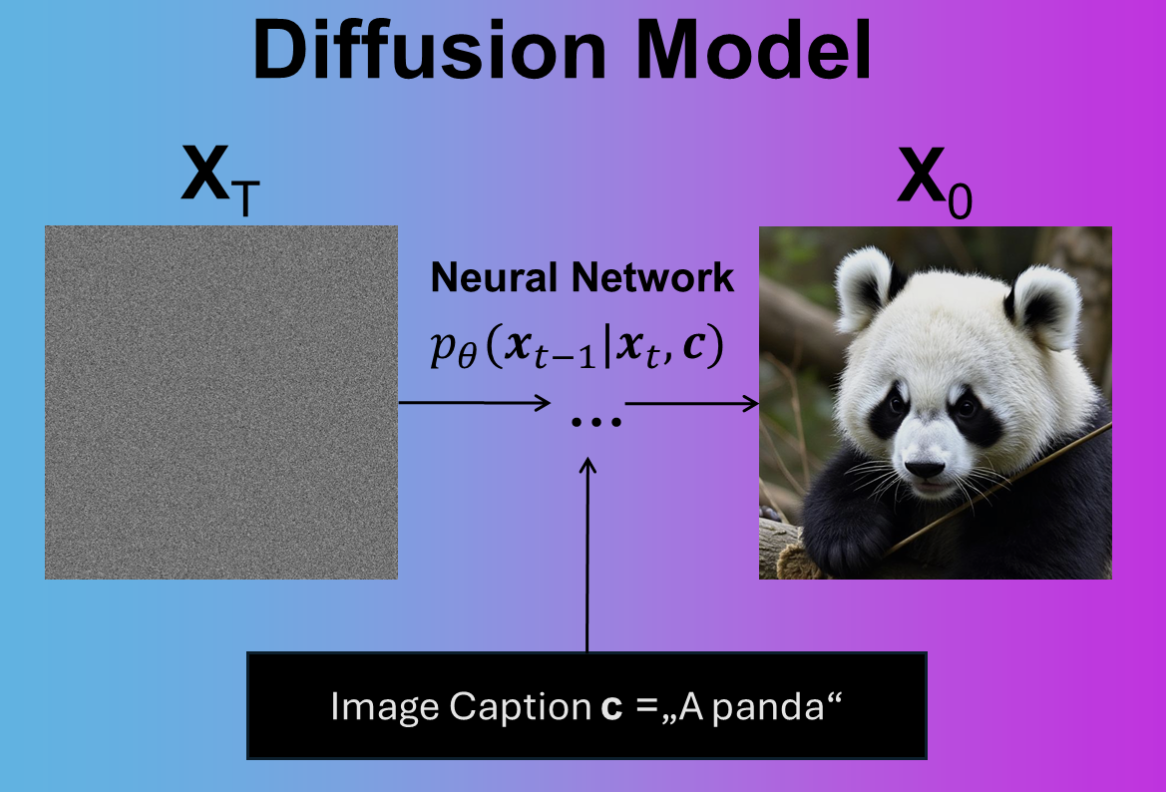
生成时,我们从纯噪声开始:
然后一步步采样:
直到得到 。
模型要学的是:
“ 给定带噪样本 和时间步 ,如何预测去噪方向? ”
常见训练目标是让模型预测噪声:
训练 loss 可以写成:
这就是 DDPM 中非常经典的噪声预测目标。
-
直观理解:
- 我们知道自己往 里加了什么噪声 ;
- 模型看到 后,要猜出这部分噪声;
- 猜准后,就能把噪声从 中减掉。
为什么它是“全局修正”?
自回归模型生成一个 token 后,通常不会回头修改它。
扩散模型不同。
每一步去噪都作用在整个样本上。对于图像,它每一步都更新整张图。对于蛋白质结构,它可以每一步更新整体坐标。对于 masked diffusion language model,它可以每一步重新预测多个 masked token。
所以扩散模型更像是:
“ 先建立整体轮廓,再逐步细化局部细节。 ”
这也是为什么它适合图像、视频、3D 结构、分子构象、蛋白质骨架这类全局约束很强的对象。
扩散模型怎么实现?
从实现角度看,扩散模型主要有两个流程:训练和采样。
训练流程
以连续数据为例,比如图像 latent、蛋白质坐标、分子构象。
训练步骤大致是:
1. 从数据集中采样真实样本 x0
2. 随机采样时间步 t
3. 采样高斯噪声 ε
4. 根据噪声调度把 x0 加噪成 xt
5. 把 xt 和 t 输入模型
6. 模型预测噪声 εθ(xt, t)
7. 用 MSE 训练:||ε - εθ||²
核心就是:随机选一个噪声等级,让模型学会在这个噪声等级下去噪。
采样流程
生成时则反过来:
1. 从标准高斯采样纯噪声 xT
2. for t = T, T-1, ..., 1:
      用模型预测噪声 εθ(xt, t)
      根据反向公式得到 xt-1
3. 得到最终样本 x0
这里的关键是:采样通常需要多步。
步数越多,质量通常越高,但速度越慢。DDIM、DPM-Solver、distillation 等方法,都是为了减少采样步数。
扩散模型和 Transformer 的关系:DiT 的意义
“ 很多人会问:扩散模型和 decoder-only Transformer 到底是什么关系? ”
这里要区分两个层面。
Diffusion 是生成范式
扩散模型定义的是训练和生成方式:加噪、去噪、迭代生成。
至于去噪网络 用什么架构,是另一个问题。
-
它可以是:
- U-Net;
- Transformer;
- Graph Neural Network;
- SE(3)-equivariant network;
- protein-specific structure network。
所以 Diffusion 和 Transformer 不是互斥关系。
U-Net 到 DiT
早期图像扩散模型常用 U-Net,因为 U-Net 擅长多尺度图像处理。
但随着模型规模变大,人们发现 Transformer 有更好的 scaling 潜力。
DiT 把图像 latent 切成 patches,然后用 Transformer block 处理这些 patches。它还通过 timestep embedding、class embedding、adaptive layer norm 等方式把扩散时间和条件信息注入模型。
DiT 的意义在于:
“ 扩散模型开始享受 Transformer 的 scaling law。 ”
这也是为什么后来图像、视频生成模型越来越多地采用 Transformer backbone。
Sora 这类视频模型虽然具体细节不完全公开,但整体趋势很明显:大规模生成模型正在从 U-Net 走向 Transformer / DiT 类架构。
为什么 AI4S 喜欢扩散模型?
“ 扩散模型在 AI4S 中非常自然,尤其是蛋白质、分子、材料这类任务。 ”
原因是科学对象往往不是简单的离散序列,而是有强全局约束的连续结构。
蛋白质结构是全局对象
蛋白质虽然有氨基酸序列,但它的功能来自 3D 折叠结构。
序列上相隔很远的残基,在空间中可能紧密接触。
自回归模型如果从左到右生成,很难天然保证整体结构一致性。
扩散模型则可以直接在 3D 坐标、残基 frame、距离图或结构 latent 上进行全局去噪。
RFdiffusion 就是典型代表。它把扩散模型用于蛋白质结构和功能设计,从随机噪声出发,迭代生成合理的蛋白质骨架。RFdiffusion 的 Nature 论文展示了 de novo protein structure and function design 的强大能力。
分子生成和材料设计也是连续约束问题
分子构象、原子坐标、键角、晶体结构都有连续几何约束。
扩散模型适合从随机结构开始,逐步调整到物理上更合理的结构。
相比自回归逐个原子生成,扩散模型更容易同时考虑全局几何、局部化学键、对称性和能量稳定性。
多样性是科学设计的核心需求
药物设计、蛋白质设计、新材料发现通常不是只要一个答案,而是希望生成大量候选,再筛选最优。
扩散模型从不同噪声出发,可以生成多样样本。
这种 stochastic generation 很适合探索设计空间。
扩散模型用于语言
文本和图像、蛋白质坐标不同。
图像像素、latent、坐标是连续变量,可以加高斯噪声。
文本 token 是离散变量,不能直接往 token id 上加高斯噪声。
所以语言扩散模型通常采用 离散扩散 或 masked diffusion。
Masked Diffusion 的基本思路
对于文本,前向过程不是加高斯噪声,而是逐渐把 token mask 掉。
例如原句:
法国 的 首都 是 巴黎加噪后可能变成:
法国 [MASK] 首都 [MASK] 巴黎噪声更强时:
[MASK] [MASK] [MASK] [MASK] [MASK]模型训练时要根据可见 token 和当前 mask 状态,预测被 mask 的 token。
生成时从全 mask 开始:
[MASK] [MASK] [MASK] [MASK] [MASK]每一步预测一部分 token,再根据置信度保留或重新 mask,逐渐得到完整句子。
这和自回归很不一样。
LLaDA:大语言扩散模型
LLaDA 是 2025 年出现的代表性大语言扩散模型之一。它采用 masked diffusion 方式进行预训练和指令微调。根据项目介绍,LLaDA 在预训练时会随机 mask token,训练模型从 masked sequence 中恢复原文本;采样时从高度 mask 状态逐步 unmask,并且可以灵活 remasking。
这类模型试图挑战一个长期假设:
“ 大语言模型一定要自回归吗? ”
LLaDA 的意义在于,它把扩散式并行修正机制带入大语言模型,让文本生成不再必须严格从左到右。
扩散语言模型的潜在优势
-
扩散语言模型可能有几个优势。
- 第一,它可以并行预测多个位置,不必严格串行生成。
- 第二,它可以反复修改之前预测的 token,因此更像全局规划。
- 第三,它适合填空、编辑、重写、约束满足、规划等任务。
- 第四,在一些 planning 或结构约束任务中,扩散式全局修正可能更自然。
扩散语言模型的挑战
不过,扩散语言模型还不成熟。
-
主要挑战包括:
- 生成步数仍然多;
- 如何控制长度和结束符更复杂;
- 离散 token 的去噪不如连续变量自然;
- 与现有 KV cache、streaming decoding、serving 系统兼容性差;
- 对齐、RLHF、安全机制都需要重新设计;
- 自回归模型生态太强,比较基线非常高。
所以,扩散语言模型是很有前景的方向,但短期内还不会轻易替代 GPT 类 AR 模型。
更合理的判断是:
“ AR 仍然是通用文本生成主流,Diffusion 可能在编辑、规划、并行生成、约束满足、多模态和科学生成中形成互补优势。 ”
扩散模型解决了哪些核心问题?
全局一致性
扩散模型每一步都可以更新整个样本,因此更适合全局结构强的任务。
图像需要全局构图,视频需要时空一致性,蛋白质需要三维折叠合理,分子需要化学结构稳定。
多样性
从不同噪声出发,可以生成不同样本。
这对创意生成和科学候选设计都非常重要。
连续数据建模
扩散模型天然适合连续空间。
图像 latent、音频波形、分子坐标、蛋白质结构、材料晶格,都可以作为连续变量去噪。
迭代修正
扩散模型不要求一步生成完美答案。
它允许先粗后细、逐步纠偏。
这使它非常适合“先有大致骨架,再细化局部”的问题。
扩散模型的局限
“ 扩散模型也不是银弹,对吧? ”
采样慢
传统扩散模型需要多步去噪,比自回归单步 logits 预测更复杂。
虽然 DDIM、DPM-Solver、consistency model、distillation 等方法可以加速,但速度仍然是重要问题。
训练和推理更复杂
扩散模型需要 noise schedule、time embedding、采样器、guidance、step schedule 等额外组件。
相比 AR 的 next-token prediction,工程系统更复杂。
文本离散性带来困难
连续扩散很自然,但文本是离散 token。
Masked diffusion 是一种解决方案,但还需要处理长度、mask 策略、remasking、confidence scheduling、采样稳定性等问题。
评估更复杂
图像可以看 FID、人评,蛋白质可以看结构稳定性和实验验证,文本则要看连贯性、事实性、推理能力、对齐、安全性。
扩散语言模型的评估体系还在发展中。
小结
扩散模型的本质可以概括为一句话:
“ 通过学习“如何从噪声中恢复数据”,把生成问题转化为一系列逐步去噪问题。 ”
-
在发展路线上,扩散模型经历了:
- DDPM:稳定的去噪训练目标;
- DDIM / solver:更快采样;
- Guided diffusion:更强条件控制;
- Latent Diffusion:在压缩潜空间中高效生成;
- DiT:用 Transformer 扩展扩散模型;
- RFdiffusion:扩散进入蛋白质设计;
- LLaDA / diffusion LLM:扩散开始挑战文本生成范式。
如果说 GPT 类模型代表了“序列生成”的极致扩展,那么扩散模型代表的是“迭代优化式生成”的强大路线。
它尤其适合那些需要全局一致性、连续几何、多样候选和逐步修正的任务。
-
未来很可能不是 AR 和 Diffusion 谁完全取代谁,而是二者在不同任务中形成互补:
- AR 继续主导通用语言生成和流式交互;
- Diffusion 在图像、视频、音频、蛋白质、分子、材料和结构化规划中继续扩大优势;
- DiT 和 diffusion LLM 则会把两条路线进一步融合。
笔者的话
“ AR和Diffusion各有千秋,就像一个人的不同的功能组件,同时互相辅助吸取改进经验,往更加广大的模型范式前进。 ”
参考文献
- Ho, Jain, Abbeel, 2020. Denoising Diffusion Probabilistic Models.
DDPM 的经典论文,建立现代扩散模型主流训练框架。
https://arxiv.org/abs/2006.11239
- Song, Meng, Ermon, 2020. Denoising Diffusion Implicit Models.
DDIM,提出更快的非马尔可夫采样方式。
https://arxiv.org/abs/2010.02502
- Dhariwal, Nichol, 2021. Diffusion Models Beat GANs on Image Synthesis.
Guided diffusion,提高条件图像生成质量。
https://arxiv.org/abs/2105.05233
- Rombach et al., 2022. High-Resolution Image Synthesis with Latent Diffusion Models.
Latent Diffusion / Stable Diffusion 的基础。
https://arxiv.org/abs/2112.10752
- Peebles, Xie, 2022. Scalable Diffusion Models with Transformers.
DiT,用 Transformer 替代 U-Net 作为扩散模型 backbone。
https://arxiv.org/abs/2212.09748
- Watson et al., 2023. De novo design of protein structure and function with RFdiffusion.
扩散模型用于蛋白质结构与功能设计。
https://www.nature.com/articles/s41586-023-06415-8
- Austin et al., 2021. Structured Denoising Diffusion Models in Discrete State-Spaces.
离散状态空间扩散模型的重要工作。
https://arxiv.org/abs/2107.03006
- Nie et al., 2025. Large Language Diffusion Models.
LLaDA,代表性 diffusion language model。
https://arxiv.org/abs/2502.09992
- Peebles & Xie DiT project page.
DiT 的项目说明和实现。
https://www.wpeebles.com/DiT
- LLaDA project page.
LLaDA 的项目展示与 masked diffusion language modeling 说明。
https://ml-gsai.github.io/LLaDA-demo/