Transformer|架构演进(5):Position Encoding 系统(2)——相对位置编码
阅读提示: 嗨嗨嗨,这里是我们进入RoPE最后的缓冲期——相对位置编码。我们将看遍有代表性的位置编码内容,请抓稳扶手,继续出发喽。祝食用愉快~🦆
导言
图 1 相对位置编码
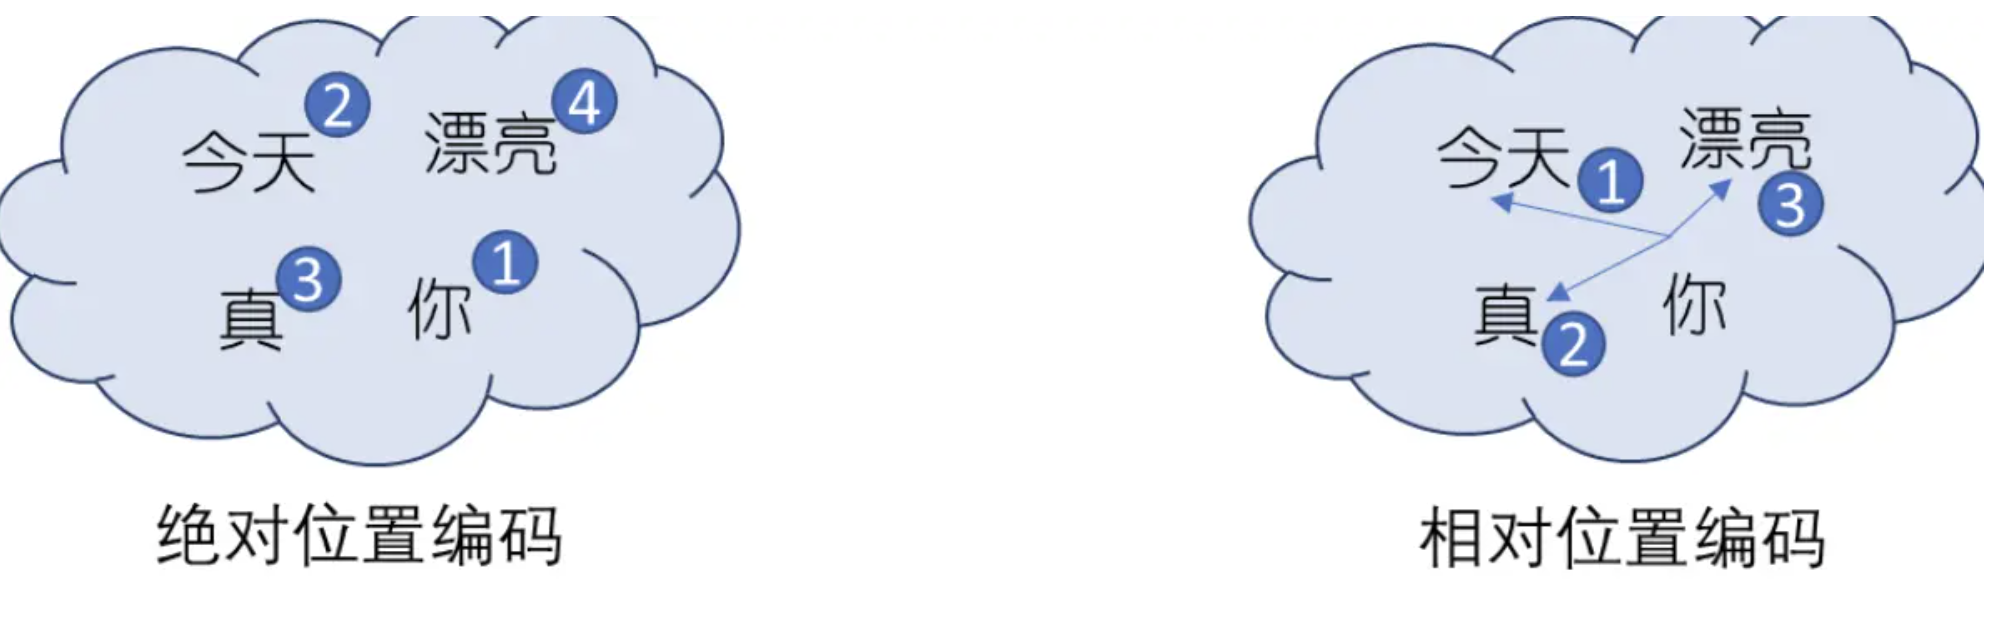
上一篇我们讲了绝对位置编码。
绝对位置编码的核心思想很直观:给每个位置一个向量,然后和 token embedding 相加。原始 Transformer 使用正弦位置编码,BERT、GPT-2 等模型则常用 learned absolute position embedding。
这种方法解决了 Transformer 的第一个问题:
“ 模型不知道 token 的顺序。 ”
但是,它没有很好解决第二个问题:
“ 模型如何理解两个 token 之间的相对距离? ”
在语言建模中,很多关系不是由“绝对位置”决定的,而是由“相对位置”决定的。
绝对位置编码的局限
“ 我们先来回顾一下上一个blog的内容 ”
在 absolute positional encoding 中,输入是:
其中:
- 是第 个 token 的内容 embedding;
- 是第 个位置的位置 embedding。
之后 attention 会计算:
位置影响 attention 的方式,是通过 和 混入 、 后间接产生的。
这意味着,如果模型想知道两个 token 相距多少,它需要从两个绝对位置向量 和 中自己推断出 或 。
这不是不可能,但不够直接。
Self-Attention 本质上是在建模 token pair 之间的关系。既然 attention score 本来就是在比较位置 和位置 ,那更自然的做法是:
“ 直接把 和 的相对距离放进 attention score 里。 ”
这就是 relative positional encoding 的基本动机。
相对位置编码
标准 attention score 是:
它只看 query 内容和 key 内容的相似度。
相对位置编码希望 score 不只依赖内容,还依赖相对距离:
于是更一般的形式可以写成:
不同方法的区别在于:这个 到底怎么加。
-
大致有几种方式:
- 用相对位置向量参与 key/value 计算,例如 Shaw et al.;
- 重新分解 attention score,支持跨 segment 记忆,例如 Transformer-XL;
- 只给 attention logits 加一个相对距离 scalar bias,例如 T5;
- 更进一步把 content 和 position 解耦,例如 DeBERTa;
- 简化成固定线性距离惩罚,例如 ALiBi。
Shaw et al.
“ 相对位置编码的经典起点是 Shaw et al. 2018 的 Self-Attention with Relative Position Representations。 ”
它的核心思想是:
“ Self-Attention 可以看成一个 fully-connected graph,每个 token 是一个节点,每两个 token 之间都有一条边。相对位置就是这条边上的特征。 ”
也就是说,位置 attend 到位置 时,不仅要看 的内容,还要看 和 的相对距离。
在 Key 里加入相对位置向量
标准 attention score 是:
Shaw et al. 给每个相对距离 分配一个可学习向量:
然后 attention score 变成:
展开就是:
第一项是内容匹配:query 和 key 的相似度。
第二项是位置匹配:query 和相对位置向量的相似度。
也就是说,模型在判断是否关注某个 token 时,会问:
“ 这个 token 内容是否相关? ”
还会问:
“ 这个 token 和我相隔这个距离是否合适呢? ”
这里就巧妙的把位置的信息融合到attention score的部分了
在 Value 里也加入相对位置向量
“ Shaw et al. 不只修改 attention score,还修改了 value 聚合。 ”
标准输出是:
加入相对位置后:
也就是说,模型从位置 读取信息时,不只读取内容 value,也读取一个和相对距离相关的 value 表示。
这使得相对距离不仅影响“注意力分数”,还影响“聚合进来的内容”。
裁剪距离
图 2 距离窗口的影响
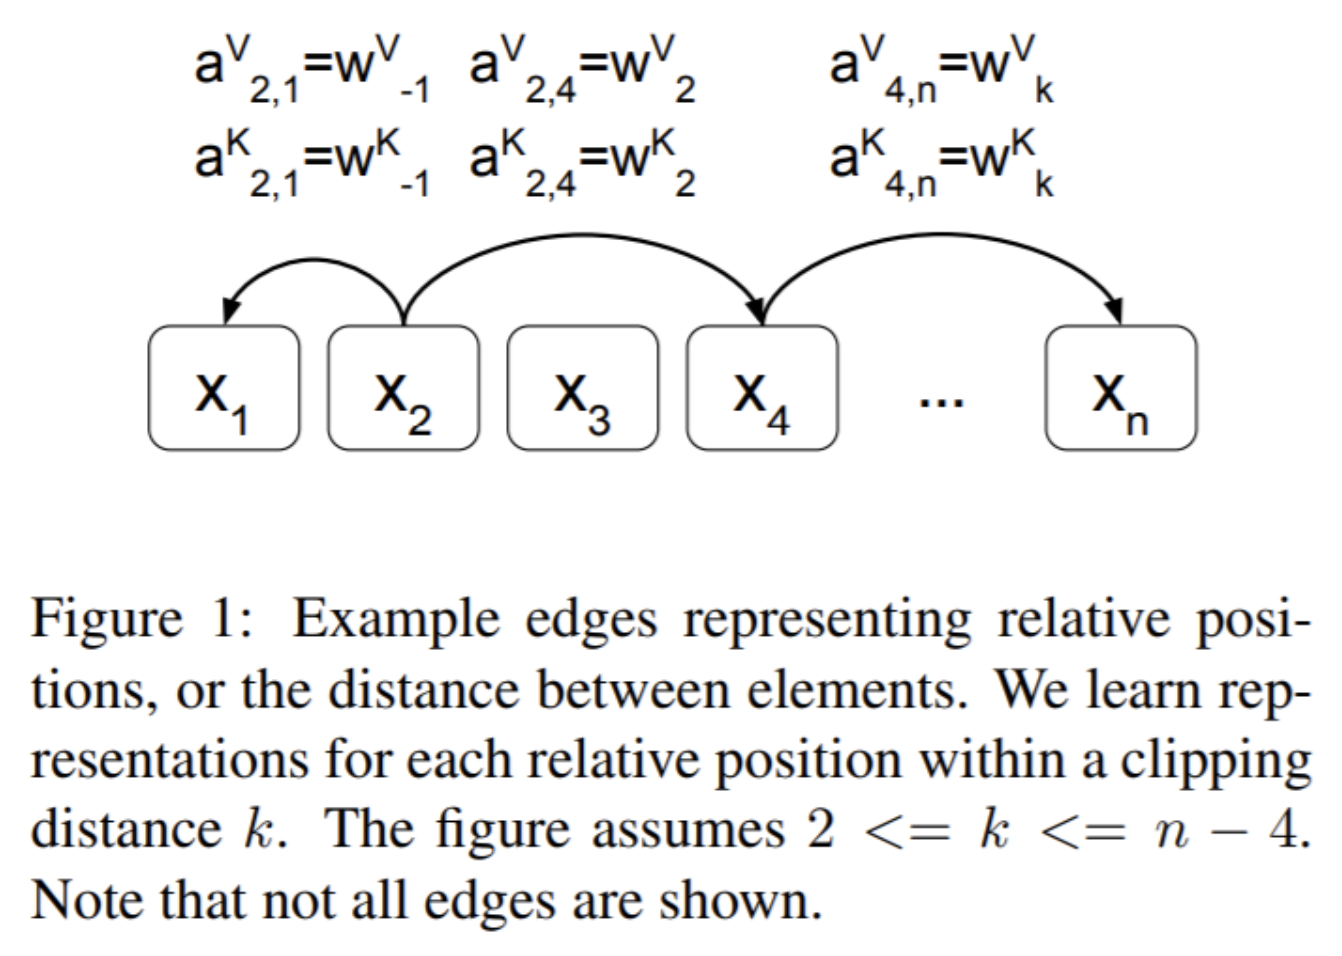
如果序列长度是 ,相对距离范围可能是:
如果每个距离都学习一个向量,长序列下参数很多,而且远距离样本稀疏。
因此 Shaw et al. 使用 clipping:
也就是说,只精细区分 范围内的相对距离,超过这个范围的距离统一归到边界桶。
这体现了一个很重要的归纳偏置:
“ 模型更需要精细地区分近距离关系,而远距离关系可以粗略处理。 ”
这也是后来 T5 relative position bucket 的思想基础之一。
相对位置编码解决了什么?
相比绝对位置编码,Shaw 方法的优势是:
- 它直接建模 token pair 的相对距离;
- 它更贴合 attention 的结构;
- 它对长度变化更自然,因为同一个相对距离可以在不同绝对位置复用;
- clipping 让模型对超过训练长度的一些位置有一定泛化能力。
例如,在训练时模型见过 position 10 attend 到 position 8,也见过 position 20 attend 到 position 18。它们相对距离都是 2。相对位置编码会复用同一个 ,这比绝对位置编码更容易学习。
Shaw 方法的局限
-
Shaw 方法也有代价。
- 第一,朴素实现会引入和 token pair 相关的相对位置向量,计算和显存更复杂。
- 第二,把相对位置向量加入 value 会让 KV cache 和增量生成更麻烦。现代 decoder-only LLM 更重视推理效率,因此不一定喜欢这种形式。
- 第三,它主要适合中等长度序列和 encoder/seq2seq 场景。对于现代 32K、128K 甚至更长上下文,光靠这种相对位置向量并不能解决 attention 计算成本和 KV cache 成本。
但它的历史意义非常重要:
“ 它把位置编码从“给每个位置一个向量”推进到“给每对 token 一个相对距离特征”。 ”
Transformer-XL
“ Shaw et al. 解决了相对距离建模,但 Transformer-XL 面对的是另一个问题:长文本语言模型如何跨 segment 保留记忆。 ”
普通 Transformer 的训练通常在固定长度片段上进行。比如每次处理 512 或 1024 token。片段之间的信息断开,模型很难建模超过片段长度的依赖。
Transformer-XL 提出了 segment-level recurrence:把上一段的 hidden states 缓存下来,作为下一段的 memory。
但这会带来一个位置问题。
为什么绝对位置在跨 segment 时会出问题?
假设每个 segment 长度是 4。
第一段位置是:
0 1 2 3第二段如果也重新编号为:
0 1 2 3那么第二段 token attend 到第一段 memory 时,就会出现位置混乱。不同 segment 中的 token 可能有相同绝对位置编号,但它们在全局文本中显然不是同一个位置。
如果给所有 segment 使用全局绝对位置,又会带来训练和推理中的长度外推问题。
所以 Transformer-XL 选择使用相对位置。
因为对当前 token 来说,真正重要的是:
“ memory 里的某个 token 距离当前 token 有多远。 ”
不是它的绝对编号是多少。
Transformer-XL 的 attention score 分解
Transformer-XL 重新参数化 attention score,把它分成几项。
-
简化理解,它包含四类信息:
- content-to-content:当前 token 内容和历史 token 内容的匹配;
- content-to-position:当前 token 内容和相对位置的匹配;
- global content bias:全局内容偏置;
- global position bias:全局位置偏置。
典型形式可以写成:
这里为了易读省略了一些投影矩阵。
-
四项的直觉分别是:
- :内容和内容是否相关;
- :当前 query 对这个相对距离是否敏感;
- :某些 key 内容是否整体更容易被关注;
- :某些相对距离是否整体更容易被关注。
Transformer-XL 的设计比 Shaw 更复杂,但目标也更明确:
“ 让模型在跨 segment recurrence 时仍然保持一致的位置关系。 ”
Transformer-XL 解决了什么?
Transformer-XL 的相对位置机制主要服务于长程语言建模。
它解决了两个问题。
第一,跨 segment 记忆时不再依赖绝对位置编号。
第二,模型可以复用历史 hidden states,从而突破固定上下文片段的限制。
这让 Transformer-XL 在长文本语言模型上非常有代表性。
Transformer-XL 的局限
“ Transformer-XL 的相对位置机制很强,但也比较复杂。 ”
它不是简单往 logits 加一个 bias,是对 attention score 进行多项分解,还需要 relative shift 等实现技巧。
此外,它主要诞生在 segment recurrence 语境下,而现代 decoder-only LLM 更多采用大上下文窗口 + KV cache 的方式。随着 RoPE 出现,现代 LLM 更倾向使用 RoPE 这种更简洁、更适配 KV cache 的方案。
但 Transformer-XL 的贡献非常重要:
“ 它证明了相对位置对长程依赖建模至关重要,也把位置编码和记忆机制联系了起来。 ”
T5 Relative Position Bias
“ T5 使用了更简洁的相对位置方法:Relative Position Bias。 ”
它不再给每个距离一个高维向量,也不修改 value,而是直接在 attention logits 上加一个标量偏置。
标准 attention score 是:
T5 改成:
如果是多头 attention,每个 head 可以有自己的 bias:
这里的 是可学习标量。
为什么只加一个 scalar bias 也有用?
“ Attention logits 决定 softmax 之后的注意力分布。 ”
- 如果某个相对距离的 bias 更大,那么模型更倾向关注这个距离上的 token。
- 如果某个相对距离的 bias 更小,那么模型不太倾向关注它。
这相当于给 attention 加了一个距离先验。
例如,在语言模型中,近处 token 通常更重要。模型可以学习到近距离 bucket 的 bias 更高,远距离 bucket 的 bias 更低。
这比 Shaw 方法简单很多。
Shaw 方法让相对位置参与 query-key 点积;T5 则直接让距离影响 attention logits。
为什么要 bucket?
“ 如果每个相对距离都学习一个 bias,长序列下距离数量很多,而且远距离样本稀疏。 ”
T5 使用 relative position bucket。
核心思想是:
“ 近距离精细区分,远距离粗略区分。 ”
例如,小距离可以单独分桶:
0, 1, 2, 3, 4, ...远距离则用对数尺度分桶:
8-11, 12-15, 16-23, 24-31, ...-
这样做的好处是:
- 近距离关系保留精度;
- 远距离关系减少参数;
- 对没见过的更长距离有一定泛化能力;
- 实现简单,计算便宜。
这和人类对距离的需求也有点类似。我们通常很在意“前一个词”和“前两个词”的差别,但对“前 800 个 token”和“前 850 个 token”的差别未必需要同样精细。
T5 Relative Bias 的优势
-
T5 Relative Position Bias 有几个优点。
- 第一,它非常简单。只是在 attention logits 上加一个 bias。
- 第二,它参数少。每个 head 只需要一张 bucket bias 表。
- 第三,它和 hidden dimension 解耦。不需要为每个距离学习一个 维向量。
- 第四,它适合 encoder-decoder 架构。T5 是 text-to-text 模型,在 encoder self-attention、decoder self-attention 中都可以自然使用 relative bias。
- 第五,它不像 learned absolute embedding 那样绑定到固定绝对位置表。
T5 Relative Bias 的局限
-
它的问题也很清楚。
- 第一,bucket 会丢失远距离的精确信息。如果很多远距离都落入同一个 bucket,模型无法区分它们的具体距离。
- 第二,它主要给 attention 一个距离偏置,但没有像 RoPE 那样在 Q/K 几何结构中编码位置。
- 第三,对于超长上下文,bucket 通常会饱和。超过最大 bucket 的距离可能被映射到同一类,长距离分辨率有限。
所以 T5 bias 很适合中长序列和 encoder-decoder 任务,但不是现代 decoder-only 长上下文 LLM 的唯一答案。
DeBERTa
“ DeBERTa 的 disentangled attention 也很值得放在相对位置编码的脉络里。 ”
它指出,绝对位置编码把 token 内容和位置直接相加:
这会让内容和位置纠缠在一起。但内容和位置其实是两种不同信息。
于是 DeBERTa 将它们分开建模。
-
它的 attention score 中包含不同类型的交互:
- content-to-content:内容和内容;
- content-to-position:内容 query 和相对位置;
- position-to-content:位置 query 和内容 key。
简化写成:
这里上标 表示 content, 表示 position。
DeBERTa 的重点不是简单加一个相对距离 bias,而是更明确地区分内容表示和位置表示。
它想解决的问题是:
“ token 内容和 token 位置不应该在输入层简单混合,而应该在 attention 中以不同交互方式建模。 ”
不过,DeBERTa 主要影响的是 encoder-style 预训练模型,而不是今天主流 decoder-only LLM 的位置编码路线。
相对位置编码和绝对位置编码的区别
现在可以总结两者的区别。
绝对位置编码问的是:
“ token 在第几个位置? ”
相对位置编码问的是:
“ query 和 key 相距多少? ”
绝对位置编码通常加在输入端:
相对位置编码通常进入 attention 内部:
这使得相对位置编码更贴合 attention 的 pairwise 结构。
不同相对位置方法的对比
- 可以把几种典型方法放在一起看。
| 方法 | 位置进入方式 | 表示形式 | 优点 | 局限 |
|---|---|---|---|---|
| Shaw et al. | 加入 key/value | 相对距离向量 | 显式建模 token-pair 距离 | 计算和缓存复杂 |
| Transformer-XL | attention score 分解 | 相对距离向量 + 全局 bias | 支持 segment recurrence 和长程依赖 | 公式和实现复杂 |
| T5 Relative Bias | 加到 logits | per-head scalar bucket bias | 简单高效,参数少 | 远距离分辨率有限 |
| DeBERTa | 内容/位置解耦交互 | disentangled relative position | 表达能力强 | 结构较复杂,非主流 LLM 路线 |
共同点是:都不满足于只告诉模型绝对位置,而是试图让 attention 更直接地感知 token 之间的相对距离。
从相对位置到 ALiBi 和 RoPE
“ 相对位置编码之后,有两条非常重要的后续路线。 ”
第一条是 ALiBi。
ALiBi 把相对位置进一步简化:不学习位置向量,也不学习 bucket bias,而是直接给 attention score 加一个和距离成比例的线性惩罚。
它的想法是:距离越远,attention score 越低。这种 recency bias 对语言模型很有效,并且有较好的长度外推表现。
第二条就是 RoPE。
RoPE 不直接加 bias,而是把 Q/K 放进旋转位置空间。它用旋转矩阵编码位置,使 attention score 自然依赖相对距离。
现代 LLM 大量采用 RoPE,并在此基础上发展出 NTK Scaling、YaRN、LongRoPE 等长上下文扩展方法。
为什么现代 LLM 后来更多使用 RoPE?
“ 啊啦,到这里你是不是自然会有一个疑问:既然相对位置编码已经解决了很多问题,为什么现代 LLM 没有普遍使用 Shaw 或 T5 bias,而是大量转向 RoPE?主要原因有几个,让我们细细分解。 ”
1. RoPE 兼具绝对和相对性质
RoPE 对 Q/K 按绝对位置做旋转,但两个位置的 attention score 会自然依赖相对位置差。
这让它既有绝对位置注入方式,又在 attention score 中呈现相对距离结构。
2. RoPE 对 decoder-only 和 KV cache 友好
现代 LLM 主要是 decoder-only,自回归生成时需要 KV cache。
RoPE 只需要在生成 key/query 时应用旋转,缓存后的 key 已经包含位置信息,增量生成实现相对自然。
Shaw-style relative value 或复杂 attention 分解在推理工程上更麻烦。
3. RoPE 适合长上下文 scaling
虽然原始 RoPE 也有长度外推问题,但它可以通过 Position Interpolation、NTK Scaling、YaRN 等方法扩展上下文。
这让 RoPE 成为现代长上下文 LLM 的核心位置编码基础。
小结
相对位置编码是位置编码演化中的关键一步。它的核心思想是:
“ Attention 建模的是 token pair 之间的关系,因此位置信息也应该以 token pair 的相对距离形式进入 attention。 ”
- Shaw et al. 把相对距离表示成 key/value 中的可学习向量,让每个 query-key pair 都有相对位置特征。
- Transformer-XL 为了支持跨 segment 长程记忆,重新分解 attention score,让模型在复用历史 hidden states 时仍然能保持相对位置一致。
- T5 把相对位置进一步简化成 attention logits 上的 scalar bias,通过 bucket 机制兼顾近距离精度和远距离泛化。
- DeBERTa 则把内容和位置解耦,强调 content-position 的不同交互方式。
这些方法共同完成了一次重要转变:
“ 从“给每个位置一个向量”,转向“给每对 token 一个距离关系”。 ”
但相对位置编码仍然不能单独解决现代长上下文的所有问题。它不降低 attention 的 成本,也不减少 KV cache,还需要足够的长上下文数据和任务训练,模型才会真正学会使用远处信息。
笔者的话
“ 相对位置编码是相对早期的方法,你可以发现现在已经鲜有见到他们的身影,但是他们的贡献是实实在在的,如今的百花齐放的模型设计,就是这一步步探索的脚步所垒成的。有时候笔者也很理解痴迷于历史,痴迷于听书的人,看到前人精彩的故事纷呈,许多后人也追随着从历史中照见自己,有所体悟,有所思考,而论文不正是对一个领域历史进程权威的侧写吗? ”
参考文献
- Shaw et al., 2018. Self-Attention with Relative Position Representations.
相对位置表示的经典工作。
https://arxiv.org/abs/1803.02155
- Dai et al., 2019. Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context.
使用相对位置机制和 segment recurrence 支持长程语言建模。
https://arxiv.org/abs/1901.02860
- Raffel et al., 2020. Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer.
T5,使用 relative position bias。
https://arxiv.org/abs/1910.10683
- He et al., 2020. DeBERTa: Decoding-enhanced BERT with Disentangled Attention.
内容和位置解耦的相对位置建模。
https://arxiv.org/abs/2006.03654