Transformer|反向传播(Backpropagation)(6):缩放因子 √dₖ 与初始化哲学
阅读提示:前面我们推导 Attention 反向传播时,有一步被轻描淡写地带过了:除以 。你可能当时就接受了“防止 Softmax 饱和”这个解释。但如果你仔细想一想——为什么偏偏是 ?不是 ?不是 ?不是一个可学习的参数?这个看似简单的选择背后,其实藏着一整套关于初始化和训练稳定性的思考方式。这也许可以给你带来一些思考。祝食用愉快~😫
导言
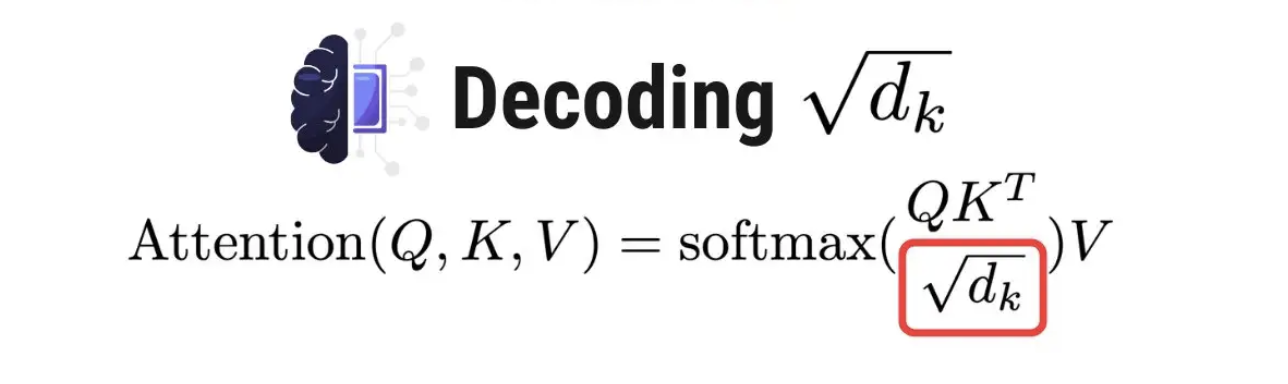
“ 先把问题摊开放在桌上。Attention 的缩放步骤是: ”
这里 是 Query 和 Key 的维度。
这个 是唯一正确的选择吗?
图 1 缩放因子
答案:不是。

实际上:
  - 有些模型用固定的 √d_k(原始 Transformer、GPT、LLaMA)
  - 有些模型用可学习的缩放因子(T5)
  - 有些模型把缩放吸收进 W_Q 的初始化里(某些变体)
  - 有些模型甚至完全不做缩放(但需要其他补偿手段)
那为什么 成了默认选择?要回答这个问题,我们需要先理解一个更根本的事情:初始化时的方差控制。
问题:训练开始时,数值应该多大?
为什么初始化很重要?
“ 训练开始之前,所有参数都是随机初始化的。这些随机值决定了第一次前向传播时,每一层的输出数值大小。 ”
如果初始化不合理:
情况1:数值逐层爆炸

第1层输出:标准差 = 1
第2层输出:标准差 = 5
第3层输出:标准差 = 25
...
第10层输出:标准差 = 9,765,625
→ 数值溢出,Loss 变成 NaN,训练直接崩溃

情况2:数值逐层萎缩

第1层输出:标准差 = 1
第2层输出:标准差 = 0.2
第3层输出:标准差 = 0.04
...
第10层输出:标准差 = 0.0000001
→ 所有神经元的输出几乎为 0,梯度也接近 0,模型学不到东西
“ 初始化的核心目标:让每一层的输出标准差保持稳定,既不爆炸也不萎缩。 ”
方差分析
单个线性层的方差传播
考虑一个线性层 ,其中:
- 的每个元素:均值 ,方差
- 的每个元素:均值 ,方差
- 和 互相独立
的一个元素 是:
每一项 的方差是:
“ 这里用到了一个统计学结论:两个独立的均值为 的随机变量的乘积,方差等于两个方差的乘积。 ”
项求和后:
“ 如果我们不做任何特殊处理,让 : ”
输出方差被放大了 倍。 就是输入维度。
初始化的解决方案:让
“ 如果我们让 的每个元素从 中采样: ”
输出方差和输入方差完全一样。数值不会爆炸也不会萎缩。
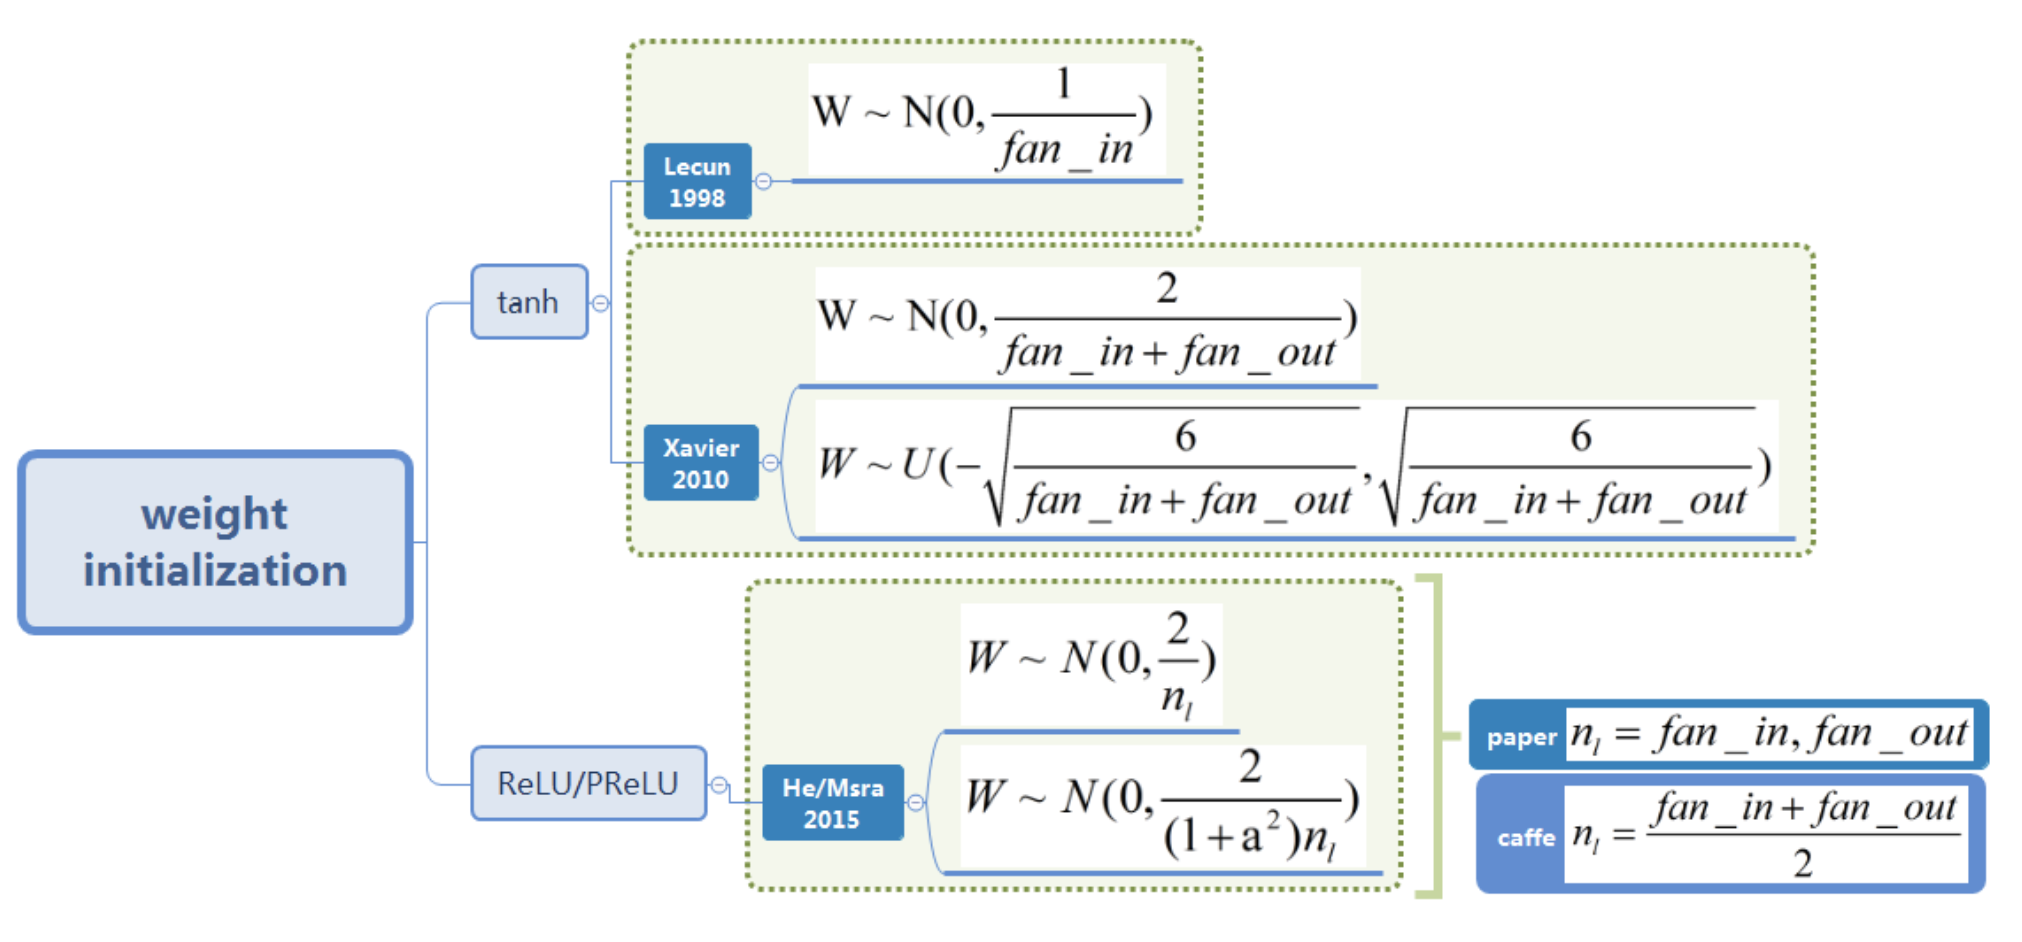
这就是 Xavier 初始化(也叫 Glorot 初始化)的核心思想:
“ 让每个元素的方差等于 ,这样矩阵乘法之后方差不变。 ”
更精细的版本
Xavier 只考虑了前向传播。如果同时考虑反向传播中梯度的方差传播,最优的初始化是:
这是原始 Xavier 初始化的完整形式。
对于 ReLU 激活函数,由于它会把一半的值(负数)设为 ,等效地减少了活跃的输入数量,所以需要补偿:
这就是 Kaiming 初始化(也叫 He 初始化)。
总结:
  Xavier 初始化:σ² = 1/n_in            适合 sigmoid/tanh
  Kaiming 初始化:σ² = 2/n_in           适合 ReLU

  核心思想完全一样:让输出方差 ≈ 输入方差
  只是针对不同激活函数做了不同的补偿
图 2 初始化方法汇总
回到点积的方差分析
“ 现在我们用同样的方差分析方法,来看看 Attention 的打分 会发生什么。 ”
点积的方差推导
是 和 的点积:
假设初始化良好, 和 的每个元素都是均值 、方差 的随机变量(或者至少方差是某个常数 ,后面我们先用 来分析)。
每一项 的方差:
项求和后:
标准差:
所以当 时, 的数值标准差约为 。当 时,约为 。
这些数值进入 Softmax 会怎样?
Softmax 对数值的绝对大小非常敏感:
S 的标准差 ≈ 1 时(数值范围大概 [-3, 3]):
  Softmax([1.2, 2.1, 0.5]) = [0.25, 0.60, 0.15]
  → 分布比较平滑,梯度正常

S 的标准差 ≈ 8 时(数值范围大概 [-20, 20]):
  Softmax([2.1, 18.5, 1.3]) = [0.000, 1.000, 0.000]
  → 分布退化成 one-hot,梯度几乎为 0

  为什么梯度几乎为 0?回忆 Softmax 的梯度公式:
  Δ_z[s] = p_s ⊙ (δ_s - Σⱼ δⱼpⱼ)

  当 p_s ≈ [0, 1, 0] 时:
  - p_s 的大部分元素接近 0
  - 逐元素乘以 p_s 后,大部分位置的梯度被压成 0
  - 只有一个位置有梯度,其他位置完全学不到东西
除以 的效果
缩放之后,不管 是 还是 还是 , 的方差恒为 ,标准差恒为 。
d_k = 32:   Std(S) = 5.66  → 除以 5.66  → Std = 1
d_k = 64:   Std(S) = 8.00  → 除以 8.00  → Std = 1
d_k = 128:  Std(S) = 11.31 → 除以 11.31 → Std = 1
Softmax 的输入始终在一个“舒适”的数值范围内,梯度可以正常流动。
更深一层: 和初始化的关系
为什么前面假设 和 的元素方差是 ?
“ 因为如果 和 使用了合理的初始化(比如 Xavier),那么: ”
如果输入 的方差为 (经过 RMSNorm 之后通常接近这个值),那么 的元素方差也约为 。
所以 这个值,其实依赖于一整条初始化链的正确性:
RMSNorm → x 的方差 ≈ 1
Xavier 初始化 W_Q → Q 的元素方差 ≈ 1
Xavier 初始化 W_K → K 的元素方差 ≈ 1
点积求和 d_k 项 → S 的方差 = d_k
除以 √d_k → S_scaled 的方差 = 1
如果这条链中的任何一环断了(比如初始化不合理,或者 RMSNorm 被去掉了), 就不再是“正确”的缩放值。
训练过程中,方差还是 吗?
当然不是。训练开始后, 和 都在更新, 和 的元素方差会偏离 。
但这不影响训练,原因有两个:
原因1:√d_k 提供了正确的量级

  即使实际方差不是精确的 1,而是 0.7 或 1.3
  S_scaled 的方差也只是 0.7·d_k/d_k = 0.7 或 1.3
  仍然在 Softmax 的"舒适区"内

  √d_k 消除的是 d_k 带来的量级差异(可能是几十到几百倍)
  方差的小幅波动(零点几倍)不是问题

原因2:模型会自我调节

  W_Q 和 W_K 是可学习参数
  如果 S_scaled 的数值分布不合适
  损失函数会通过反向传播告诉 W_Q 和 W_K:"你们的输出太大了/太小了"
  参数会自动调整到一个合适的范围

  √d_k 只是给了一个好的起点
  剩下的交给训练过程自己搞定
缩放的其他方案
“ 不是唯一的选择。来吧,让我们看看其他模型怎么做的: ”
方案一:可学习的缩放因子(T5 模型)
T5 模型不使用固定的 ,而是用一个可学习的标量:
其中 是一个可学习参数,初始化为某个值,训练过程中通过反向传播自动调整。
反向传播时, 的梯度是:
优点:模型可以自己学到最优的缩放值
缺点:多了一个超参数需要初始化
      在训练早期,α 的值可能不稳定
方案二:把缩放吸收进 的初始化
不在计算时除以 ,而是在初始化 时就把缩放因子考虑进去:
这样 的元素方差就变成了 ,点积之后的方差自然就是 ,不需要额外缩放。
效果等价于除以 √d_k
但缩放被"藏"进了初始化里,前向计算少了一步除法方案三:(某些变体)
有些模型不除以 (每个头的维度),而是除以 (完整的模型维度):
在多头 Attention 中,。所以:
这相当于在 的基础上,额外除以了 ,缩放更激进。
方案四:完全不缩放(QK-Norm)
还有一种方法:不在点积之后缩放,而是对 和 本身做归一化:
归一化之后, 和 的每一行的均方根长度都是 。点积的范围自然被控制住了,不需要额外缩放。
优点:不需要依赖 √d_k 的假设
      在训练过程中持续保证 Q 和 K 的尺度稳定
缺点:额外的计算开销(两次 RMSNorm)
      改变了 Attention 的计算图,可能影响模型表现
共同思路
虽然具体方法不同,但它们都在解决同一个问题:
控制 Softmax 输入的数值范围,保证梯度正常流动
固定缩放 √d_k:     最简单,依赖初始化假设,实践中足够好
可学习缩放 α:       更灵活,但初始化需要额外考虑
初始化吸收:         计算更简洁,但初始化更复杂
QK-Norm:           最鲁棒,但计算开销更大
选择哪种方案,更多是工程权衡,不是数学上的对错。
缩放的反向传播
“ 不管用哪种缩放方案,反向传播的推导都很直接。我们以标准的 为例完整走一遍。 ”
前向:
这是每个元素独立的标量除法。
反向:
写成矩阵形式:
对于可学习缩放 :
注意这里 的梯度是一个标量,是所有位置的贡献求和的结果。
从缩放看 Transformer 设计的整体哲学
“ 缩放只是 Transformer 中众多“稳定训练”设计的一个缩影。让我们把所有类似的设计列出来,看看它们的共同模式: ”
1. 前向传播中的数值稳定手段
RMSNorm / LayerNorm:
  目的:把每一层的输入标准化到稳定范围
  位置:每个子模块之前(Pre-Norm)
  原理:除以均方根,让标准差 ≈ 1

√d_k 缩放:
  目的:把注意力分数标准化到稳定范围
  位置:Q·K^T 之后,Softmax 之前
  原理:除以 √d_k,让标准差 ≈ 1

残差连接:
  目的:保持信号的量级不因层数增加而失控
  位置:每个子模块周围
  原理:x_out = x_in + f(x_in),子模块只提供增量

权重初始化:
  目的:让第一次前向传播的数值分布合理
  时机:训练开始前
  原理:W ~ N(0, 1/n_in),让矩阵乘法不改变方差
2. 反向传播中的梯度稳定手段
Pre-Norm(而非 Post-Norm):
  目的:保证残差直路上的梯度不被 Norm 处理
  效果:梯度可以不衰减地流过任意多层

√d_k 缩放:
  目的:保证 Softmax 不饱和
  效果:Softmax 的梯度不会因为输入过大而消失

SiLU(而非 ReLU):
  目的:保证激活函数不会完全阻断梯度
  效果:所有通道都能传递一些梯度

残差路径的特殊初始化(GPT-2 的 1/√(2N) 缩放):
  目的:让训练初期子模块的输出接近 0
  效果:残差相加后数值稳定
共同模式
所有这些设计都在做同一件事:
  控制数值的尺度(scale),让它在整个网络中保持稳定

前向传播:控制激活值的尺度 → 防止数值爆炸/萎缩
反向传播:控制梯度的尺度   → 防止梯度爆炸/消失

这两个方向是对称的:
  前向传播中数值稳定 → 反向传播中梯度也更可能稳定
  因为梯度是数值的函数,数值乱了,梯度也会乱
小结
“ 朋友,现在我们可以给出一个比较完整的回答了。 ”
是一个基于初始化假设推导出的、在量级上正确的缩放因子。
-
它是精确的吗?
- 只在初始化假设严格成立时(Q、K 元素方差 = 1)才是精确的
- 训练过程中,假设不再精确成立
-
它是必要的吗?
- 如果不做缩放,d_k 很大时 Softmax 会饱和,梯度消失
- 某种形式的缩放是必要的
-
它是唯一正确的吗?
- 不是,有很多替代方案(可学习缩放、QK-Norm 等)
- 它只是最简单、最经典、实践中足够好的选择
-
它为什么有效?
- 初始化时,它精确地让 S 的方差 = 1
- 训练过程中,它消除了 d_k 对数值量级的影响
- 模型的其他参数(W_Q、W_K)会通过训练自动适应这个缩放
笔者的话
“ 一个小小的放缩因子居然有这么多可说的,真令人惊讶啊!在巨大的架构中,一个小小的设计细节都有可能决定了全局,何尝不是那“丢了一颗马钉”导致“亡了一个国家”的滑坡惨剧的再次上演。不过在这里,笔者实话说,我们的缩放因还是要子显得更加诚信与合理一些~ ”
参考资料
- Laurent Bou´,Deep learning for pedestrians: backpropagation in Transformers
- Stanford lecture,cs336(2025-2026)