Transformer|反向传播(Backpropagation)(5):残差连接与归一化的选择
阅读提醒:前面我们推导了 Transformer 反向传播的完整主干。但有一个关键细节被一笔带过了——RMSNorm 到底放在哪里?这个看似微小的设计选择,直接影响了梯度能不能顺畅地流过几十层网络。这篇我们来彻底搞清楚。接下来我们要拿起放大镜来看细节了。祝食用愉快~🥱
导言:归一化的种类和演化
为什么需要归一化?
图 1 归一化示意图
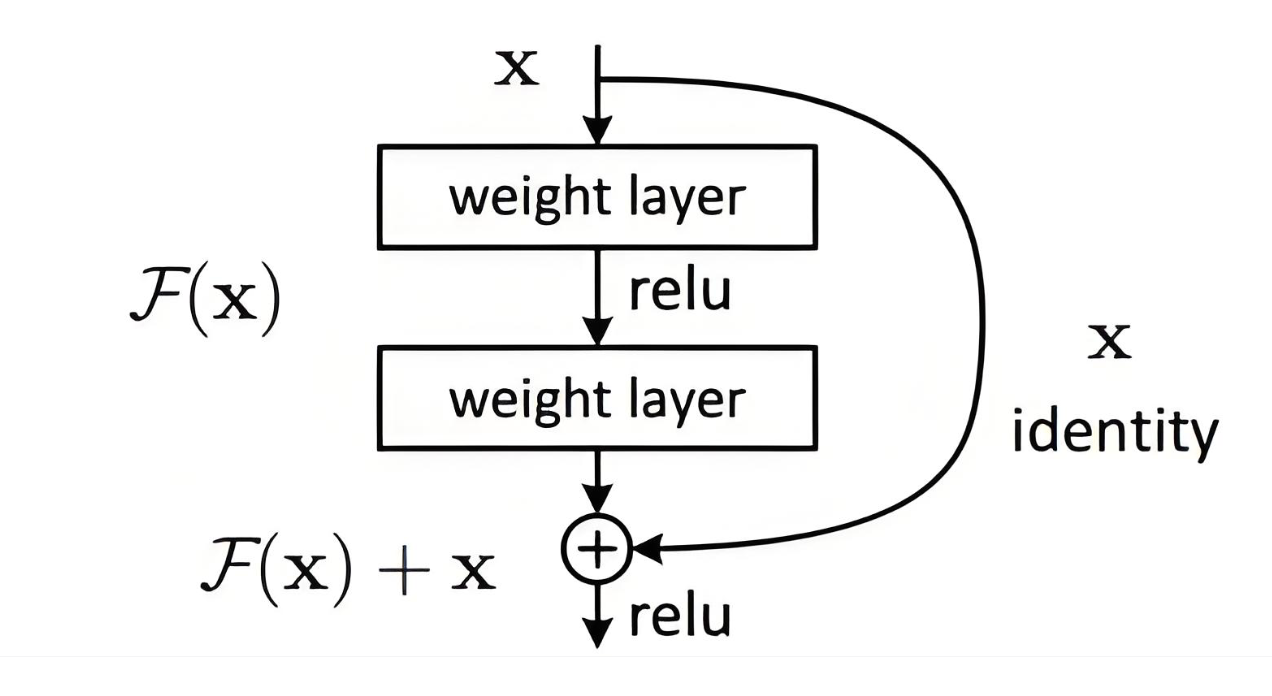
“ 神经网络是一层叠一层的结构。每一层的输出是下一层的输入。如果某一层的输出数值分布发生了剧烈变化(比如突然变得很大或很小),下一层就会对此措手不及: ”
第1层输出:[0.5, -0.3, 0.8]       ← 正常范围
第2层处理后:[15.2, -9.7, 22.1]    ← 突然变大了
第3层处理后:[502, -318, 891]      ← 继续膨胀
...
第10层:[NaN, NaN, NaN]            ← 爆炸了
归一化就是在每一层之间“踩一脚刹车”,把数值拉回稳定的范围。
主要的归一化方法
图 2 多种归一化图示
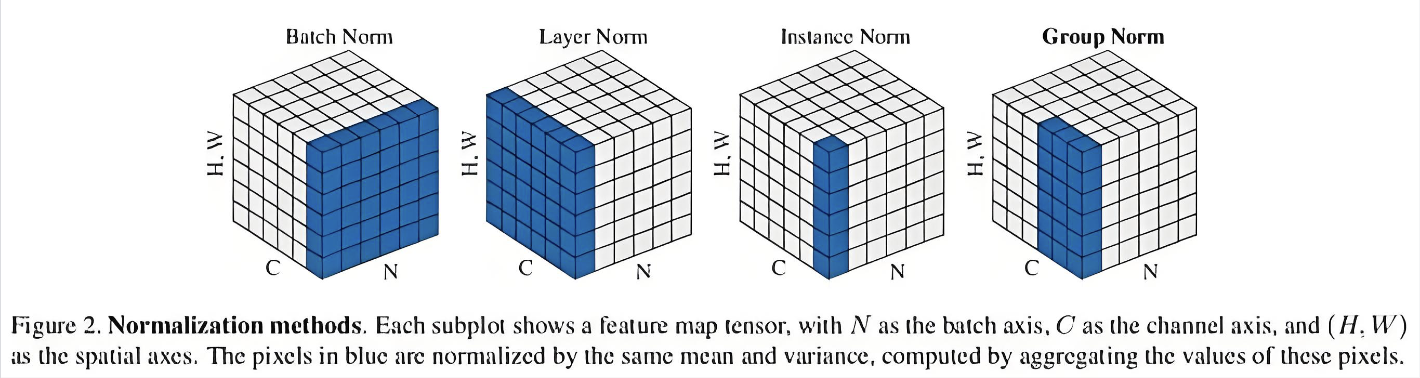
BatchNorm(2015):
  对一个 batch 里同一个特征维度做归一化
  在 CV 里很成功,但在 NLP 里有问题:
    - 不同句子长度不一,batch 统计量不稳定
    - 推理时 batch size 为 1,统计量不可靠

LayerNorm(2016):
  对同一个样本的所有特征维度做归一化
  不依赖 batch,适合 NLP
  原始 Transformer(2017)用的就是这个

RMSNorm(2019):
  LayerNorm 的简化版,去掉了均值中心化,只做缩放
  计算更快,效果相当甚至更好
  现在的主流选择(LLaMA、Qwen、Gemma 等)
LayerNorm 和 RMSNorm 的区别:
LayerNorm:
  μ = mean(x)
  σ = std(x)
  x̂ = (x - μ) / σ          ← 先减均值,再除标准差
  output = γ ⊙ x̂ + β       ← 两个可学习参数 γ 和 β

RMSNorm:
  rms = sqrt(mean(x²))
  x̂ = x / rms               ← 只除均方根,不减均值
  output = γ ⊙ x̂            ← 只有一个可学习参数 γ
为什么 RMSNorm 更受欢迎?
1. 计算量更小:少了 mean 和 β 的计算
2. 实践中效果相当:减均值这一步似乎没那么必要
3. 大模型里每一点计算节省都很重要
“ 但比归一化方法更重要的问题是:归一化放在哪里? ”
两种位置:Post-Norm vs Pre-Norm
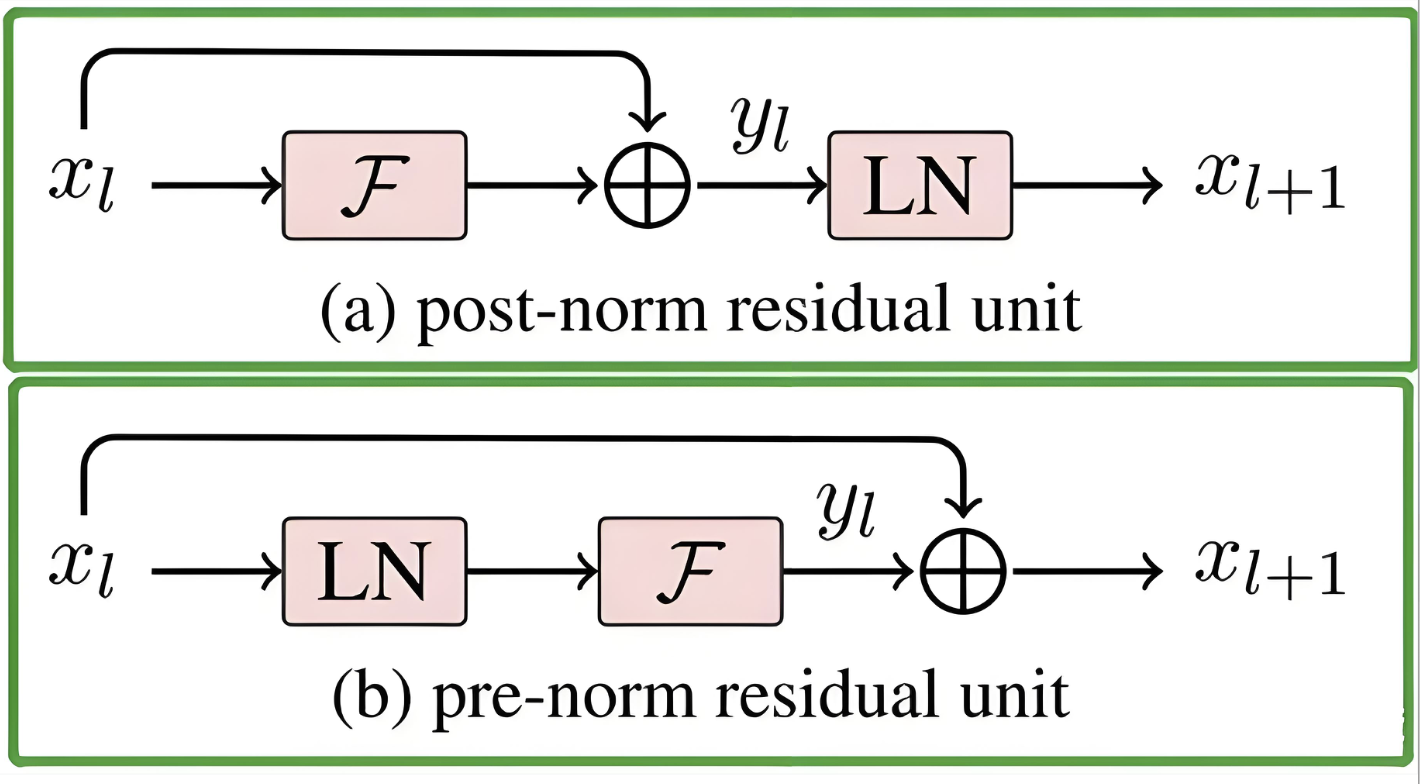
Post-Norm vs Pre-Norm
Post-Norm(原始 Transformer,2017)
归一化放在残差相加 之后:
x_in
│
├───────────────────────┐
│                       │(残差直通)
▼                       │
子模块(Attention/FFN) │
│                       │
▼                       │
x_sub                   │
│                       │
▼                       │
x_mid = x_in + x_sub ←─┘(残差相加)
│
▼
LayerNorm(x_mid)            ← Norm 在加法之后
│
▼
x_out
Pre-Norm(GPT-2 开始,现在主流)
归一化放在残差相加 之前(子模块之前):
x_in
│
├───────────────────────┐
│                       │(残差直通)
▼                       │
RMSNorm(x_in)           │
│                       │
▼                       │
x_norm                  │
│                       │
▼                       │
子模块(Attention/FFN) │
│                       │
▼                       │
x_sub                   │
│                       │
▼                       │
x_out = x_in + x_sub ←─┘(残差相加,之后没有 Norm)关键区别:在 Pre-Norm 里,残差相加之后不再有任何变换。
为什么选择 Pre-Norm?答案在反向传播里
“ 要理解这个问题,我们得先彻底搞清楚残差连接的反向传播。 ”
残差连接
前向传播的本质
残差连接做的事情极其简单:
其中 是子模块(Attention 或 FFN)。
这个加法意味着:
输出 = 原始输入 + 子模块的增量
打个比方:
  x_in = 你原来的理解
  f(x_in) = Attention/FFN 提供的新信息
  x_out = 原来的理解 + 新信息

  子模块不是在“替换”你的理解,而是在“补充”你的理解
反向传播
由:
对 求导:
所以:
展开:
拆成两部分:
残差直路为什么如此重要?
第一项:
完全不经过任何变换,直接从输出传到输入。
假设我们有 层 Transformer Block,每层都有残差连接。
没有残差连接时:

Δ_output ──→ f_N'(·) ──→ f_{N-1}'(·) ──→ ... ──→ f_1'(·) ──→ Δ_input

梯度要经过 N 个函数的导数连乘
如果每个导数 < 1:0.9^32 = 0.035
如果每个导数 > 1:1.1^32 = 21.1


有残差连接时:

Δ_output ──────────────────────────────────────→ Δ_input(直路)
    │           │           │           │
    └→ f_N' ──→ └→ f_{N-1}'→ └→ ... ──→ └→ f_1'(支路)
这就是残差连接的核心价值:
它提供了一条不受任何变换影响的梯度直通路径。
Norm 的位置问题
Post-Norm 的梯度流动
x_in
│
├─────────── 直路 ──────────┐
│                           │
▼                           │
Attention/FFN               │
│                           │
▼                           │
x_sub                       │
│                           │
▼                           │
+ ←─────────────────────────┘
│
▼
LayerNorm
│
▼
x_out
反向传播:
Δ_x_out
│
▼
LayerNorm 反向传播
│
Δ_after_norm
│
├─── 直路:Δ_x_in_residual = Δ_after_norm
│
└─── 子模块路:经过 Attention/FFN 反向传播
问题在于:
直路梯度也必须经过 LayerNorm。
回忆 LayerNorm 的反向传播:
这里有:
- 除以
- 减均值修正
- 特征耦合
所以:
每经过一层 Post-Norm:
  梯度被缩放
  梯度被修正

经过很多层后:
  梯度可能已经严重失真
Pre-Norm 的梯度流动
x_in
│
├─────────── 直路 ──────────────────────────────┐
│                                               │
▼                                               │
RMSNorm                                          │
│                                               │
▼                                               │
Attention/FFN                                   │
│                                               │
▼                                               │
x_sub                                            │
│                                                │
▼                                                │
x_out = x_in + x_sub ←──────────────────────────┘
反向传播:
Δ_x_out
│
├─── 直路:Δ_x_in_residual = Δ_x_out
│
└─── 支路:
     Attention/FFN 反向传播
            ↓
        RMSNorm 反向传播
            ↓
     Δ_x_in_via_sub

最终:
Δ_x_in = Δ_x_out + Δ_x_in_via_sub
关键区别:
直路梯度:
完全不经过 Norm。
经过 32 层 Pre-Norm:

直路梯度:
  完全不变

支路梯度:
  可能放大或缩小

最终梯度:
  直路保底 + 支路修正
用具体例子来看差异
假设:
每层 Norm 把梯度缩放成原来的 。
Post-Norm
第4层 → Δ = 1.0 × 0.8 = 0.80
第3层 → Δ = 0.80 × 0.8 = 0.64
第2层 → Δ = 0.64 × 0.8 = 0.51
第1层 → Δ = 0.51 × 0.8 = 0.41
32 层:
梯度几乎消失。
Pre-Norm
第4层 → Δ = 1.0
第3层 → Δ = 1.0
第2层 → Δ = 1.0
第1层 → Δ = 1.0
不管多少层:
始终完整。
Pre-Norm 有没有缺点?
“ 既然我都这么问了,那答案当然是有。 ”
问题 1:最终输出没有经过 Norm
Pre-Norm 每层输出:
残差不断累加,数值可能逐渐漂移。
解决方案: 最后再加一个 RMSNorm:
Transformer Block 1
│
Transformer Block 2
│
...
│
Transformer Block N
│
▼
Final RMSNorm
│
▼
W_lm · x → logits
现在主流模型都这么做。
问题 2:理论上 Post-Norm 表达能力可能更强
一些研究认为:
- 小模型
- 浅层网络
- 精细调参
下,Post-Norm 有时效果更好。
但大模型训练更重视:
训练稳定性所以现代模型几乎都选择:
Pre-RMSNorm + 残差连接 + Final RMSNorm一个 Block 里的两层残差
Block 输入:x_in

  ├── Attention 残差
  │   x_mid = x_in + Attention(Norm(x_in))

  ├── FFN 残差
  │   x_out = x_mid + FFN(Norm(x_mid))

Block 输出:x_out
反向传播会产生多条路径:
路径1:两个残差都走直路
路径2:Attention 走支路
路径3:FFN 走支路
路径4:Attention + FFN 都走支路
最终梯度:
其中:
路径1提供永不衰减的保底梯度。
例:32 层 Transformer 的梯度路径
如果:
- 32 个 Block
- 每个 Block 2 个残差
则共有:
条可能路径。
虽然不会真的枚举,但这说明:
残差连接创造了指数级多的梯度路径

即使绝大多数路径衰减
只要有一条直路畅通
整体梯度就不会消失
残差连接对初始化的影响
残差层:
训练开始时希望:
于是:
网络初始状态接近恒等映射。
例:GPT-2 的初始化
普通初始化:
残差路径最后一层:
其中:
- 是 Block 数
- 每个 Block 有 2 个残差
额外的:
会让初始输出更小。
拓展:其他归一化策略
Sandwich Norm
图 3 Sandwich Norm
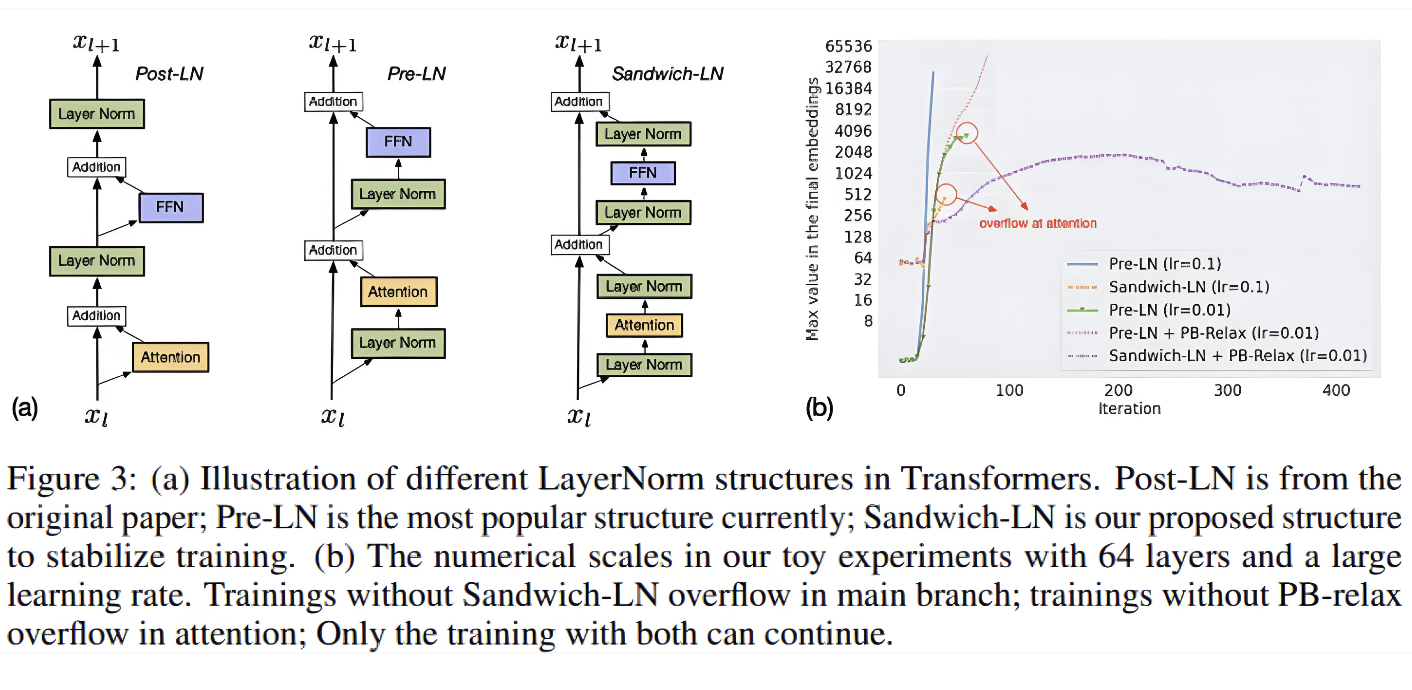
x_in
│
├──────────────────────────┐
│                          │
▼                          │
RMSNorm_before             │
│                          │
▼                          │
Attention/FFN              │
│                          │
▼                          │
RMSNorm_after              │
│                          │
▼                          │
+ ←────────────────────────┘
│
▼
x_out
目的:
- 防止输出过大
- 增强稳定性
代价:
- 更多计算
- 更多参数
DeepNorm
修改残差连接:
其中:
例如:
效果:
普通残差:
  x + f(x)

DeepNorm:
  αx + f(x)

直路信号更强
深层训练更稳定
反向传播:
直路梯度被放大。
小结
“ 回答我们最开始的问题:为什么选择Pre Norm? ”
1. 深层网络会梯度消失
   ↓
2. 残差连接提供梯度高速公路
   ↓
3. Post-Norm 把 Norm 放在直路上
   ↓
4. 梯度每层都会被 Norm 干扰
   ↓
5. 深层训练不稳定
   ↓
6. Pre-Norm 把 Norm 放在支路
   ↓
7. 梯度直路完全畅通
   ↓
8. 深层 Transformer 可以稳定训练
最终方案:
Pre-RMSNorm + 残差连接 + Final RMSNorm放回到完整反向传播图景中
Loss
│
▼ Softmax + CrossEntropy
Δ_logits
│
▼ 输出投影层
│
▼ Final RMSNorm
│
▼ Transformer Block N
│
│  ┌─── 残差直路 ──────────────────────┐
│  │                                   │
│  │      梯度完整保留                  │
│  │                                   │
│  ▼                                   │
│  RMSNorm → FFN → 支路梯度            │
│  │                                   │
│  └────────── 汇合 ───────────────────┘
│
│  ┌─── 残差直路 ──────────────────────┐
│  │                                   │
│  │      梯度完整保留                  │
│  │                                   │
│  ▼                                   │
│  RMSNorm → Attention → 支路梯度      │
│  │                                   │
│  └────────── 汇合 ───────────────────┘
│
▼ Transformer Block N-1
│
▼ ...
│
▼ Transformer Block 1
│
▼ Embedding
残差连接让梯度可以从最后一层一路畅通地流到第一层。 Pre-Norm 则保证: 这条路上没有任何障碍物。 这就是现代 Transformer 能稳定训练几十层、上百层的根本原因。
笔者的话
“ 现在进入了我们对细节内容的探索,希望对Norm的深入讨论能让你对整体的理解更加深入与透彻。很多时候一些看起来“确实是这样”的选择,背后其实存在更多深处的原因,不管是在数学中还是人生中,我们只是缺少了一些参悟的决心。 ”
参考资料
- Laurent Bou´,Deep learning for pedestrians: backpropagation in Transformers
- Stanford lecture,cs336(2025-2026)