Transformer|反向传播(Backpropagation)(4):Self-Attention 联合推导与整体总结
阅读提醒:这是整个系列最重要的一篇。前面我们推导了线性层的两个核心公式,看到了 FFN 里 token 独立传播的干净结构。现在这些工具都要用上——但 Attention 会把它们推到一个新的复杂度:token 之间的耦合。就是我们在Softmax和RMSNorm中初步见过的情况,相信仔细理解完这篇之后能让你对Transformer的架构有一个更深刻的了解。现在,Attention is all you need! 祝食用愉快~ 😈
导言:Attention 为什么是核心?
“ Transformer 之所以叫 Transformer,根本原因不是它有多少层,也不是它的参数有多大,而是 Self-Attention 这个机制。 ”
图 1 2017 aigc改变世界的原点:Attention is all you need
FFN 处理每个 token 时,完全不知道其他 token 的存在。但语言的意义从来不是孤立的:
比如:
"The animal didn't cross the street because it was too tired."

"it" 指的是 animal 还是 street?

FFN 看到 "it" 这个词,只能靠 "it" 本身的 embedding 来判断。
Attention 让 "it" 去看整句话,发现 "tired" 更靠近生物属性,
从而正确地把注意力指向 "animal"。
这种“让每个词去参考整个上下文”的能力,就是 Self-Attention 提供的。
而从反向传播的角度来看,Attention 也是最有挑战性的部分——因为每个 token 的输出都依赖所有 token 的输入,误差的传播不再是简单的直线,而是网状扩散。
回顾已有的工具
“ 在开始作战✍️之前,先把我们手上的兵器都点一遍: ”
工具1:线性层的两个核心公式
  对于 y = x · W:
  ∂L/∂W = x^T · Δ_y        ← 参数的梯度
  Δ_x = Δ_y · W^T          ← 误差继续往前传

工具2:对 token 耦合的理解
  FFN 里 token 独立 → 误差直线传播
  Attention 里 token 耦合 → 误差网状扩散
  耦合的本质:一个参数影响了多个输出,梯度要把所有路径加起来
Attention 的反向传播,本质上就是把工具1反复应用到一个有耦合的结构上。
Single-Head Attention 的完整前向传播
“ 我们用 Single-Head Attention 来推导,结构最清晰。同时笔者会全程使用具体例子解说,来防止你因为维度形状的变化而感到吃力😥。我们假设: ”
seq_len = 3(三个 token:"The"、"king"、"sat")
d_model = 4(每个 token 的向量维度)
d_k = 2    (Q 和 K 的投影维度)
d_v = 2    (V 的投影维度)
输入 ,形状 ,来自上一个模块(经过 RMSNorm 之后的 )。
完整前向传播
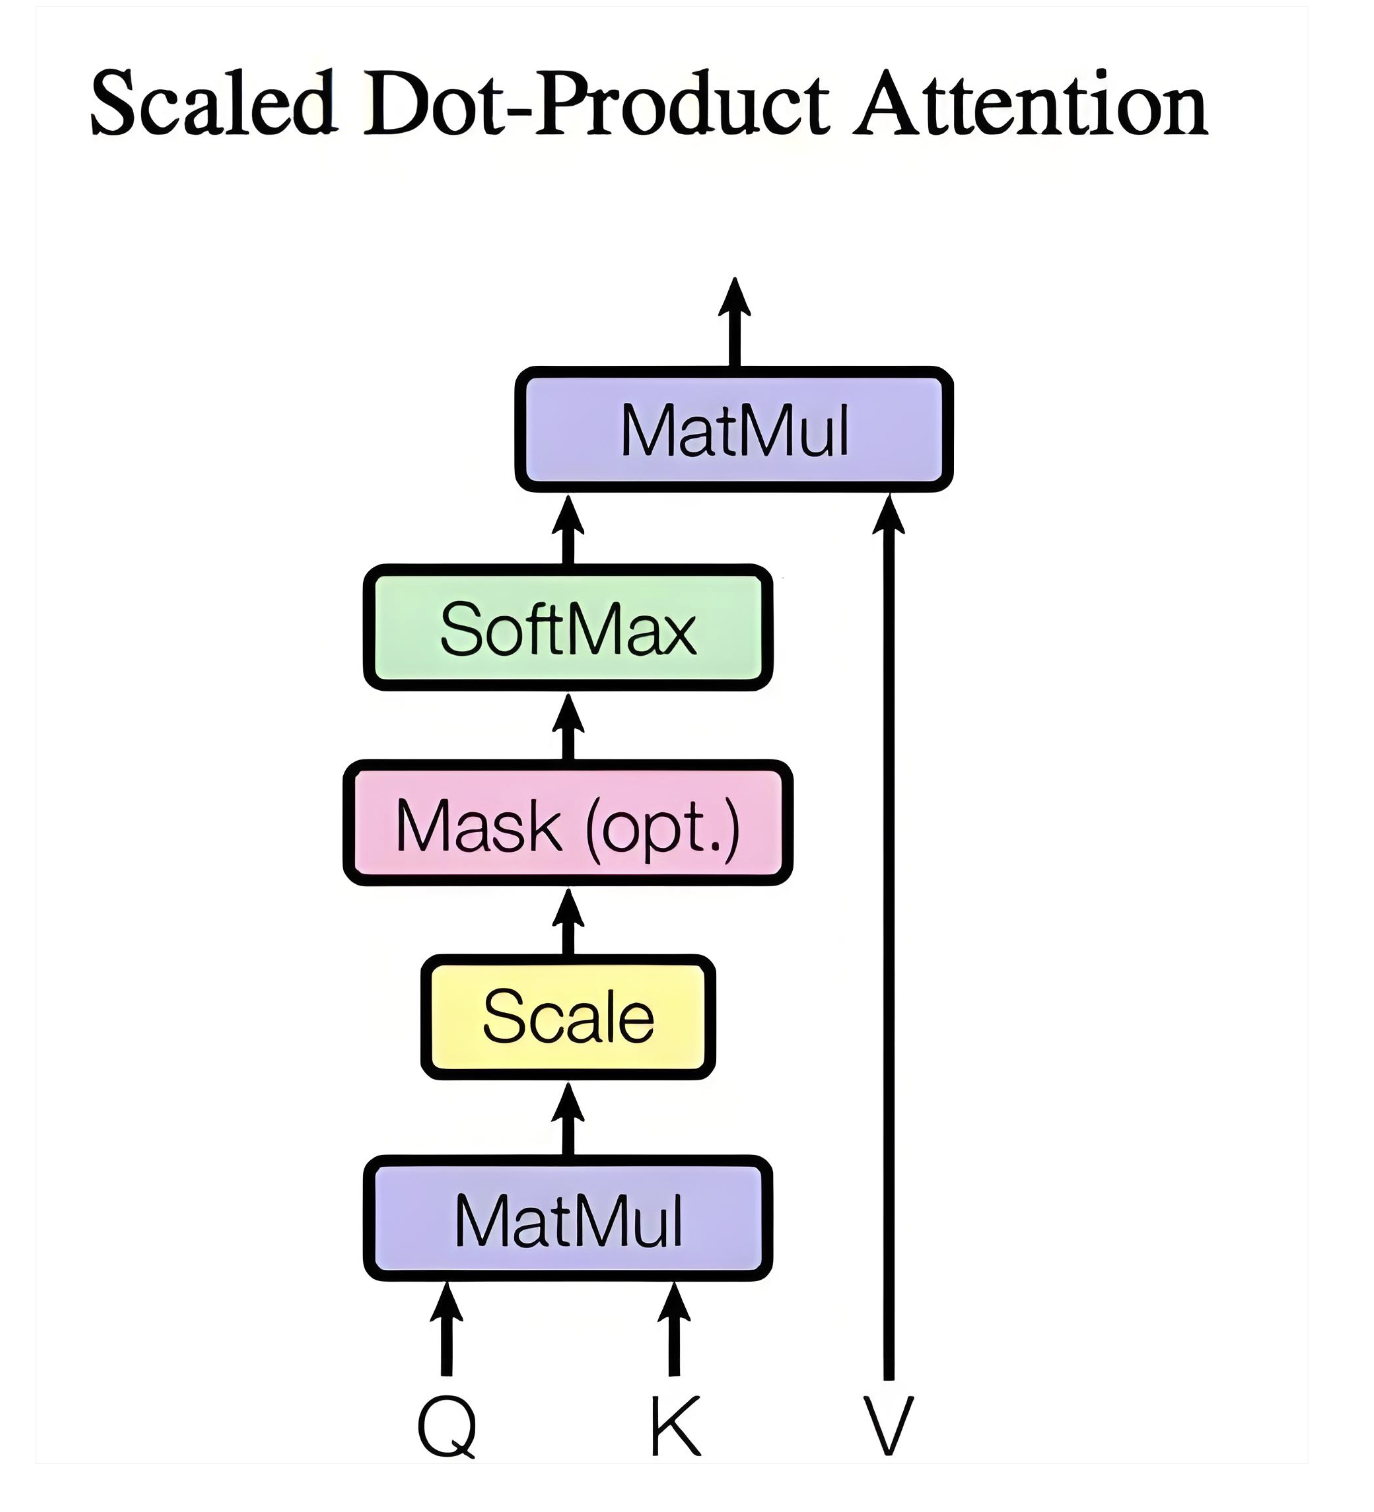
Attention内部架构
第一步:三个线性投影
Q = x · W_Q    [3×4] · [4×2] = [3×2]    ← 每个 token 的"我想找什么"
K = x · W_K    [3×4] · [4×2] = [3×2]    ← 每个 token 的"我能提供什么标签"
V = x · W_V    [3×4] · [4×2] = [3×2]    ← 每个 token 的"我实际提供的内容"

第二步:计算原始注意力分数
S = Q · K^T    [3×2] · [2×3] = [3×3]    ← S[s][t] = token s 对 token t 的相似度

第三步:缩放
S_scaled = S / √d_k = S / √2             ← 防止点积值过大导致 Softmax 饱和

第四步:Softmax
P = Softmax(S_scaled)    [3×3]           ← P[s][t] = token s 对 token t 的注意力权重
                                            每一行加起来 = 1

第五步:加权求和
output = P · V    [3×3] · [3×2] = [3×2] ← 每个 token 的输出是所有 V 的加权和
用图来看整体结构:
x [3×4]
│
├─── · W_Q [4×2] ──→ Q [3×2] ──→ Q · K^T ──→ S [3×3]
│                                               │
├─── · W_K [4×2] ──→ K [3×2] ──┘                │
│                                           / √d_k
│                                               │
│                                          Softmax
│                                               │
│                                           P [3×3]
│                                               │
└─── · W_V [4×2] ──→ V [3×2] ──────────→ P·V   ─┘
                                                │
                                          output [3×2]
现在我们从 出发,倒着走每一步。
反向传播
第五步:
从上层传来 ,形状 。
这是一个矩阵乘法 ,直接用线性层公式:
形状验证:
Δ_V:P^T [3×3] · Δ_output [3×2] = [3×2]  ← 和 V 的形状一样 ✓
Δ_P:Δ_output [3×2] · V^T [2×3] = [3×3]  ← 和 P 的形状一样 ✓
第一个耦合点: 里的 token 混合
在 FFN 里, 只依赖 。但在 Attention 里:
token 0 的输出,用了所有三个 token 的 。
反向传播时,(token 1 的内容向量)被所有 token 的输出引用过,所以它的误差要从所有输出的误差里汇集:
Δ_V[0] ← 来自 output[0] 的误差 × P[0][0]
        + 来自 output[1] 的误差 × P[1][0]
        + 来自 output[2] 的误差 × P[2][0]

Δ_V[1] ← 来自 output[0] 的误差 × P[0][1]
        + 来自 output[1] 的误差 × P[1][1]
        + 来自 output[2] 的误差 × P[2][1]
这正好是 。
“ 朋友,现在我们要兵分两路了: ”
一路:拿着 Δ_V,去追查 V 的来源(W_V 投影层)
另一路:拿着 Δ_P,去追查 P 的来源(Softmax)
第四步:
我们已经有了 ,形状 。
Softmax 对每一行独立操作,反向传播也是每行独立计算(行与行之间没有耦合)。
对于第 行,设 (长度为3的向量),:
其中 是一个标量( 和 的点积)。
“ 这个公式我们上一篇推导过了,这里我们要学习“拿来主义”的精神。 ”
第二个耦合点:同一行内 token 之间的耦合
注意 Softmax 的耦合方向和 不一样:
P · V 的耦合:跨行(不同 token 的输出之间通过 V 相互影响)

Softmax 的耦合:行内(同一行里,不同位置的注意力权重互相约束)
                因为 P[s][0] + P[s][1] + P[s][2] = 1
                一个变大,其他的必须变小
第三步:
除以常数的反向传播,就是乘以同一个常数:
第二步:
“ 注意注意⚠️:这是整个 Attention 反向传播里耦合最复杂的一步。 ”
的形状是 ,其中每个元素:
表示:token 的 Query 和 token 的 Key 的相似度。
先看 Q 的误差:
(token 的 Query 向量)参与了 的整个第 行的计算:
所以 的总误差,要把第 行所有列的误差贡献加起来:
对所有 合并:
形状:,和 一样 ✓
再看 K 的误差:
(token 的 Key 向量)参与了 的整个第 列的计算:
所以 的总误差,要把第 列所有行的误差贡献加起来:
对所有 合并:
形状:,和 一样 ✓
用图理解 Q 和 K 的耦合
S 矩阵(3×3):

        K[0]   K[1]   K[2]
Q[0] │ S[0][0] S[0][1] S[0][2] │ ← Q[0] 参与了整行
Q[1] │ S[1][0] S[1][1] S[1][2] │ ← Q[1] 参与了整行
Q[2] │ S[2][0] S[2][1] S[2][2] │ ← Q[2] 参与了整行
       ↑        ↑        ↑
    K[0]参与  K[1]参与  K[2]参与
    了整列    了整列    了整列


反向传播时:

Q[0] 的误差 ← 来自第0行所有列的误差(和所有 K 有关)
Q[1] 的误差 ← 来自第1行所有列的误差(和所有 K 有关)

K[0] 的误差 ← 来自第0列所有行的误差(和所有 Q 有关)
K[1] 的误差 ← 来自第1列所有行的误差(和所有 Q 有关)
这就是 Attention 里最核心的耦合:每个 Q 和所有 K 都“打过交道”,每个 K 和所有 Q 都“打过交道”。反向传播时,误差沿着所有这些“交道”反向流回去。
第一步:三个线性投影层
现在我们手上有三路误差:
Δ_Q  [3×2]    ← 从 Q·K^T 步骤传来
Δ_K  [3×2]    ← 从 Q·K^T 步骤传来
Δ_V  [3×2]    ← 从 P·V 步骤传来
每一路都是一个独立的线性层,分别用线性层公式:
Q 投影层:
K 投影层:
V 投影层:
三路误差在 x 处汇合
同时“兼职”了三个角色,三条路的误差全部加回来:
“ 这里和 FFN 有本质区别: FFN 里 兼职了两个角色(gate 和 up),每个角色的误差是在同一个 token 内部汇合的。 Attention 里 兼职了三个角色(Q、K、V),而且每个角色的误差来自所有 token 的计算结果——K 路线上,token 的误差来自 矩阵第 列的所有行,也就是说所有其他 token 的 Query 都对 的梯度有贡献。 ”
完整流程图
Δ_output [3×2]
│
▼  output = P · V
Δ_V = P^T · Δ_output    [3×3]·[3×2] = [3×2]
Δ_P = Δ_output · V^T    [3×2]·[2×3] = [3×3]
│              │
│    ▼  P = Softmax(S_scaled)
│    Δ_S_scaled[s] = p_s ⊙ (δ_s - Σⱼδⱼpⱼ)   (逐行)
│    │
│    ▼  S_scaled = S / √d_k
│    Δ_S = Δ_S_scaled / √d_k    [3×3]
│    │
│    ▼  S = Q · K^T
│    Δ_Q = Δ_S · K              [3×3]·[3×2] = [3×2]
│    Δ_K = Δ_S^T · Q            [3×3]·[3×2] = [3×2]
│    │         │
│    │  ▼  Q = x · W_Q          ▼  K = x · W_K
│    │  ∂L/∂W_Q = x^T·Δ_Q      ∂L/∂W_K = x^T·Δ_K   → 优化器
│    │  Δ_x_via_Q               Δ_x_via_K
│    │
│    ▼  V = x · W_V
│    ∂L/∂W_V = x^T·Δ_V                              → 优化器
│    Δ_x_via_V
│
▼  三路汇合
Δ_x = Δ_x_via_Q + Δ_x_via_K + Δ_x_via_V    [3×4]
│
▼  继续往前(经过 RMSNorm,然后和残差直路汇合)
Q、K、V 三个线性层的关系
笔者认为这里有必要把三个投影层的角色分工说清楚,因为它们虽然结构一样,但意义完全不同:
W_Q(Query 投影):
  作用:把 x 变成"我想找什么"的向量
  参与的计算:S = Q · K^T(计算注意力分数)
  梯度来源:Δ_S 的第 s 行(token s 的 Query 和所有 K 打交道的结果)

W_K(Key 投影):
  作用:把 x 变成"我有什么标签"的向量
  参与的计算:S = Q · K^T(计算注意力分数)
  梯度来源:Δ_S 的第 t 列(token t 的 Key 被所有 Q 查询过的结果)

W_V(Value 投影):
  作用:把 x 变成"我实际提供的内容"的向量
  参与的计算:output = P · V(加权求和)
  梯度来源:P^T · Δ_output(被关注得越多,误差贡献越大)
Q 和 K 是一对——它们共同决定注意力分数,梯度的计算也深度耦合( 依赖 的值, 依赖 的值)。
V 是独立的一路——它不参与注意力分数的计算,只提供内容,梯度计算相对干净。
拓展:多头 Attention(Multi-Head Attention)
“ Single-Head Attention 让每个 token 从一个角度关注其他 token。但现实中,一个词和其他词的关系可以有很多维度: ”
"John loves Mary because she is kind."

从语法角度:  "she" 指向 "Mary"(主语替代关系)
从语义角度:  "loves" 和 "kind" 有情感关联
从依存角度:  "because" 连接了两个子句
一个注意力头只能捕捉一种模式。多头 Attention 就是同时用多个注意力头,从多个角度关注:
Multi-Head Attention:

head 1:Q₁=x·W_Q1, K₁=x·W_K1, V₁=x·W_V1 → output₁   (可能关注语法)
head 2:Q₂=x·W_Q2, K₂=x·W_K2, V₂=x·W_V2 → output₂   (可能关注语义)
...
head h:Qₕ=x·W_Qh, Kₕ=x·W_Kh, Vₕ=x·W_Vh → outputₕ  (可能关注位置)

把所有头的输出拼起来:
concat = [output₁, output₂, ..., outputₕ]    [seq_len × (h·d_v)]

再做一个线性投影压回原维度:
final_output = concat · W_O                   [seq_len × d_model]
反向传播时怎么处理?
每个头完全独立地做我们上面推导的那套流程,然后在 的线性层处汇合。 的反向传播就是我们最熟悉的线性层公式,没有新东西。(你在期待又会出现什么新的推导式子嘛?放轻松~😚)
拓展:Causal Mask(因果掩码)
“ 我们知道:在语言模型里,我们不能让一个词“看到”它后面还没生成的词(否则就是作弊了)。这通过 Causal Mask 实现: ”
图 2 Mask掩码简易示意图
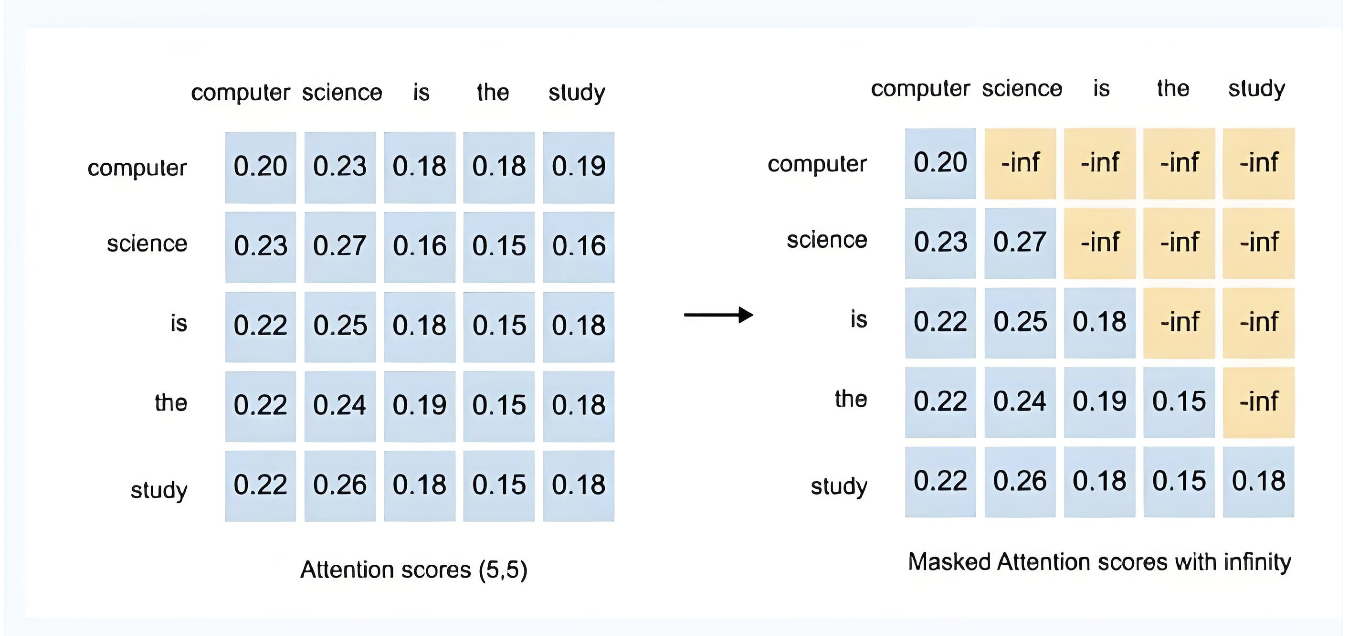
Softmax 之前,把 S_scaled 里"不该看到的位置"设为 -∞:

S_scaled(加 mask 之前):
│ S[0][0]  S[0][1]  S[0][2] │
│ S[1][0]  S[1][1]  S[1][2] │
│ S[2][0]  S[2][1]  S[2][2] │

加 mask 之后(上三角设为 -∞):
│ S[0][0]  -∞       -∞      │  ← token 0 只能看自己
│ S[1][0]  S[1][1]  -∞      │  ← token 1 能看 0 和 1
│ S[2][0]  S[2][1]  S[2][2] │  ← token 2 能看所有
经过 Softmax 之后, 的位置变成 ,相当于这些位置的注意力权重为 。
反向传播时怎么处理?
被 mask 掉的位置,,所以这些位置对输出没有贡献,误差也不会通过这些位置传回去。
Δ_S_scaled[s][t] = 0 (如果这个位置被 mask 了)“ Mask 相当于在反向传播时直接“断路”——被遮住的路径,前向传播时没有信号通过,反向传播时也没有梯度通过。这是不是很好理解? ”
最后一站:Embedding 层
“ 让我们一鼓作气,啃完了Attention后,误差经过所有 Transformer Block 的层层传递,最终到达网络的入口——Embedding 层。这里的反向传播非常简单,你会发现你几乎看看就可以理解了~ ”
Embedding 在做什么?
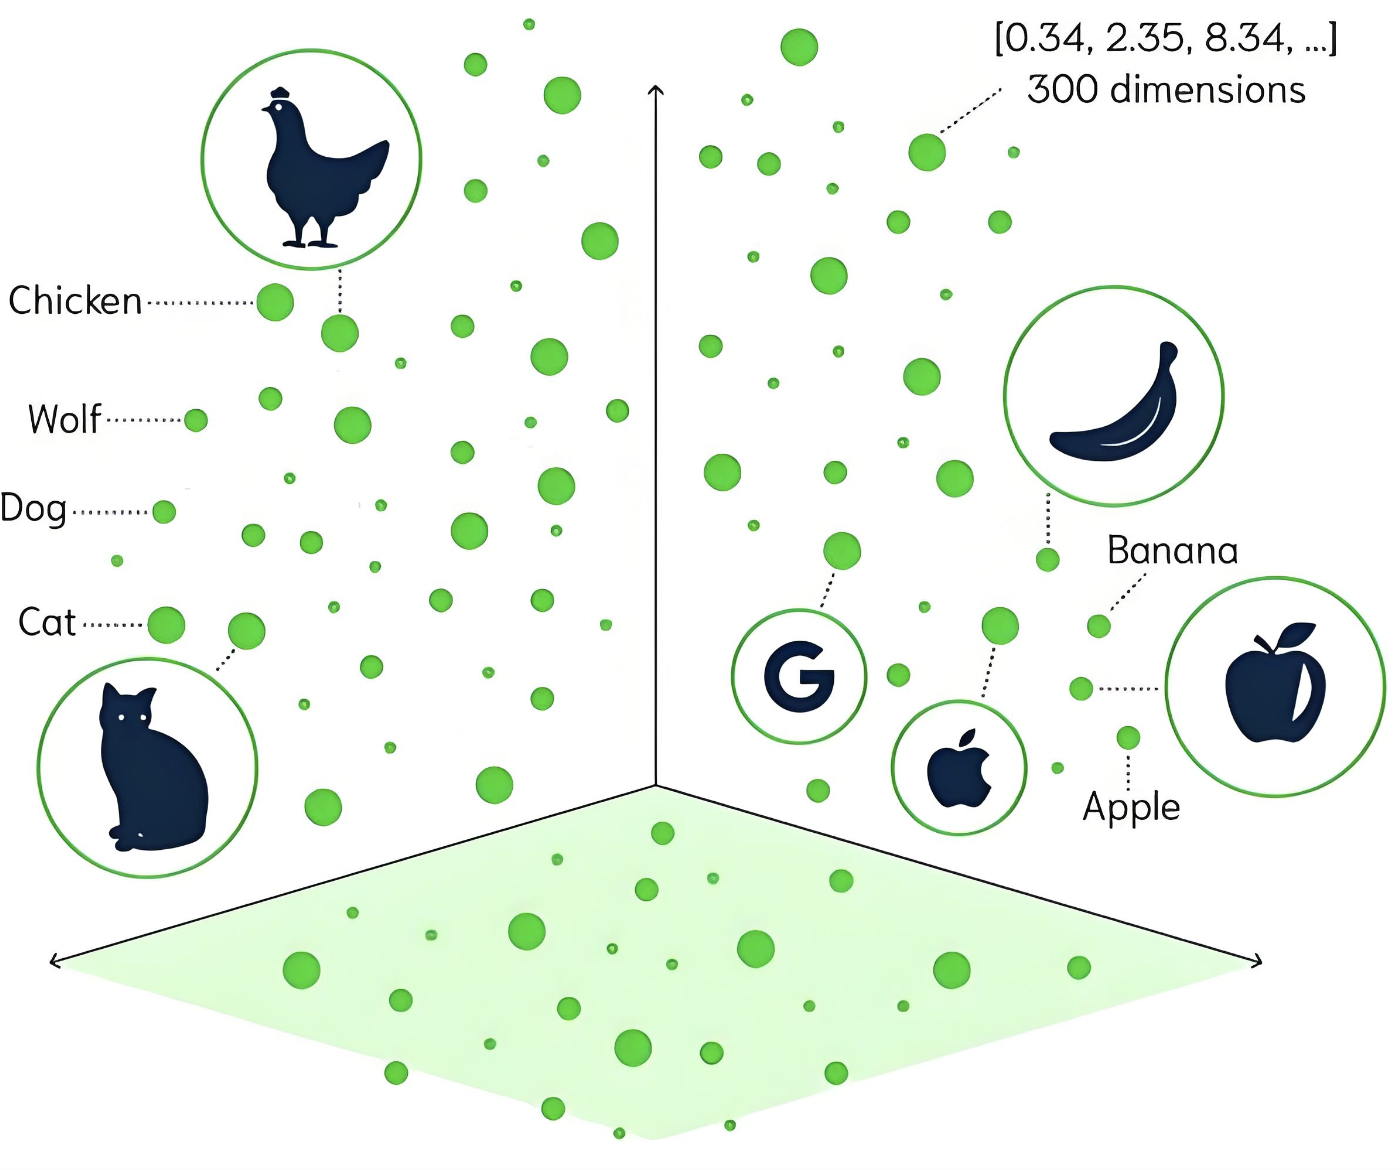
语义编码空间
把离散的 token ID 转换成连续的向量:
词表里有 50000 个词,每个词有一个 d_model 维的向量。
W_emb 是一张大表,形状 [50000 × d_model]。

输入 "The king sat",token ID = [1023, 4821, 7392]

查表:
  x[0] = W_emb[1023]    ← "The" 对应的向量
  x[1] = W_emb[4821]    ← "king" 对应的向量
  x[2] = W_emb[7392]    ← "sat" 对应的向量
图 3 Embedding简易示意图
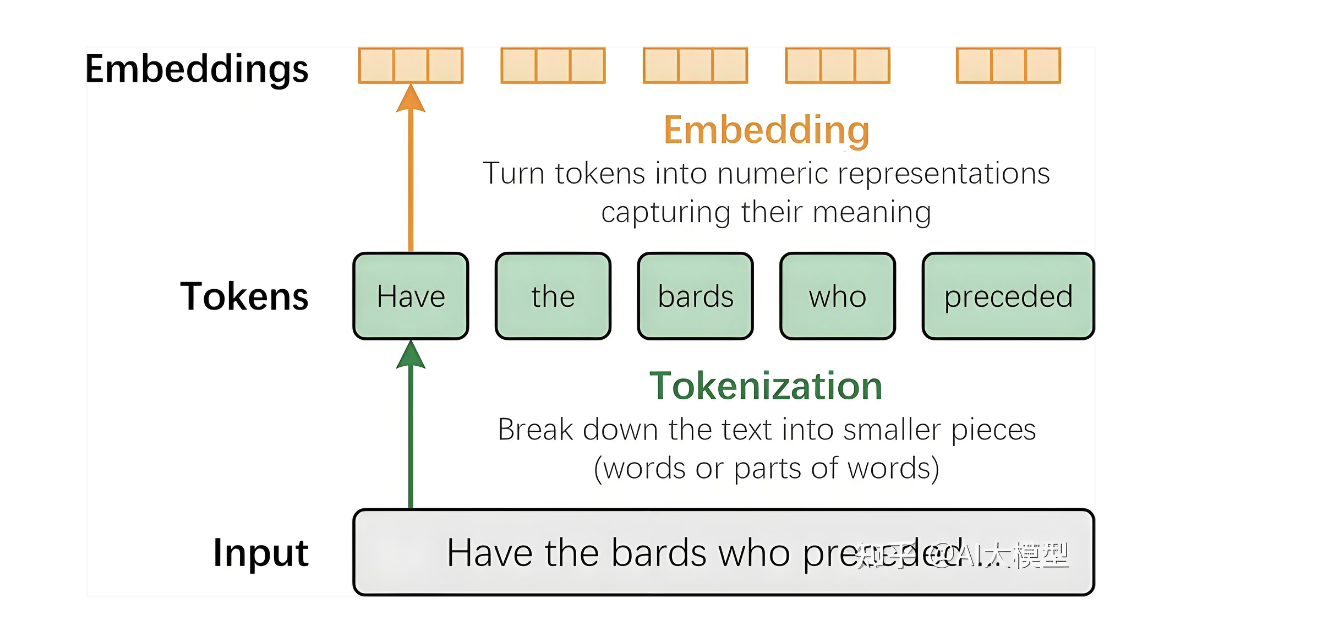
Embedding 本质上是一个线性层(用 one-hot 向量做输入的矩阵乘法),但实现上是查表。
Embedding 的反向传播
经过所有 Block 的传播,最终到达 Embedding 层的误差是 ,形状 。
反向传播就是把误差写回 对应的行:
用 是因为同一个词可能在句子里出现多次,每次出现的梯度要累加:
"The king sat on the throne"

"the" 出现在位置 0 和位置 4,token ID = 1023:

∂L/∂W_emb[1023] = Δ_x[0] + Δ_x[4]
                   ↑          ↑
                第一次出现   第二次出现
为什么 Embedding 也需要更新?
你可能会想:词向量不是已经预训练好了吗?
是的当然,但在训练过程中,Embedding 也在持续调整:
初始状态:
  "king" 的向量,和 "queen" 的向量,可能只有一点点相关

训练过程中:
  每次模型在涉及皇室的上下文里犯错,误差都会传回到
  "king" 和 "queen" 的向量上,让它们的表示越来越准确

训练完成后:
  词向量里编码了丰富的语义关系
  "king" - "man" + "woman" ≈ "queen"
  这不是硬编码进去的,是反向传播训练出来的
小结
“ 至此,我们走完了 Transformer 反向传播的万里长征。朋友,为自己鼓个掌吧👏: ”
Loss
  │
  ▼ Softmax + 交叉熵(联合公式)
Δ_logits = y_pred - y_gt
  │
  ▼ 输出投影层(线性层)
∂L/∂W_lm → 优化器
  │
  ▼ Transformer Block × N(每层结构相同)
  │
  │  ┌─── 残差直路 ──────────────────────────────────┐
  │  │                                               │
  │  ▼                                               │
  │  RMSNorm 反向传播                                │
  │  │   ∂L/∂γ → 优化器                             │
  │  ▼                                               │
  │  Self-Attention 反向传播                          │
  │  │   P·V → Softmax → Q·K^T → Q/K/V 投影         │
  │  │   ∂L/∂W_Q, ∂L/∂W_K, ∂L/∂W_V → 优化器        │
  │  ▼                                               │
  │  残差汇合 ←─────────────────────────────────────┘
  │
  │  ┌─── 残差直路 ──────────────────────────────────┐
  │  │                                               │
  │  ▼                                               │
  │  RMSNorm 反向传播                                │
  │  │   ∂L/∂γ → 优化器                             │
  │  ▼                                               │
  │  FFN(SwiGLU)反向传播                           │
  │  │   ∂L/∂W_gate, ∂L/∂W_up, ∂L/∂W_down → 优化器 │
  │  ▼                                               │
  │  残差汇合 ←─────────────────────────────────────┘
  │
  ▼ Embedding 层
∂L/∂W_emb[token_id] += Δ_x   (累加,同词共享梯度)
  │
  ▼ 反向传播结束
优化器拿到所有梯度,统一更新所有参数
  │
▼ 下一次前向传播,模型变得更聪明了一点每一层的结构不同,但反向传播的核心逻辑只有一个:
链式法则:把复杂的计算图,拆成一个个简单的小步骤
每一步做两件事:
  1. 计算当前层参数的梯度(交给优化器)
2. 计算传给上一层的误差(继续往前传)- 线性层用 和 。
- Softmax 和 RMSNorm 需要修正归一化带来的耦合。
- Attention 的特殊性在于 token 之间的网状耦合。
- Embedding 是终点,只需要把误差写回查表的那一行。
这就是 Transformer 反向传播的全貌。
笔者的话
“ 至此,我们走完了Transformer反向传播主干的所有内容🎉。 笔者一直试图以尽量详细兼具逻辑和可读性的语言去描述推导整个过程,不管是否有观众,这对我个人的学习也是一个很好的总结。也感谢一直看到这里的观众,有任何的建议或者疑问请联系我的邮箱📮,万分欢迎。接下来你是否注意到了还要一些细节的问题没有具体展开讲,比如残差传播与Norm归一化的关系,组件的选择,以及一些初始化数值的选取和放缩处理,不要担心,笔者会继续讲下去,只要肯等待~ ”
参考资料
- Laurent Bou´,Deep learning for pedestrians: backpropagation in Transformers
- Stanford lecture,cs336(2025-2026)