Transformer|反向传播(Backpropagation)(3):以 SwiGLU 为例的前馈网络层推导
阅读提醒:我们推导了线性层的两个核心公式,以及 Softmax 和 RMSNorm 的反向传播。现在我们带着这些工具,正式进入 Transformer Block 的内部。于是我们来到了:前馈网络(Feed-Forward Network,FFN)。这里的计算比较稀松平常,所以就多嘴整理了一下FFN的发展流程,作为一些完整的补充,如果前2篇你很顺利地理解下来了,那么恭喜你,这一篇你可以以喝杯下午茶的心情来愉悦地看了。祝食用愉快~☕️
图 1 一张非常简洁的前馈网络示意图
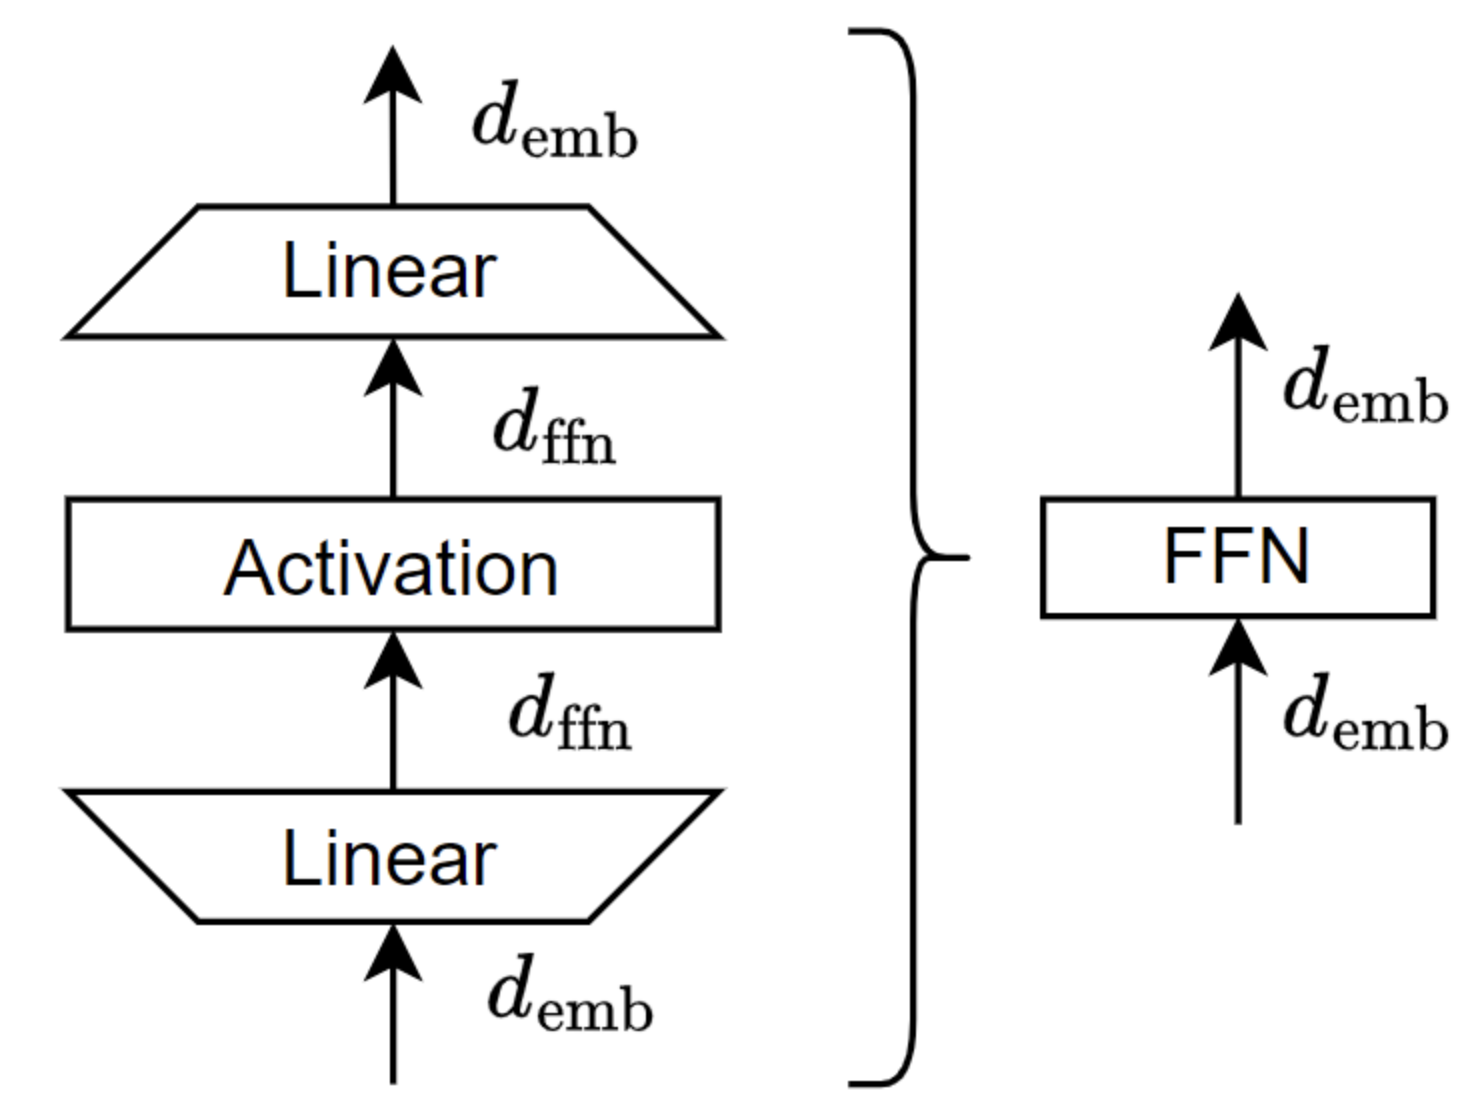
导言:FFN 的发展:从 ReLU 到 SwiGLU
“ FFN 的基本框架一直没变(展开 → 激活 → 压缩),但中间的“激活函数”和“结构”经历了几代演化。 ”
第一代:ReLU FFN(原始 Transformer,2017)
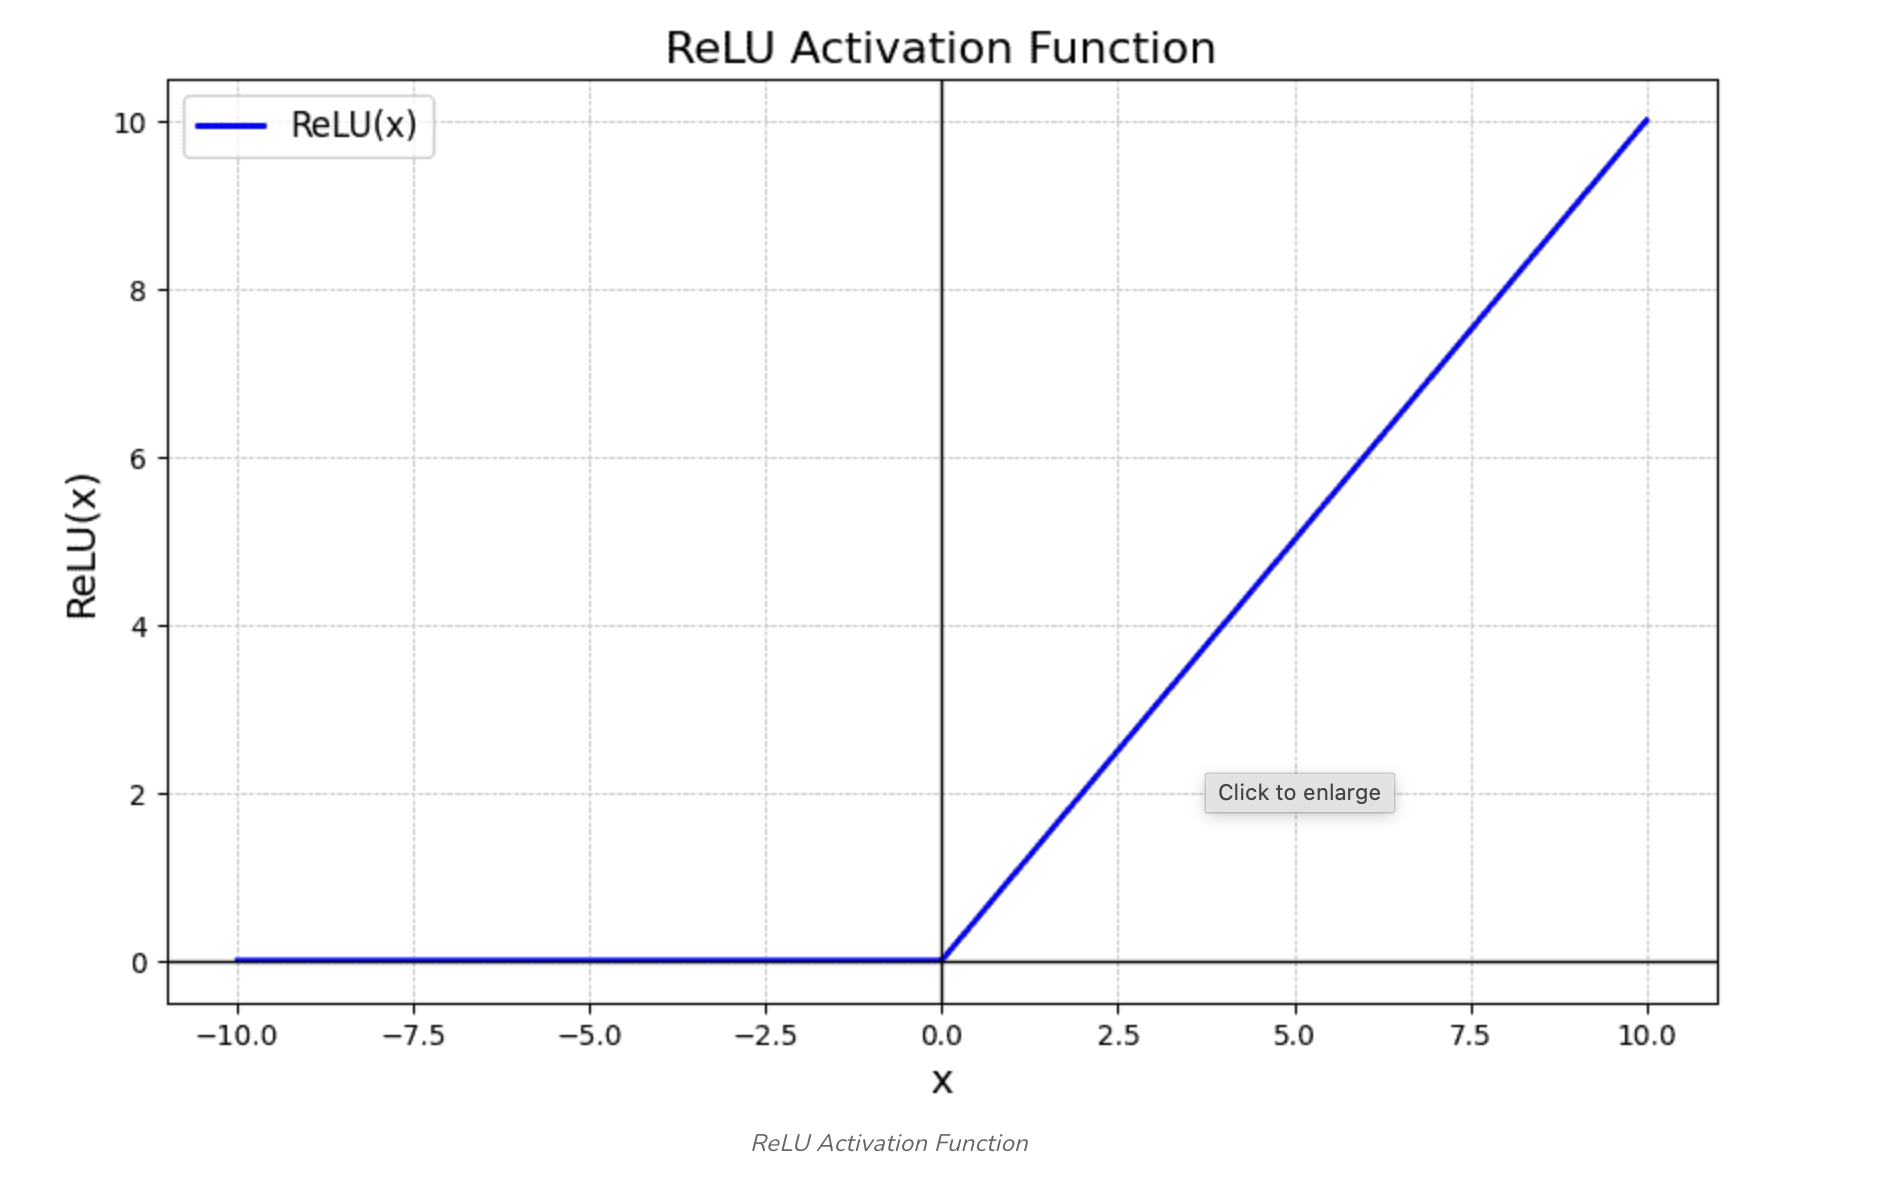
ReLU函数
FFN(x) = ReLU(x · W₁) · W₂结构最简单:一个线性层展开,ReLU 激活,再一个线性层压缩。
x ──→ W₁(展开)──→ ReLU ──→ W₂(压缩)──→ output
     [d → 4d]               [4d → d]
ReLU 的特点:
ReLU(z) = max(0, z)

z > 0:原样输出
z ≤ 0:直接变成 0("关门")
优点:简单快速。 缺点:太粗暴了——负值直接归零,一旦某个神经元被“关门”,梯度就完全无法通过,可能永远学不回来(“死亡 ReLU”问题)。
第二代:GELU FFN(BERT / GPT-2,2018-2019)
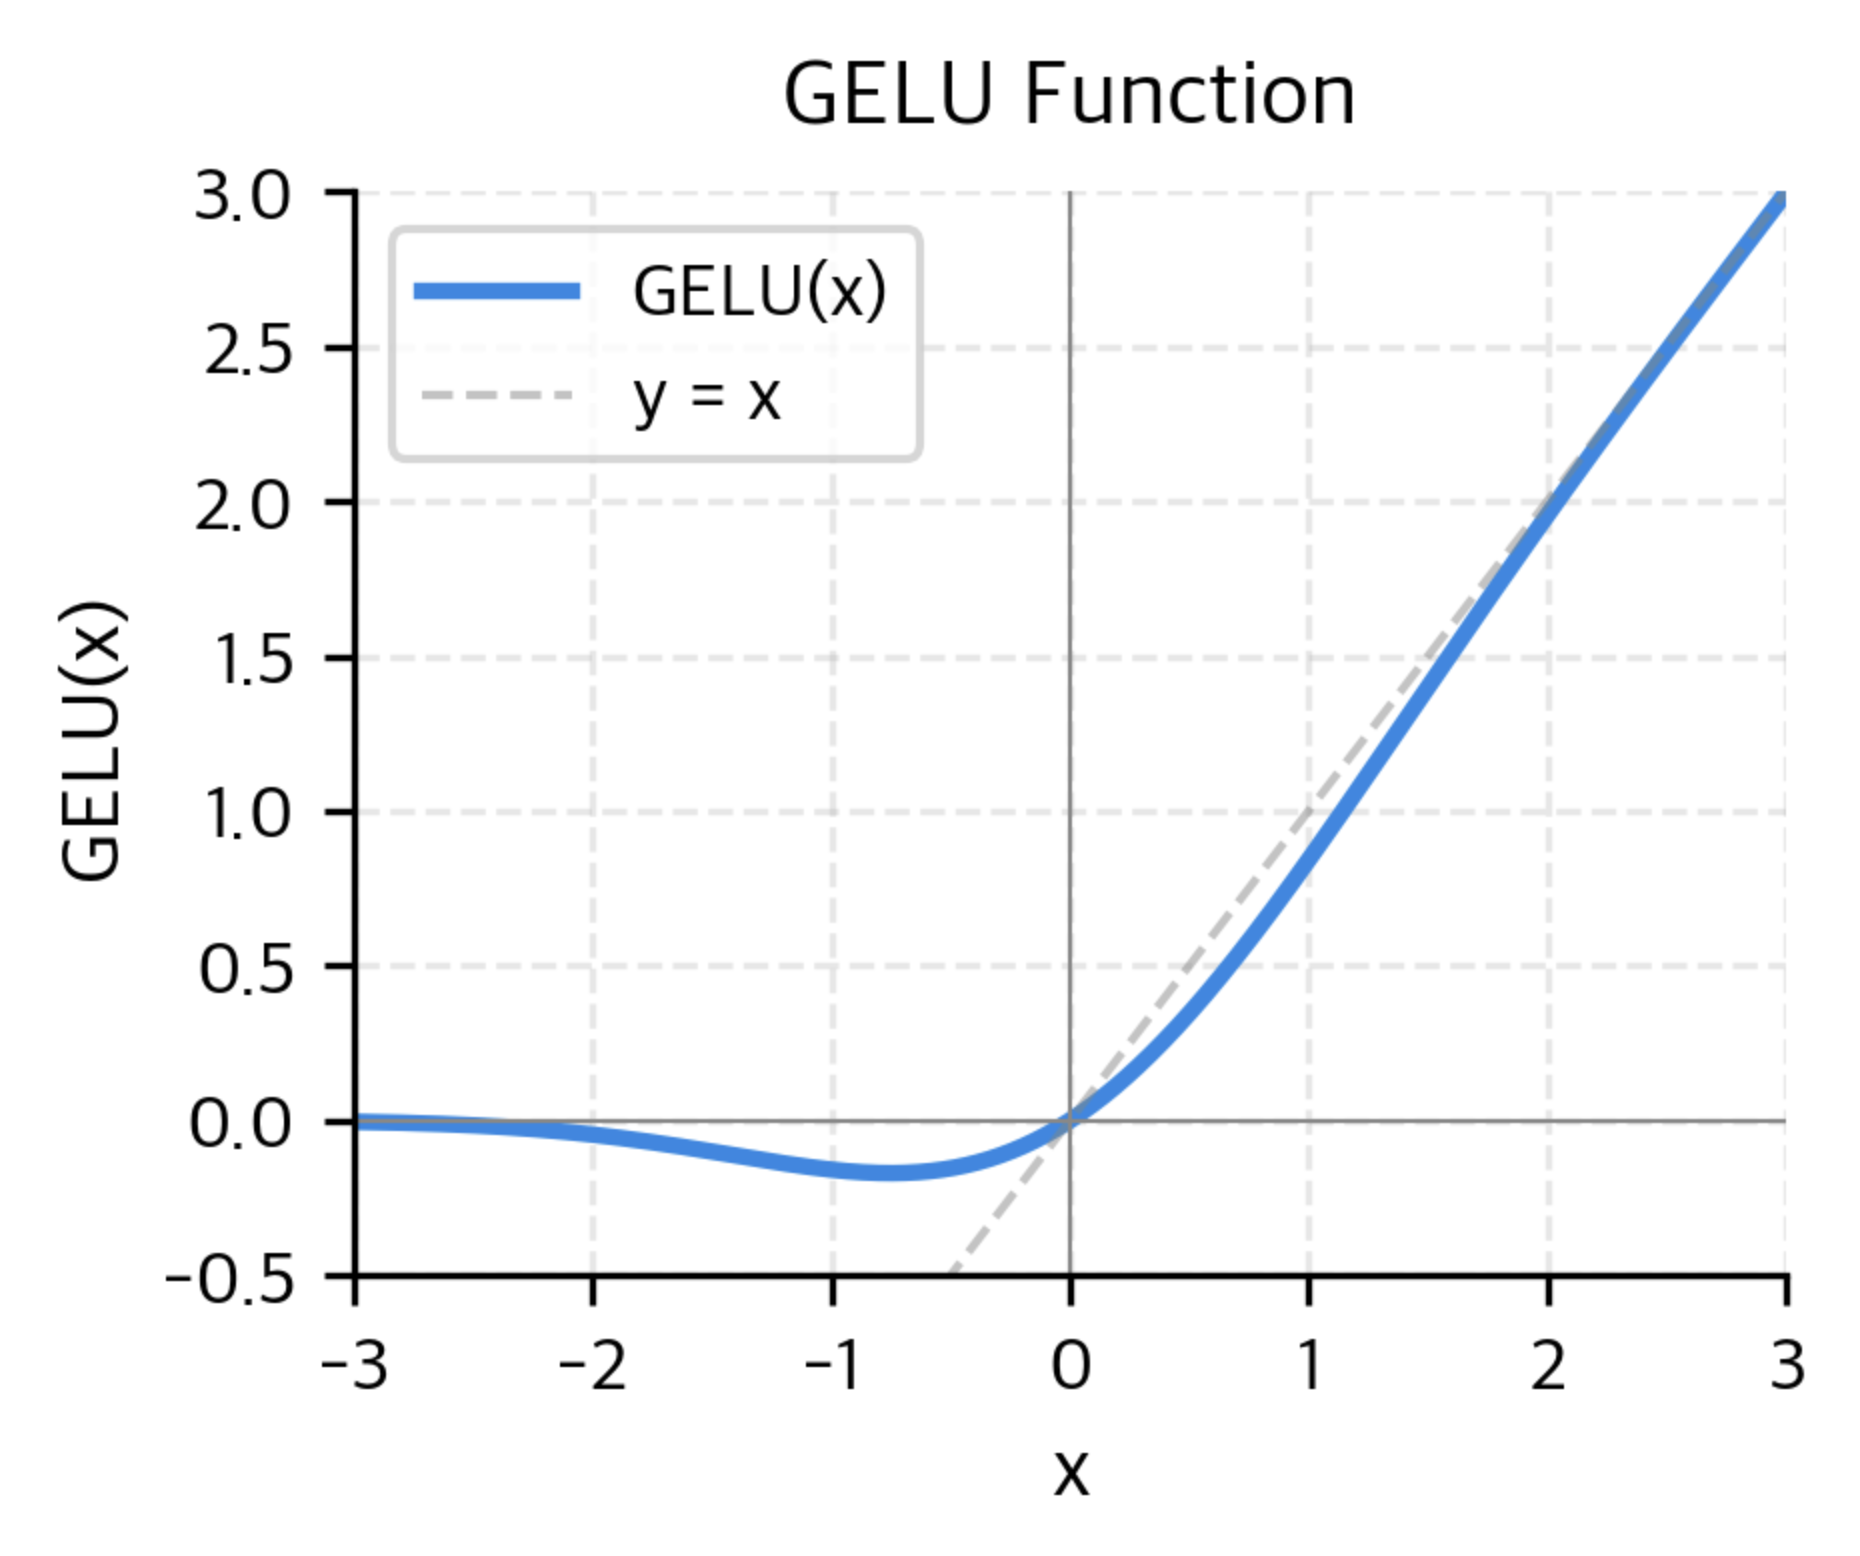
GELU FFN函数
FFN(x) = GELU(x · W₁) · W₂结构不变,只是把 ReLU 换成了 GELU:
GELU(z) = z · Φ(z)

其中 Φ(z) 是标准正态分布的累积分布函数
ReLU:z > 0 → 全开,z ≤ 0 → 全关(硬开关)
GELU:z 很大 → 几乎全开
z ≈ 0 → 半开半关(平滑过渡)
z 很小 → 几乎全关(但不是完全为 0)优点:平滑的门控,梯度不会突然断掉。 缺点:结构还是单路的,表达能力有限。
第三代:门控 FFN — SwiGLU(LLaMA / PaLM,2022-2023)
FFN(x) = (SiLU(x · W_gate) ⊙ (x · W_up)) · W_down这是一个根本性的结构变化——从单路变成了双路。
第一代/第二代(单路):

x ──→ W₁ ──→ 激活函数 ──→ W₂ ──→ output
      一条路走到底


第三代 SwiGLU(双路):

x ──→ W_gate ──→ SiLU ──→ ┐
                            ⊙ ──→ W_down ──→ output
x ──→ W_up ──────────────→ ┘
      两条路,在 ⊙ 处交汇
“ 为什么要搞两条路呢? ”
W_gate 路线(门控路线):
  → 决定"哪些特征要保留,哪些要丢弃"
  → SiLU 激活函数产生 0~1 之间的"门控信号"
  → 相当于一个"筛子"

W_up 路线(内容路线):
  → 提取实际的特征内容
  → 不经过激活函数,保留完整的信息
  → 相当于"原材料"

⊙ 逐元素相乘:
  → 用筛子去筛选原材料
  → 门控信号大的维度被保留,小的被抑制
“ 打个比方来看:ReLU FFN 像是一个人同时负责“判断”和“执行”。SwiGLU 像是两个人分工——一个人负责判断(gate),另一个人负责准备材料(up),最后配合完成任务。分工产生效率。 ”
为什么我们选择 SwiGLU?
ReLU FFN:
  一个矩阵既要学"提取什么特征",又要学"保留还是丢弃"
  激活函数是硬门控(非0即1),信息损失大

SwiGLU:
  W_gate 专门学"保留还是丢弃"(门控决策)
  W_up 专门学"提取什么特征"(内容提取)
  SiLU 是软门控(连续值),信息损失小
  两者分工明确,各自可以学得更好
这也是为什么现在主流的大模型(LLaMA、PaLM、Gemma、Qwen 等)基本都用 SwiGLU。
SwiGLU 的 SiLU 激活函数
“ 没错,聪明的你肯定发现了,我们的主角就是SwiGLU,让我们走近它来仔细看看🧐 ”
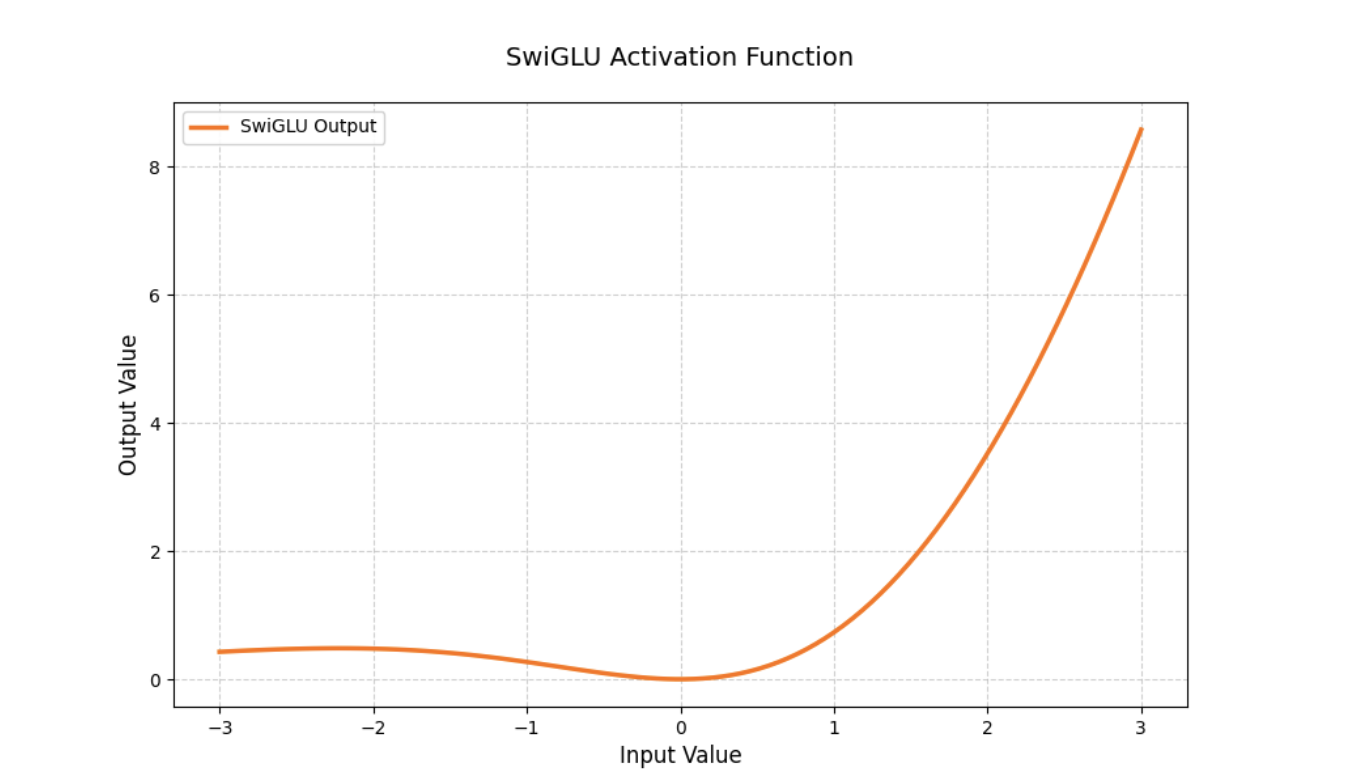
SwiGLU函数
SiLU(也叫 Swish)的定义:
其中 是 sigmoid 函数。
三种激活函数的对比:

ReLU:  ____/        硬拐角,负数直接归零
GELU:  ___/~        平滑版 ReLU,负数接近零但不完全为零
SiLU:  __/~~        类似 GELU,但公式更简洁,导数更好算
SiLU 的导数(后面反向传播要用):
看起来复杂,但其实只是 sigmoid 的组合,计算很高效。
进入 Block:先碰到残差连接
“ 在正式进入 FFN 的反向传播之前,我们需要知道 FFN 在 Transformer Block 里的位置: ”
x_in(Block 的输入)
│
├─── ... Attention 部分 ... ───→ x_mid
│
│  现在我们站在这里,x_mid 已经算出来了
│
├──────────────────────────────┐
│                              │(残差直通)
▼                              │
RMSNorm(x_mid) → x_norm       │
│                              │
▼                              │
FFN(x_norm) → x_ffn            │
│                              │
▼                              │
x_out = x_mid + x_ffn ←───────┘(残差相加)
反向传播时,误差从 开始,碰到残差相加后分成两路:
Δ_x_out
│
├── Δ_x_mid_residual = Δ_x_out    ← 直路,原样复制(后面会展开讲)
└── Δ_x_ffn = Δ_x_out              ← 进入 FFN 的反向传播
“ 残差连接的详细机制我们后面会专门展开。这里只需要知道:加法的反向传播就是把误差完整地复制一份给每条路。 ”
现在我们拿着 ,进入 FFN 的内部。
SwiGLU FFN 的前向传播
给每一步起个名字:
输入:x_norm,形状 [seq_len × d_model]

步骤1:gate = x_norm · W_gate     [seq_len × d_ffn]    ← 门控路线
步骤2:up   = x_norm · W_up       [seq_len × d_ffn]    ← 内容路线

步骤3:g    = SiLU(gate)           [seq_len × d_ffn]    ← 门控信号

步骤4:h    = g ⊙ up              [seq_len × d_ffn]    ← 逐元素相乘

步骤5:output = h · W_down [seq_len × d_model] ← 压缩回原维度每一步都对每个 token 独立计算——token 之间没有任何交互。(这里就可以看出和RMSNorm以及Softmax的不同了)
这意味着,token 1 的误差只影响 token 1,token 2 的误差只影响 token 2,互不干扰。
反向传播
“ 我们拿着 (形状 ),倒着走。 ”
第五步:
这就是我们已经推过的线性层!直接用两个核心公式:
的梯度交给优化器, 继续往前传。
第四步:
这里是逐元素乘法,不是矩阵乘法。
前向传播时,每个元素的计算是独立的:
所以对 求导:
对 求导:
用链式法则:
写成向量形式:
“ 和 在逐元素乘法里互为对方的“系数”。 的误差取决于它当时乘的那个数()有多大。 的误差取决于它当时乘的那个数()有多大。
这就是为什么前向传播时需要把 和 都存档——反向传播时,每一方都需要对方的值。 ”
这里误差兵分两路: 去追查门控路线, 去追查内容路线。
第三步:
SiLU 是逐元素函数,反向传播的规则很简单:
其中 SiLU 的导数是:
“ 和 ReLU 的对比:
ReLU 的反向传播:
  Δ_z = Δ · mask(z > 0)
  → gate > 0 的通道:误差完整通过
  → gate ≤ 0 的通道:误差被完全阻断
  → 硬开关:要么全通,要么全断

SiLU 的反向传播:
  Δ_z = Δ · SiLU'(gate)
  → SiLU' 是连续函数,永远不会完全为 0
  → 所有通道都能传递一些梯度
  → 软开关:有些通道多传一点,有些少传一点
这就是为什么 SiLU 比 ReLU 训练更稳定——不会出现“死亡神经元”问题。 ”
第二步和第一步:两个线性层
现在我们有两路误差分别回到了两个线性层:
门控路线:
内容路线:
两路误差在 处汇合
同时“兼职”了两个角色(门控和内容),两条路的误差都要算到它头上:
完整流程图
Δ_output [seq_len × d_model]
│
▼  output = h · W_down                    ← 线性层公式
├── ∂L/∂W_down = h^T · Δ_output           → 优化器
Δ_h = Δ_output · W_down^T
│
▼  h = g ⊙ up                             ← 逐元素乘法
Δ_g  = Δ_h ⊙ up        (up 是 g 的系数)
Δ_up = Δ_h ⊙ g         (g 是 up 的系数)
│              │
│              ▼  up = x_norm · W_up       ← 线性层公式
│              ├── ∂L/∂W_up = x_norm^T · Δ_up    → 优化器
│              Δ_x_via_up = Δ_up · W_up^T
│
▼  g = SiLU(gate)                          ← 逐元素函数
Δ_gate = Δ_g ⊙ SiLU'(gate)
│
▼  gate = x_norm · W_gate                 ← 线性层公式
├── ∂L/∂W_gate = x_norm^T · Δ_gate        → 优化器
Δ_x_via_gate = Δ_gate · W_gate^T
│
▼  两路汇合
Δ_x_norm = Δ_x_via_gate + Δ_x_via_up
│
▼  继续往前,经过 RMSNorm 反向传播
│  (上一篇也已经推过了)
│
▼  然后和残差直路汇合
Δ_x_mid = Δ_x_mid_residual + Δ_x_mid_via_ffn
│
▼  传给 Attention 部分
小结
FFN 反向传播的关键特性
1. Token 之间完全独立
FFN 的前向传播:

token 0:  x[0] ─→ gate[0], up[0] ─→ g[0] ⊙ up[0] ─→ output[0]
token 1:  x[1] ─→ gate[1], up[1] ─→ g[1] ⊙ up[1] ─→ output[1]
token 2:  x[2] ─→ gate[2], up[2] ─→ g[2] ⊙ up[2] ─→ output[2]
反向传播时也一样:
Δ_output[0] 的误差 ─→ 只影响 x[0] 的梯度
Δ_output[1] 的误差 ─→ 只影响 x[1] 的梯度
Δ_output[2] 的误差 ─→ 只影响 x[2] 的梯度但注意:、、 是所有 token 共享的同一套参数。所以这些参数的梯度是所有 token 各自贡献的梯度累加在一起的结果:
2. 需要存档哪些数据
前向传播时需要存档(反向传播时会用到):

x_norm    → 用于计算 W_gate 和 W_up 的梯度
gate      → 用于计算 SiLU 的导数
g         → 用于计算 Δ_up = Δ_h ⊙ g
up        → 用于计算 Δ_g = Δ_h ⊙ up
h         → 用于计算 W_down 的梯度
这也是为什么训练比推理占用更多显存——所有这些中间值都得留着。
笔者的话
“ FFN 的反向传播之所以相对简单,是因为 token 之间完全独立——每个 token 的误差老老实实地沿着自己的路往回走,不会跑到别人的地盘上去。 ”
但 Self-Attention 就不一样了。在 Attention 里,有两个地方会让 token 之间产生交互:
Q · K^T:每个 token 的 Query 和所有 token 的 Key 做点积
         → 一个 token 的误差会扩散到所有其他 token

P · V:  每个 token 的输出是所有 token 的 Value 的加权和
         → 一个 token 的 Value 被所有其他 token 引用
这意味着反向传播时,误差不再是“直线传播”,而是“网状扩散”——每个 token 的误差都会影响所有其他 token 的梯度。这让 Attention 的反向传播比 FFN 复杂得多,也有趣得多。但不要着急,笔者会同样带着你们学习这些拆解的~😊
参考资料
- Laurent Bou´,Deep learning for pedestrians: backpropagation in Transformers
- Stanford lecture,cs336(2025-2026)