Skill|基于 PaSaMaster 的文献检索 Skill 设计与优化
阅读提醒:本篇基于个人理解以及想法来展开,原始制作的skill不会公开,如有兴趣,请邮箱📮联系笔者,欢迎任何建议。祝食用愉快~😳
导言
“ 近年来,文献调研正在从“搜索框 + 关键词”的模式,转向由 LLM 参与的自动化检索、阅读、筛选和解释流程。这个变化背后的核心矛盾很明确:传统检索系统可靠,但很难理解复杂研究意图;通用 LLM 能理解复杂问题,但容易生成不存在或不准确的引用。如何在“复杂意图理解”和“可验证文献来源”之间取得平衡,成为最近文献调研自动化系统开发中的一个关键方向。 ”
图 1 文献检索架构一览
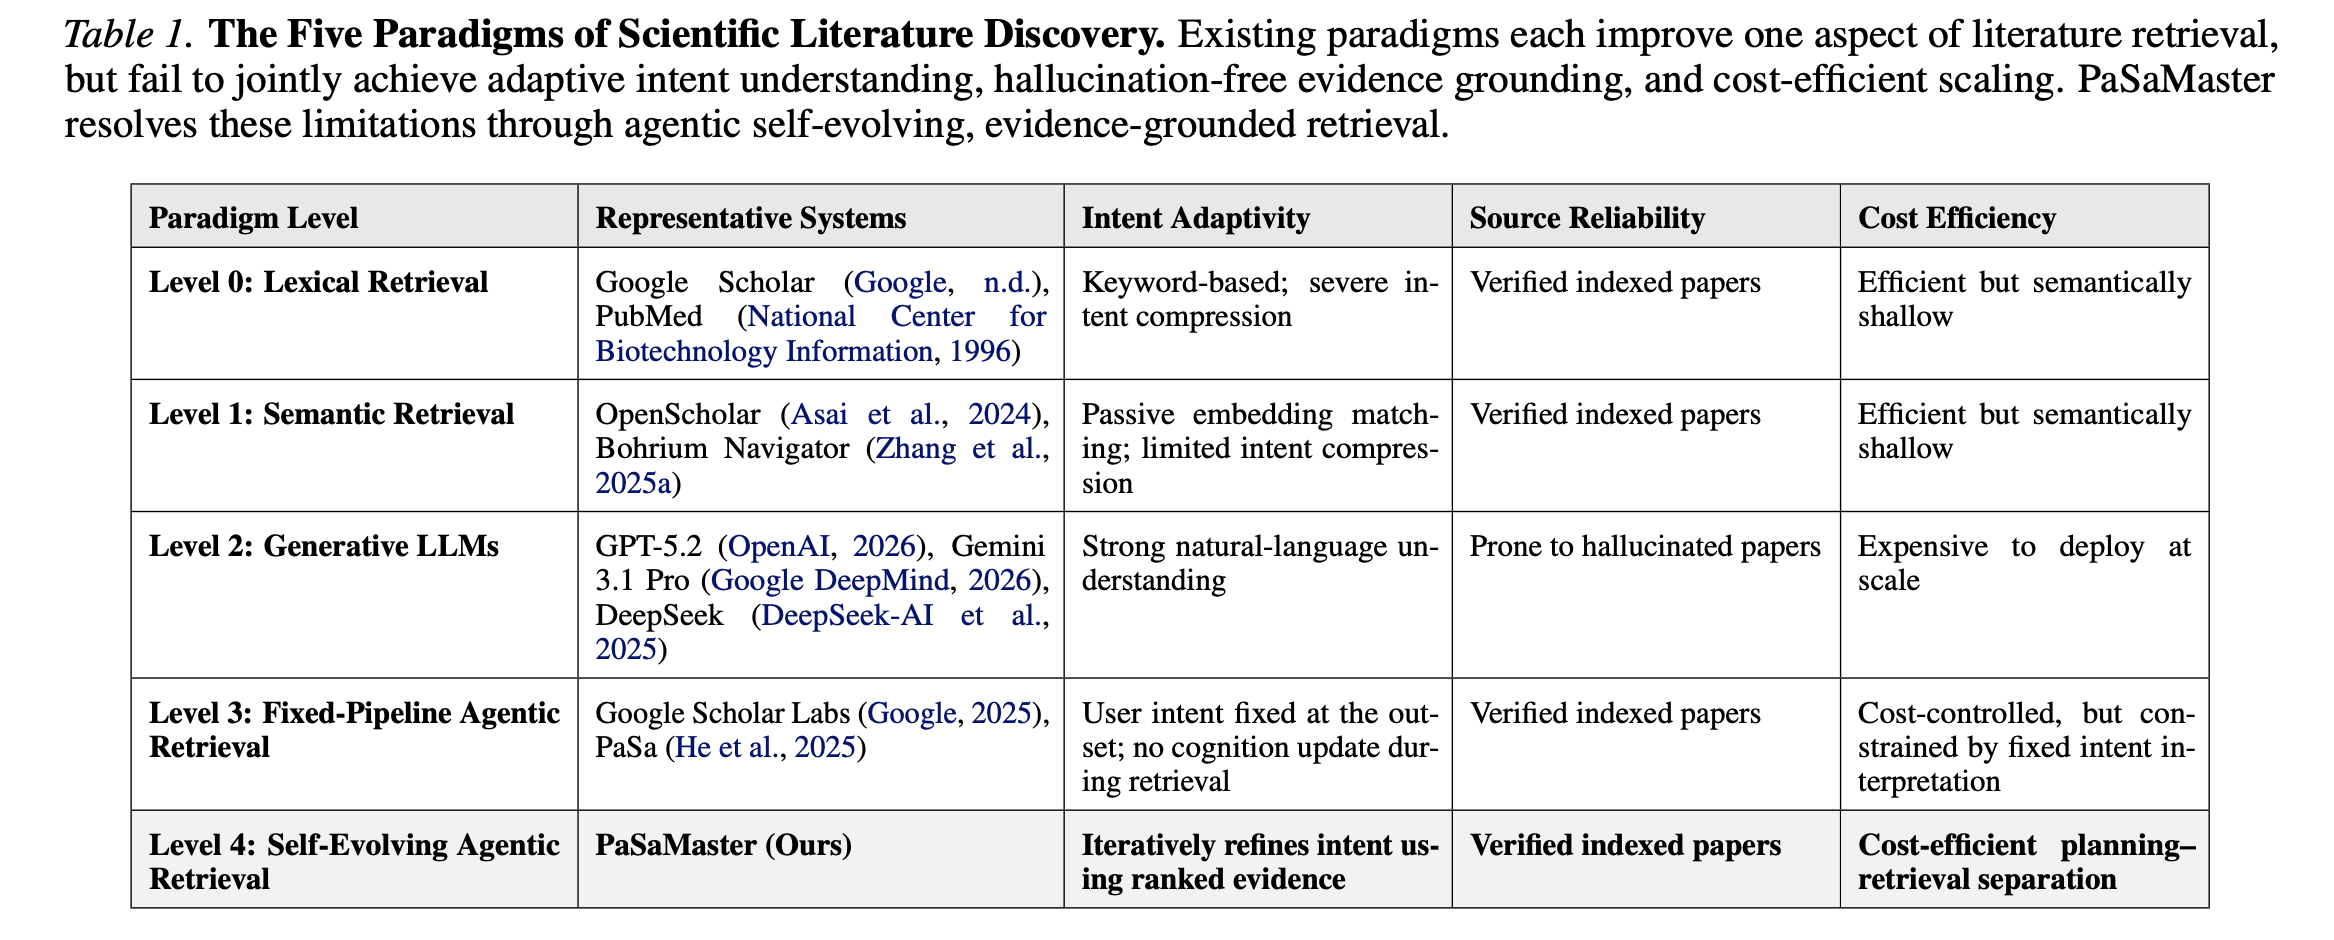
交大论文Towards Self-Evolving Agentic Literature Retrieval 正是在这个背景下提出了 PaSaMaster。它试图把文献检索从一次性的 query-document matching,改造成一个会根据检索证据不断修正意图、重新检索和排序的 agentic retrieval 系统。
本文并不把 PaSaMaster 当成可以直接复制的系统,而是把它作为一个思想来源:吸收其中对检索范式、意图分解、证据约束排序和评估协议的设计,再改造成一个适合 Web 文献检索场景的 Codex/Claude-style skill,我将其命名为iterative-research-lit。
交大原始论文 PaSaMaster
论文试图解决什么问题
Towards Self-Evolving Agentic Literature Retrieval 的核心问题是:科学文献检索不能只看关键词匹配,也不能直接让 LLM “生成论文列表”。真实研究需求往往包含主题、方法、时间、领域、排除条件和隐含背景知识,普通关键词搜索会压缩这些意图;而纯生成式 LLM 即使能理解复杂需求,也容易产生不存在的文献、错误作者、错误年份或错误链接。
PaSaMaster 因此提出一个中间路线:让 LLM 主要负责理解和规划,让检索、验证和排序落在可验证语料与轻量模型上。论文将文献检索范式划分为五层:
这一范式分析是这篇论文最值得借鉴的部分。它指出了文献检索系统的关键不只是“能搜到多少”,而是能否在复杂意图下保持可靠的来源和稳定的排序逻辑。
PaSaMaster 的核心架构
“ PaSaMaster 的整体架构可以概括为三块:Navigator、Librarian Swarm 和 Evidence-Ranked Results。 ”
图 2 架构示意图
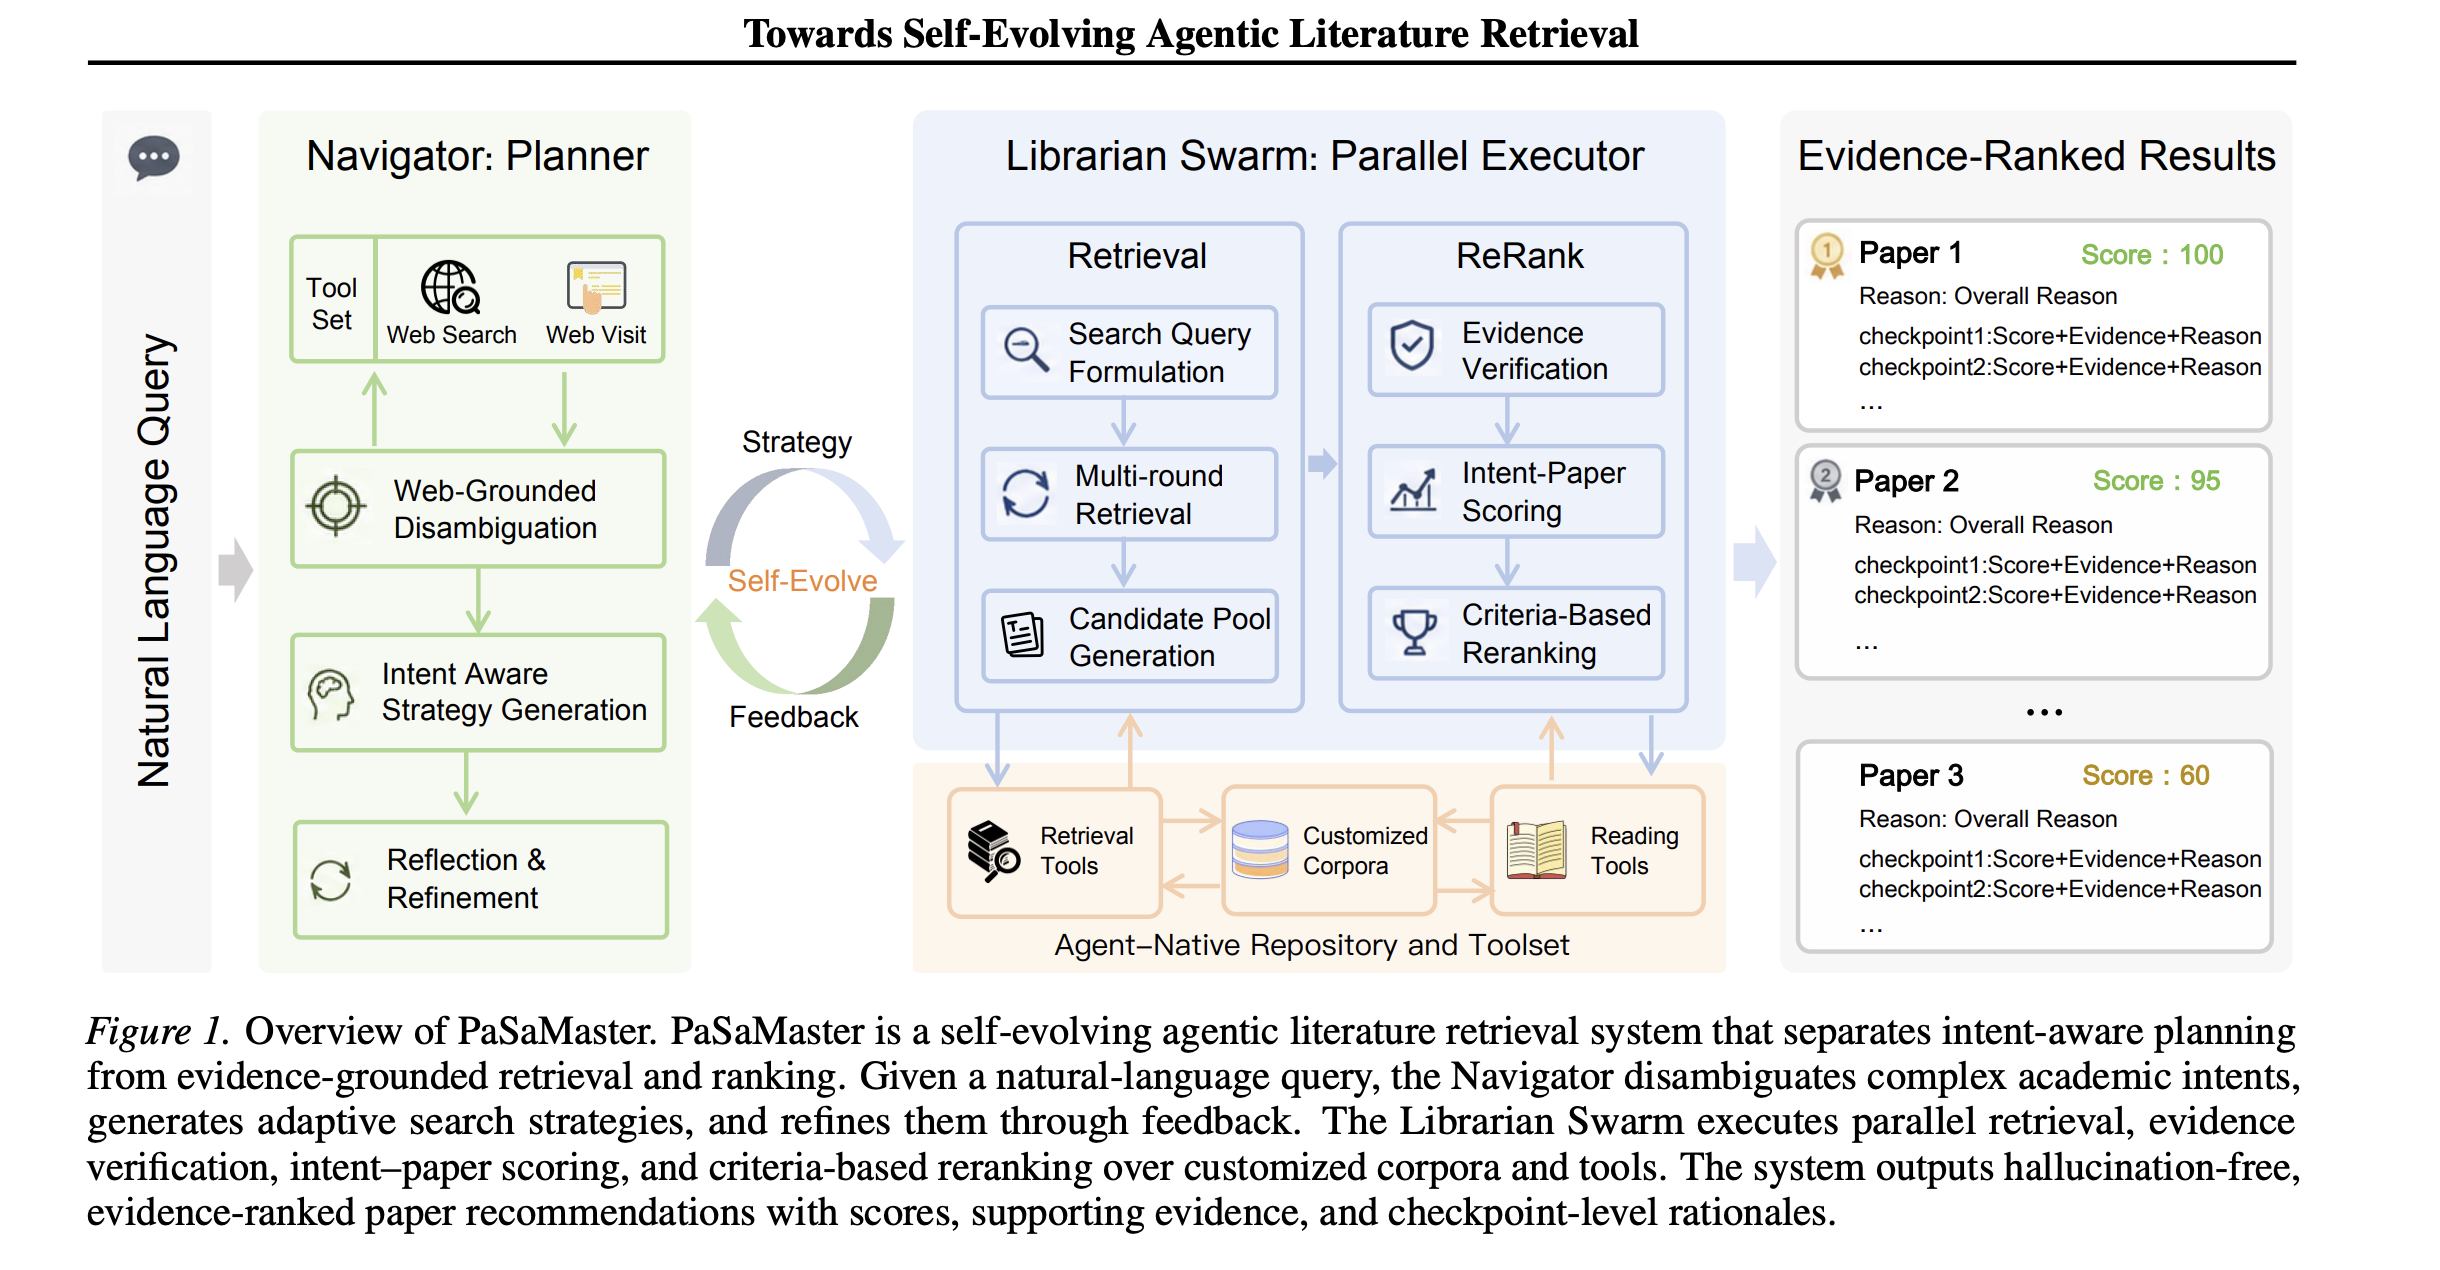
Navigator 是规划者,负责从自然语言问题中解析检索意图、生成搜索策略和验证清单,并在后续轮次里根据已排序结果发现缺口。Librarian Swarm 是并行执行者,负责检索候选论文、定位证据、检查 checklist 满足度、计算 intent-paper relevance score。最终系统输出的是带分数、证据和 checkpoint 级理由的论文排序。
论文把这个流程写成了较形式化的结构:
PLAN(q):从用户查询生成检索策略S和验证清单C。RETRIEVE(S; D, T):在自定义语料D和工具T上生成候选池。VERIFY(Pinit, C):对候选论文逐条验证是否满足 checklist。RERANK(Pscored):基于单篇得分和全局排序得到最终清单。REFLECT(q, S, C, Pscored):根据已检索证据更新下一轮策略。
它的三项核心设计是:
Self-evolving retrieval:检索不是一次性完成,而是根据已排序证据发现缺失术语、覆盖空洞和未探索方向。Hallucination-free ranking:系统不让 LLM 从记忆中生成引用,而是在已验证语料中做 intent-paper ranking。Planning-retrieval separation:强 LLM 用于高层规划和意图理解,大规模检索与评分交给定制语料库和轻量 Scorer。
评估方式
图 3 评估Bench设计
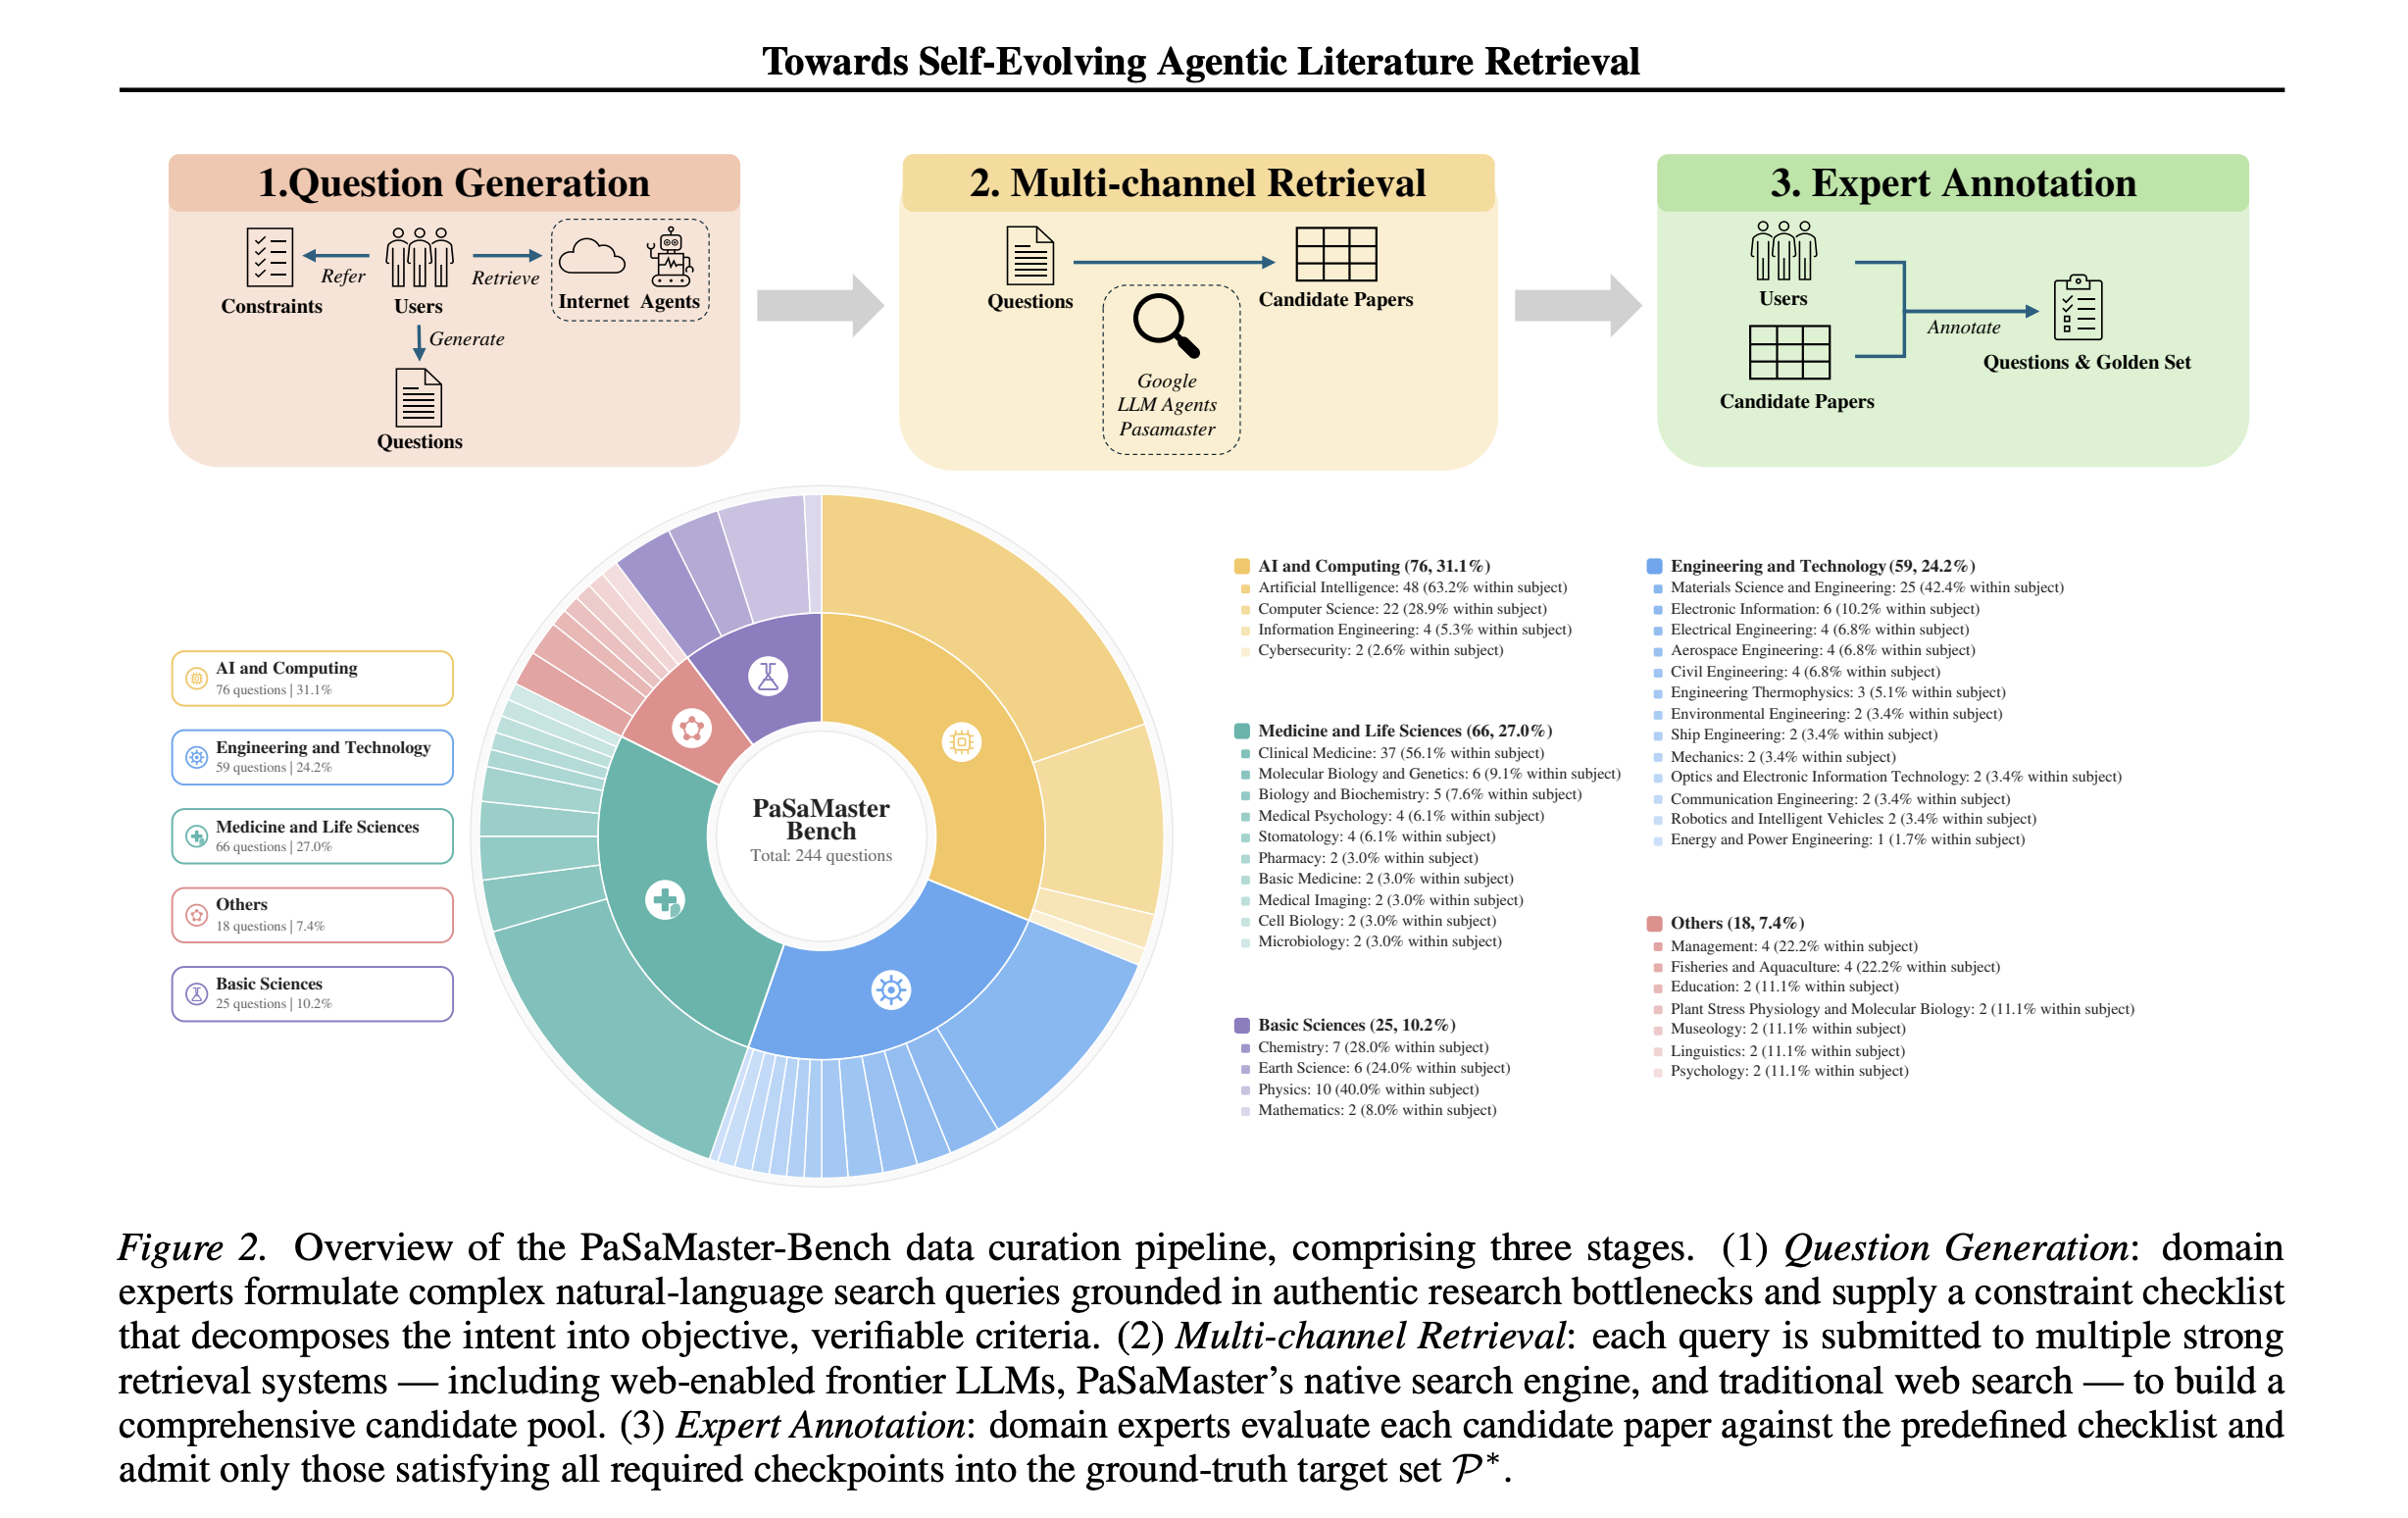
PaSaMaster-Bench 是论文提出的多学科 benchmark。论文称其包含 244 个复杂自然语言检索任务,覆盖 38 个科学学科。每个任务由领域专家给出自然语言查询、约束 checklist、候选论文池和 ground-truth target set。系统返回 top-K 论文后,用 Recall@20、Precision@20、F1@20、NDCG@20、hallucination rate 和 token cost 评估。
从论文报告的结果看,PaSaMaster 在 F1、NDCG 和 hallucination 控制上优于 Google Scholar、OpenScholar、Bohrium Navigator、多个通用 LLM 和 Google Scholar Labs。论文还强调 PaSaMaster 对比 GPT-5.2 有更低成本,并保持 0% source hallucination。
笔者对原论文的保留意见
“ 这篇论文有清晰的思想价值,但我不认为它可以被直接当成一个完整可复现的工程方案。 ”
- 它的核心优势高度依赖自建语料库和系统内 verified corpus。论文中 PaSaMaster 把 1.6 亿级论文重构为 metadata、abstract、chunk 三层 repository,并在这个封闭或半封闭语料上做检索、证据定位和 scoring。这对系统内实验有意义,但和真实 Web 文献搜索的开放环境差别很大。Web 搜索面对的是页面碎片、数据库跳转、预印本、出版社页面、重复条目和不完整 metadata,不能简单套用“语料内零幻觉”的假设。
- 它的 benchmark 天然偏好自己的方法。PaSaMaster-Bench 使用复杂自然语言任务、专家 checklist 和 target paper set,这种评估确实更贴近复杂科研检索,但也天然有利于“意图分解 + checklist scoring + 多轮检索”的系统。也就是说,它证明了这种范式在这种 benchmark 里有效,但不能直接推出它在所有真实文献检索场景中都优于其他系统。
- 论文强调代码链接,但截至今天,我检查到的 GitHub 仓库
sjtu-sai-agents/PaSaMaster是 public,主要包含README.md和assets/,没有看到足以复现实验或系统的完整源码。更准确地说,问题不是“完全没有仓库”,而是“开源完整性不足”。这会影响外部研究者复现实验结果、检查数据构造、验证 benchmark 公平性和复用系统组件。 - 论文对实际可用性的讨论不够充分。多数真实研究者使用的是 Google Scholar、Semantic Scholar、PubMed、arXiv、OpenAlex 或通用 Web 搜索,而不是一个可控的大型内部 corpus。PaSaMaster 的系统设计对平台方有启发,但对个人研究者或轻量 agent skill 来说,需要被压缩、改造和重新约束。
因此,我最终借鉴的不是 PaSaMaster 的完整系统,而是其中的范式思想:复杂意图要先结构化,候选论文要先验证,相关性判断要拆成多维 checklist,检索迭代要由证据触发,最终排序要服务于阅读清单而不是单篇相似度。
iterative-research-lit Skill
Skill 原则
按照 skills的的原则,skill 不是普通文档,也不是把一堆命令写给模型看。skill 的价值在于:当模型在某类任务中会反复出错,且这种错误可以通过稳定的行为约束改善时,把这种行为约束封装成可按需加载的上下文。
复杂文献检索正是这样的任务。没有 skill 时,模型容易出现几类问题:
- 把“主题相关”误当成“满足全部条件”。
- 忽略用户给出的排除条件、时间条件或文章类型条件。
- 给出看似权威但无法验证的引用。
- 将综述、背景论文、数据库资源和直接方法论文混在一个列表里。
- 对多学科任务只抓住其中一个半轴。
“ 因此,iterative-research-lit 的定位不是一个普通文献搜索器,而是一个复杂研究意图的 ranking controller。它负责把用户需求转成结构化检索约束、评分清单和最终可解释的阅读列表。 ”
Skill 的目录结构
“ 当前 skill 遵循“中心节点 + 条件 reference + 可执行脚本”的结构: ”
skills/iterative-research-lit/
├── SKILL.md
├── agents/
│   └── openai.yaml
├── references/
│   ├── query_patterns.md
│   ├── verification_policy.md
│   ├── failure_learning.md
│   ├── evaluation_protocol.md
│   └── phenotype_alignment_patterns.md
└── scripts/
    └── aggregate_checklist_score.py
这种结构符合 skill 编写守则里的几个关键原则:
SKILL.md只保留主流程,不堆积所有领域知识。references/只在需要时加载,避免上下文污染。scripts/承担确定性逻辑,避免每次让模型重新发明评分公式。- 单一领域知识不写死在主流程里,而是作为条件扩展存在。
原始 skill 文件中的关键内容
“ 笔者会展示下面 SKILL.md 中最关键的几段,能体现这个 skill 的路由边界和工作流思想: ”
---
name: iterative-research-lit
description: Load when the user asks for literature search with multiple constraints, exclusions, recency or authority preferences, or wants verified papers plus a clear justification for why each paper matches.
---

# Iterative Research Lit

Search literature as iterative retrieval plus verification, not one-shot citation generation. Use web results for discovery, then canonicalize and rank only against verifiable paper records.
这段 frontmatter 的重点不是“功能介绍”,而是“何时加载”。它明确把触发边界放在多约束、排除条件、时间或权威偏好、需要解释为什么入选的文献检索任务上。这样的描述比“帮助搜索论文”更符合 skill 守则,因为它降低了错误路由的概率。
再看核心流程里的意图结构化:
### 1. Build an Intent Spec

Create a short `IntentSpec` before searching:

- `objective`
- `domain`
- `must_have`
- `exclude`
- `freshness`
- `evidence_needs`
- `acceptance_rule`
这一步来自 PaSaMaster 的 intent-aware planning,但被压缩成适合 skill 的轻量结构。它的作用是把用户的自然语言需求固定成可检查条件,避免后续搜索中悄悄放宽约束。
最核心的 scoring 逻辑在这一段:
### 2. Convert the Query into a Checklist

Produce 4-8 checkpoints.

- Mark each checkpoint as `critical`, `important`, or `nice_to_have`.
- Phrase each checkpoint so it can be checked from metadata, abstract, or full text.
- Split compound constraints into separate checkpoints.
- Keep checkpoints that need deeper reading, but mark them as requiring additional evidence.
这就是我们对 PaSaMaster checklist 思想的主要复用。它把“相关性”从单一分数拆成多个可检查条件:主题是否对、方法是否对、是否满足排除条件、是否满足时间条件、是否足够权威、是否有用户需要的证据类型。这个设计也是后续 benchmark 中 iterative-research-lit 表现稳定的主要原因。
检索策略部分则保留了多通道思想:
### 3. Build Query Families

Generate 3-6 non-duplicate query families. Include at least:

- One precision-oriented family for must-have constraints
- One recall-oriented family for synonyms and alternate terminology
- One expansion-oriented family for authors, labs, datasets, benchmarks, or citations
- One exclusion-aware family when the user forbids a method, venue, or subline
这对应 PaSaMaster 的 multi-channel retrieval,但我们把它改造成 Web 场景下更实用的 query family:精准检索、召回扩展、引用/作者/数据集扩展、排除条件感知检索。它不假设有内部 corpus,而是适配 Semantic Scholar、OpenAlex、Crossref、arXiv、PubMed 和 Web 搜索等入口。
最后是迭代部分:
### 7. Reflect and Iterate

Do not iterate by default just because the skill is named `iterative`.

Run one additional round only when reflection shows missing terminology, repeated near-misses, or a clear expansion target. Stop after that round unless the user explicitly asks for exhaustive search.
这段很重要。它避免把“迭代”变成无限循环。原论文强调 self-evolving retrieval,但 skill 场景中上下文和时间成本都更敏感,所以我们把迭代条件收紧为 evidence-triggered reflection:只有当已有结果暴露出明确缺口时才加一轮。
各个组件分别负责什么
SKILL.md 是控制面,定义何时使用、如何分解意图、如何构造 checklist、如何检索候选、如何验证、如何评分、如何输出结果。
query_patterns.md 是查询模式库,负责在复杂约束、排除条件、benchmark 词汇、同义词扩展等场景中辅助生成互补 query family。
verification_policy.md 是反幻觉边界,要求 raw web snippet 不能直接当 citation,优先使用 DOI、arXiv ID、OpenAlex、Semantic Scholar 等稳定标识,未验证候选只能作为 lead。
aggregate_checklist_score.py 是确定性评分器。它把 checkpoint score、权重、信息充分性和 verification level 聚合成一个 final score,并对 critical checkpoint 失败的论文触发 hard fail。这样可以避免“期刊很强但不符合任务”的论文被错误排到前面。
failure_learning.md 负责维护迭代纪律。它要求失败后先区分是 routing、retrieval、verification、ranking 还是 presentation 的问题,再决定是否修改 core skill、reference 或 evaluation harness。
evaluation_protocol.md 定义评估方法。它要求固定搜索日期,记录 query、checklist、query families、候选数量、验证状态和最终 checkpoint scores,并把失败按 query type 分析。
phenotype_alignment_patterns.md 是一个领域 addon。它服务于专门的任务,但它不是主流程的一部分。这也是当前 skill 的真实状态:核心是通用的复杂文献检索主干,附带一个 phenotype 领域扩展。
设计初衷
“ 这个 skill 的设计初衷不是追求“所有文献都搜全”,而是解决复杂任务中最常见、也最影响体验的问题:用户真正想要的是一组能支撑研究决策的论文,而不是一堆看起来相关的 citation。 ”
所以它优先优化的是:
- 用户约束保真。
- 文献真实性与可验证性。
- 结果清单结构。
- 每篇论文为什么被选中的解释。
- 对排除条件和偏好条件的持续维护。
这也是它和普通 literature search skill 的核心差别。
简单评估流程与结果
评估流程
我们的评估不是黑盒线上系统对测,而是简单、可复核的 controlled benchmark。基本流程如下:
- 对每个用户任务建立共享候选论文池。
- 为每个任务建立统一 checklist,区分
critical、important和nice_to_have。 - 让不同 skill 风格产生各自的 top-k 排序结果。
- 对每个结果按同一 rubric 计算指标。
- 输出 raw、scored、metrics 和 report 文件,保留人工对照空间。
使用的主要指标包括:
VerifiedPrecision@K:top-K 中同时满足两个 critical checkpoint 的比例。CriticalSatisfactionMean@K:关键条件满足度均值。PreferenceAlignment@K:对权威性、近期性、任务偏好等条件的对齐程度。WeightedChecklistScore@K:加权 checklist 总分。HallucinationRate:未验证文献比例,在这些 controlled benchmark 中固定为 0。
这个评估方式确实有主观性,也对 checklist-style skill 有一定偏好。但这正符合我们的测试目的:我们要验证的不是“谁拥有最强搜索引擎”,而是“在相同候选池和相同 judging rubric 下,哪种 skill 更能维护复杂用户意图”。
术语对齐任务
第一个核心任务来自用户真实需求:用 gene-grounded 的方式做术语对齐,补充单本体中细粒度过粗的缺失信息(由于涉及课题信息,不予公开,只限模糊表述),优先高水平、新近或权威文献,不走传统纯语义匹配路线。
在 benchmark v2 中,结果如下:
| Skill | VerifiedPrecision@15 | CriticalSatisfactionMean@15 | PreferenceAlignment@15 | WeightedChecklistScore@15 |
|---|---|---|---|---|
iterative-research-lit |
1.00 | 0.89 | 0.78 | 87.39 |
aris-research-lit |
0.73 | 0.84 | 0.82 | 85.82 |
k-dense-literature-review |
0.67 | 0.82 | 0.83 | 80.11 |
research-lit |
0.67 | 0.82 | 0.80 | 80.11 |
davila7-literature-review |
0.67 | 0.82 | 0.79 | 79.87 |
aperivue-search-lit |
0.53 | 0.81 | 0.81 | 76.89 |
iterative-research-lit 排名第一,主要原因是它能把直接 相关论文放在前列,同时避免让纯资源论文、纯语义历史 baseline 或 downstream 应用论文挤占主榜。
两个跨域泛化任务
“ 第二轮泛化任务包括: ”
- 结构化知识图谱综述。
- 神经生物学启发的记忆系统调研。
总榜如下:
| Skill | MeanVerifiedPrecision@10 | MeanWeightedChecklistScore@10 |
|---|---|---|
iterative-research-lit |
0.75 | 87.18 |
k-dense-literature-review |
0.70 | 84.86 |
davila7-literature-review |
0.65 | 82.72 |
aperivue-search-lit |
0.55 | 80.44 |
aris-research-lit |
0.55 | 80.44 |
research-lit |
0.55 | 78.67 |
这轮说明它不是只靠 phenotype addon 取胜。在 KG 和 neuro-inspired memory 任务中,主要发挥作用的是通用主干:复杂意图拆解、checklist ranking 和 set-level output control。
四个多学科泛化任务
第三轮任务进一步扩展到: (笔者在这里动用了自己的人脉获得了一些小的文献课题内容~😊)
- 纳米酶在抗菌领域的应用。
- 肿瘤筛查与诊断技术。
- 普鲁兰酶切断淀粉 alpha-1,6 键并生成长直链淀粉相关文献。
- 智能化小店建设与 Z 世代谷子消费认同维度。
总榜如下:
| Skill | MeanVerifiedPrecision@10 | MeanWeightedChecklistScore@10 | MinWeightedChecklistScore@10 |
|---|---|---|---|
iterative-research-lit |
0.95 | 85.72 | 84.73 |
k-dense-literature-review |
0.93 | 85.00 | 83.64 |
aperivue-search-lit |
0.93 | 84.45 | 82.55 |
davila7-literature-review |
0.88 | 83.05 | 81.82 |
aris-research-lit |
0.80 | 81.36 | 77.90 |
research-lit |
0.80 | 80.36 | 76.99 |
这轮最有价值的是第四个任务。它把“智能小店建设”和“Z 世代谷子消费认同维度”混在一起,要求 skill 同时覆盖智能零售、社群认同、自我认同和情感价值。iterative-research-lit 在这一题上明显领先,说明它的集合级平衡能力比单纯广搜更强。
综合评估结论
综合四轮评估,iterative-research-lit 在我们选择的主评估任务中均达到 rank 1 或并列 rank 1。更准确地说:
- 术语对齐任务:单独 rank 1。
- KG + memory 两任务:总榜 rank 1。
- 四个多学科泛化任务:总榜 rank 1。
重要补充‼️:同时,由笔者本人以及相关课题的朋友进行了人工检查,发现主观效果也是该skills召回的文献效果最好
“ 这说明该 skill 的优势并不是某一次任务偶然命中,而是来自稳定的流程设计。它最擅长的不是简单召回,而是复杂约束下的候选过滤、验证、解释和最终阅读清单结构控制。 ”
Skill 与 Agent 的关系
这个案例能说明 skill 和 agent 的一个重要区别。
Agent 更像运行时的执行主体,负责调用工具、搜索、读文件、写报告、进行多步推理。Skill 则更像一段可加载的行为规范,它不替代 agent,而是改变 agent 在某类任务中的默认策略。对于文献检索这种任务,agent 本身通常已经会搜索、总结和列引用;skill 的价值在于让 agent 以更稳定的方式做这些事。
iterative-research-lit 改造后表现更好,是因为它把 PaSaMaster 的系统级思想压缩成了 agent 可执行的局部规则:
- 先做 IntentSpec,而不是直接搜。
- 先做 checklist,而不是凭感觉判断相关。
- 先验证 canonical paper record,再进入 ranking。
- 通过 hard fail 保护关键约束。
- 通过 evidence-triggered reflection 控制是否继续迭代。
- 输出时解释每篇论文为什么入选。
换句话说,PaSaMaster 是一个完整系统;iterative-research-lit 是把这个系统里最有迁移价值的控制逻辑,变成一个可复用的 agent skill。
适用任务与边界
这个 skill 最适合以下任务:
- 用户给出多个硬约束,例如主题、方法、时间、期刊、文章类型、应用场景。
- 用户明确排除某类方法或文献,例如不要 semantic-only,不要综述,不要治疗论文。
- 用户要求解释为什么每篇论文入选。
- 用户需要一组可用于真实调研、开题、related work 或实验设计的阅读清单。
- 用户任务跨多个概念,需要平衡不同维度,例如智能零售 + 谷子消费认同。
它不适合以下任务:
- 只找某篇已知论文。
- 只要 3-5 篇最新论文,且不需要解释。
- 总结单篇 PDF。
- 下载 arXiv 或导出 BibTeX 这种源特定任务。
- 需要穷尽式系统综述、PRISMA 流程、meta-analysis 的正式文献综述。
它的主要风险也很清楚:
- checklist 设计质量决定上限。
- Web 检索场景无法真正保证 PaSaMaster 式零幻觉,只能做存在性验证和不确定性标注。
- 当前评估是 controlled benchmark,不是完整线上黑盒系统对测。
- 当前 skill 仍保留 phenotype 领域 addon,虽然主干已经泛化,但还不是完全无领域残留的纯核心版。
小结
PaSaMaster 的价值在于提出了一个更接近真实科研检索需求的方向:复杂意图不是关键词,文献推荐不能靠生成,检索应该能从证据中修正自己。但这篇论文也有明显问题,包括对内部语料和系统工程的依赖、benchmark 对自身范式的偏好、真实 Web 搜索适配不足,以及开源完整性不足。
iterative-research-lit 的工作不算复刻 PaSaMaster,而是把它可迁移的思想改造成一个轻量、可维护、可评估的 skill。这个 skill 按照 skill 守则把主流程留在 SKILL.md,把条件知识放入 references/,把确定性评分放入 scripts/,并通过多轮受控 benchmark 检查是否真的改善了复杂文献检索任务。
从当前结果看,它最稳定的优势是复杂约束保真和集合级排序。主要定位是:面向复杂研究意图的、验证优先、checklist 驱动、结果集结构优先的文献检索 skill。
参考资料
原始论文
- Yuwen Du, Tian Jin, Jing Kang, Xianghe Pang, Jingyi Chai, Tingjia Miao, Fenyi Liu, WenHao Wang, Sikai Yao, Yuzhi Zhang, Siheng Chen.
Towards Self-Evolving Agentic Literature Retrieval. arXiv:2605.14306, submitted 2026-05-14. https://arxiv.org/abs/2605.14306 - PaSaMaster GitHub repository:
sjtu-sai-agents/PaSaMaster. https://github.com/sjtu-sai-agents/PaSaMaster
Skill 相关
-
Skills说明编写参考标准:. https://research.perplexity.ai/articles/designing-refining-and-maintaining-agent-skills-at-perplexity
-
ARIS / Auto-Research-In-Sleep:
wanshuiyin/Auto-claude-code-research-in-sleep. https://github.com/wanshuiyin/Auto-claude-code-research-in-sleep -
Aperivue MedSci Skills:
Aperivue/medsci-skills. https://github.com/Aperivue/medsci-skills -
K-Dense Scientific Agent Skills:
K-Dense-AI/scientific-agent-skills. https://github.com/K-Dense-AI/scientific-agent-skills -
Davila7 Claude Code Templates:
davila7/claude-code-templates. https://github.com/davila7/claude-code-templates