Transformer|反向传播(Backpropagation)(2):两个特殊模块——Softmax 与 RMSNorm
阅读提醒:上一篇我们推导了线性层的两个核心公式。但 Transformer 里不全是线性层——还有 Softmax 和 RMSNorm 这两个“非线性”模块。作为数据归一化的“主力”它们的共同特点是:几乎没有可学习参数(在经典Transformer中RMSNorm 有一个 γ,但主体运算没有权重矩阵),但是这两个模块都涉及到了对误差计算的耦合,学习了这一块对耦合的处理之后,再进入对Attention模块的耦合处理就会显得比较亲切了,祝食用愉快~😌
图 1 一张有趣的Softmax poster
导言:logits 到底在哪里?
“ 很多人会混淆 logits 和 Softmax 的位置关系。让我们把整个流程画清楚: ”
Transformer Block 的输出 h
  │
  ▼
线性投影层:logits = h · W_lm          ← logits 在这里产生
  │
  │    logits = [2.5, 0.8, -0.3]       ← 原始的、未经归一化的打分
  │                                       可以是任意实数,正负都有
  ▼
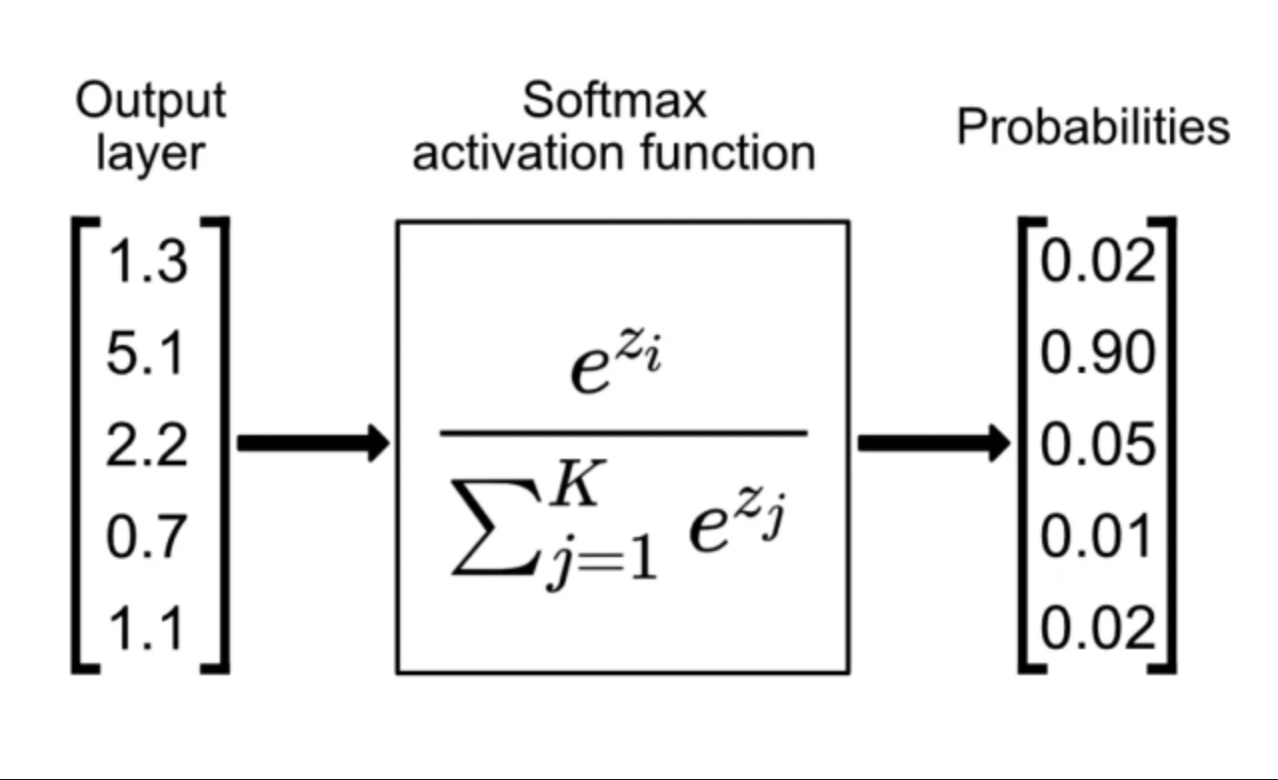
Softmax:y_pred = Softmax(logits)       ← Softmax 把 logits 变成概率
  │
  │    y_pred = [0.70, 0.20, 0.10]     ← 归一化后的概率,加起来 = 1
  │
  ▼
交叉熵损失:L = -Σ y_gt · log(y_pred)  ← 用概率和正确答案算损失
所以顺序是:
logits(原始打分)→ Softmax(变成概率)→ 交叉熵(算损失)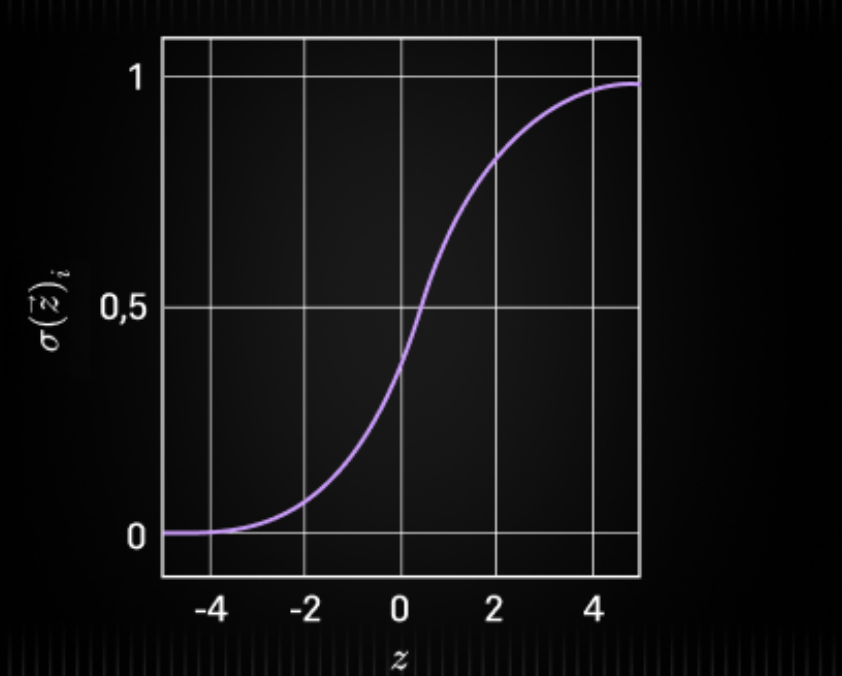
Softmax函数 logits 是 Softmax 的输入,不是输出。
那 是什么?
上一篇我们直接写了 。
这个结果,其实是 Softmax + 交叉熵联合求导 之后的结果。也就是说,我们一步跳过了 Softmax 和交叉熵这两层,直接算出了损失 对 logits 的导数。
为什么可以跳过?因为这两层联合求导的结果恰好极其简洁。但如果你想理解 Softmax 单独的反向传播(比如在 Attention 的注意力分数那里,Softmax 是单独出现的,后面没有交叉熵),就需要单独推导。
让我们把这两种情况都说清楚。
情况一:Softmax + 交叉熵
这是输出层的情况。Softmax 和交叉熵总是成对出现。
前向传播
logits = [z₁, z₂, z₃]                    ← 比如 [2.5, 0.8, -0.3]

y_pred = Softmax(logits)                  ← [0.70, 0.20, 0.10]

         其中 y_pred_j = e^zⱼ / Σᵢ e^zᵢ

L = -Σⱼ y_gt_j · log(y_pred_j)           ← 交叉熵损失
为什么联合求导结果这么简洁?
“ 如果你分开算,Softmax 的导数和交叉熵的导数都很复杂。但它们组合在一起时,大量的项互相抵消。 ”
最终结果:
这就是我们上一篇用于推导的起点。
“ 你只需要记住:在输出层,Softmax + 交叉熵是一对好搭档,它们联合产生的误差信号就是“预测 - 真实” ”
情况二:Softmax 单独出现
图 2 Softmax处理本质:归一化
“ 在 Self-Attention 中,Softmax 单独出现,后面不是交叉熵,而是矩阵乘法 : ”
S_scaled = Q·K^T / √d_k     ← Softmax 的输入

P = Softmax(S_scaled)         ← Softmax 的输出(注意力权重)

output = P · V                ← Softmax 的输出参与后续计算
这里我们已经从 的反向传播拿到了 (P 的误差),现在要算 (传给 Softmax 输入的误差)。
这时候 Softmax 的梯度就不能“联合简化”了,必须单独算。
看看 Softmax 在做什么
假设只有 3 个 token,看 的第 行(即位置 对所有位置的注意力分布):
输入:z = [z₁, z₂, z₃]         ← S_scaled 的第 s 行

输出:p = [p₁, p₂, p₃]         ← P 的第 s 行

      p₁ = e^z₁ / (e^z₁ + e^z₂ + e^z₃)
      p₂ = e^z₂ / (e^z₁ + e^z₂ + e^z₃)
      p₃ = e^z₃ / (e^z₁ + e^z₂ + e^z₃)

约束:p₁ + p₂ + p₃ = 1         ← 这是耦合的根源
此时从上面传来误差 。
为什么 Softmax 的梯度比较复杂?
因为改变 不只影响 ,还影响 和 。
z₁ 增大一点点:
  → e^z₁ 变大
  → 分子变大,p₁ 变大           ← 直接影响
  → 分母也变大,p₂ 和 p₃ 变小   ← 间接影响(此消彼长)
所以 的梯度,不能只看 ,还要考虑它对 和 的影响。
逐步推导
对 的导数(自己对自己):
“ 推导过程:,用商的求导法则,分子贡献 ,分母贡献 ,合起来是 。 ”
对 的导数(自己对别人):
“ 推导过程:, 只通过分母 影响 ,,所以 。 ”
同理:
用链式法则把三条路加起来:
提取公因子 :
其中 就是 和 的点积,是一个标量,记作 。
整理成向量公式
对于 Softmax 的每一行:
- :Softmax 的输出(前向传播时存档的)
- :从上面传来的误差
- :一个标量,是 和 的点积
- :逐元素乘法
理解:
- 这一步:从每个位置的误差里减去“加权平均误差” 。因为 Softmax 的输出加起来必须是1,不可能所有分数同时增大,所以每个位置的梯度都要相对于平均水平来衡量。
- 这一步:乘以 是因为 Softmax 本身的导数里自带这个系数。 越大的位置(越被关注的 token),它的梯度也越大。
和输出层的联合公式对比
输出层(Softmax + 交叉熵联合):
  Δ_logits = y_pred - y_gt
  → 直接得到结果,不需要单独算 Softmax 梯度

Attention 里(Softmax 单独出现):
  Δ_z = p ⊙ (δ_p - Σⱼ δ_j·pⱼ)
  → 需要用这个完整的公式
RMSNorm 的反向传播
RMSNorm 出现在哪里?
在现代的Pre-Norm Transformer框架里,RMSNorm 出现在每个子模块之前:
x_in
  │
  ▼
RMSNorm(x_in)  → x_norm     ← 第一个 RMSNorm,在 Attention 之前
  │
  ▼
Attention(x_norm)
  │
  ▼
x_mid = x_in + x_attn        ← 残差相加
  │
  ▼
RMSNorm(x_mid) → x_norm2    ← 第二个 RMSNorm,在 FFN 之前
  │
  ▼
FFN(x_norm2)
  │
  ▼
x_out = x_mid + x_ffn        ← 残差相加
RMSNorm 在做什么?
图 3 RMSNorm的形状
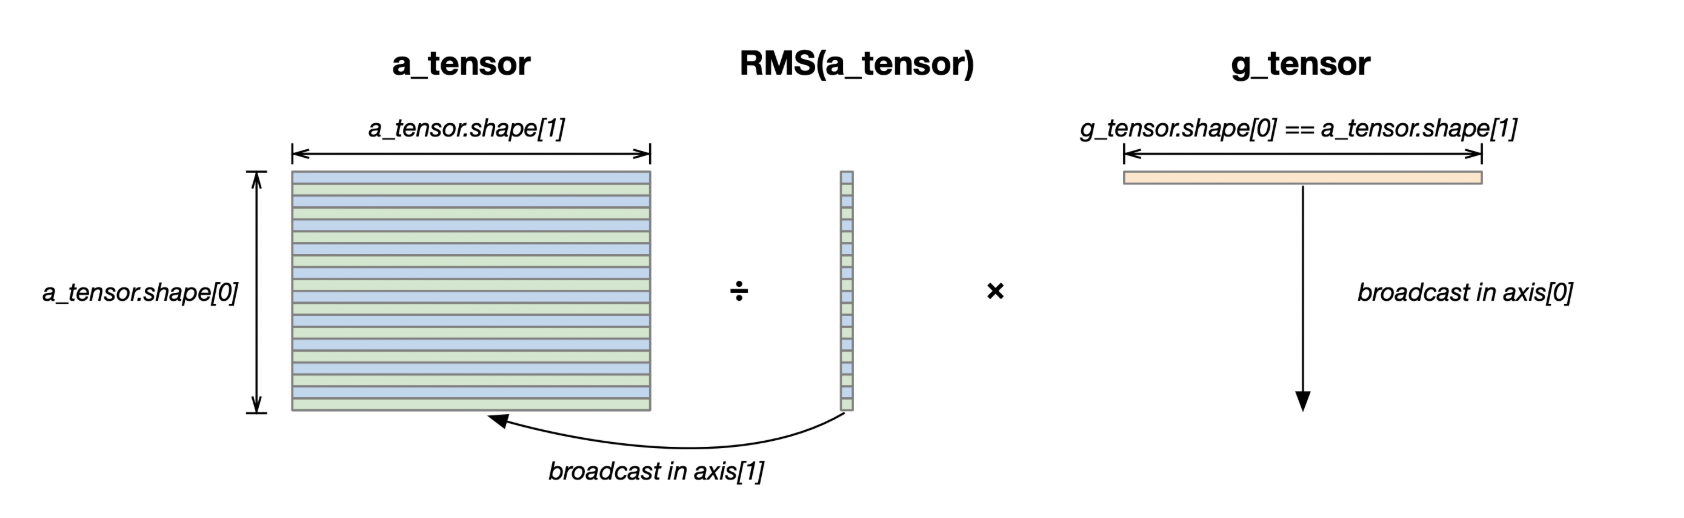
对每个 token 的向量 (长度为 ),独立做以下操作:
- 第一步:算这个向量的“均方根”长度
- 第二步:把每个元素除以这个长度(归一化)
- 第三步:乘以可学习参数 (逐元素缩放)
用例子来看看耦合问题
假设 ,一个 token 的向量 :
rms = sqrt( (x₁² + x₂² + x₃²) / 3 )

x̂₁ = x₁ / rms
x̂₂ = x₂ / rms
x̂₃ = x₃ / rms问题: 的梯度怎么算?
影响了输出的两条路:
路线1(直接):x₁ 出现在 x̂₁ = x₁/rms 的分子里
                → x₁ 变大,x̂₁ 直接变大

路线2(间接):x₁ 通过 x₁² 参与了 rms 的计算
                → x₁ 变大,rms 变大,分母变大
                → x̂₁, x̂₂, x̂₃ 全都变小
x₁ ──→ x̂₁ = x₁/rms ──→ output₁ ← 直接影响(分子)
│
└──→ rms ──→ x̂₁ = x₁/rms ──→ output₁ ← 间接影响(分母)
└──→ x̂₂ = x₂/rms ──→ output₂ ← 间接影响
└──→ x̂₃ = x₃/rms ──→ output₃ ← 间接影响这就是耦合:改变 ,所有 都会跟着变。
逐步推导
从上面传来误差 。
第一步:去掉 的影响
,所以:
( 在前向时乘上去的,反向时乘回来就行)
同时, 的梯度也顺手算了:
“ 和线性层的梯度公式一个思路: 的梯度 = 上游误差 × 前向时的输入。 ”
第二步:算 对 的导数
分两种情况。
当 (自己对自己):
“ 第一项来自分子的 ,第二项来自 通过分母 rms 的间接影响。 ”
当 (自己对别人):
“ 只有间接影响(通过分母 rms)。 ”
第三步:用链式法则,把所有路径加起来
的总梯度:
注意到 ,所以 ,代入后整理:
整理成向量公式
记 (一个标量):
直觉理解
Δ_x̂          ← 直接传回来的误差
- x̂ · c      ← 修正项:去掉因为归一化约束带来的耦合
÷ rms         ← 缩放回原始尺度
“ 和 Softmax 的梯度对比: 两者结构惊人地相似——都是“直接误差 - 某种加权平均的修正项”。 它们都施加了某种“归一化约束”(Softmax 要求输出和为1,RMSNorm 要求输出的均方根为1),反向传播时都需要修正这个约束带来的耦合效应。 ”
小结
                    Softmax                      RMSNorm
────────────────────────────────────────────────────────────
出现位置          Attention 里(Q·K^T 之后)     每个子模块之前

前向约束          输出加起来 = 1                 输出的均方根 ≈ 1

可学习参数        无                             γ(逐元素缩放)

反向传播公式      Δ_z = p ⊙ (δ - Σⱼ δⱼpⱼ)     Δ_x = (1/rms)(Δ_x̂ - x̂·c)

修正项含义        减去"加权平均误差"             减去"归一化耦合"

核心思路          直接误差 - 耦合修正             直接误差 - 耦合修正

Token 之间        同一行内不同位置耦合            同一 token 内不同维度耦合
                  不同行(不同 token)独立         不同 token 独立
整个输出层的完整反向传播路径
现在把所有东西串起来,看看从损失 到 Transformer Block 输出 之间,完整的反向传播顺序:
L(损失)
│
▼  Softmax + 交叉熵联合求导(情况一,直接用简化公式)
│
Δ_logits = y_pred - y_gt = [+0.70, -0.80, +0.10]
│
▼  线性层 logits = h · W_lm(上一篇推导的两个公式)
│
├── ∂L/∂W_lm = h^T · Δ_logits    → 交给优化器
│
Δ_h = Δ_logits · W_lm^T
│
▼  继续往前传,进入 Transformer Block 内部
│
│  (在 Block 内部,会依次碰到)
│  (残差相加 → FFN反向 → RMSNorm反向 → 残差相加 → Attention反向 → RMSNorm反向)
│  (其中 Attention 内部的 Softmax 用情况二的完整公式)
│
▼
Δ_x_in  → 传给上一个 Block
笔者的话
你会发现我们将要进入Block里面最重要的两个模块:FFN以及Attention,笔者接下来会以SwiGLU为代表的前馈网络以及Self-Attention作为推导背景来展开推导
参考资料
- Laurent Bou´,Deep learning for pedestrians: backpropagation in Transformers
- Stanford lecture,cs336(2025-2026)