Transformer|反向传播(Backpropagation)(1):误差和梯度在 Linear 层的基础推导
阅读前提:本文假设你对 Transformer 的基本架构有一定了解,虽然是基础内容,但最好具有一点点线性代数、微积分基础理解起来会比较容易。如果你还不熟悉,笔者建议先了解一下Transformer 的前向传播流程再回来。本篇文章会非常详细地拆解反向传播的流程(主要基于个人的理解来表述),祝食用愉快~😊
导言
“ 在讲 Transformer 之前,我们先退回到一个简单的场景。一个最朴素的神经网络,做的事情就是: ”
图 1 神经网络
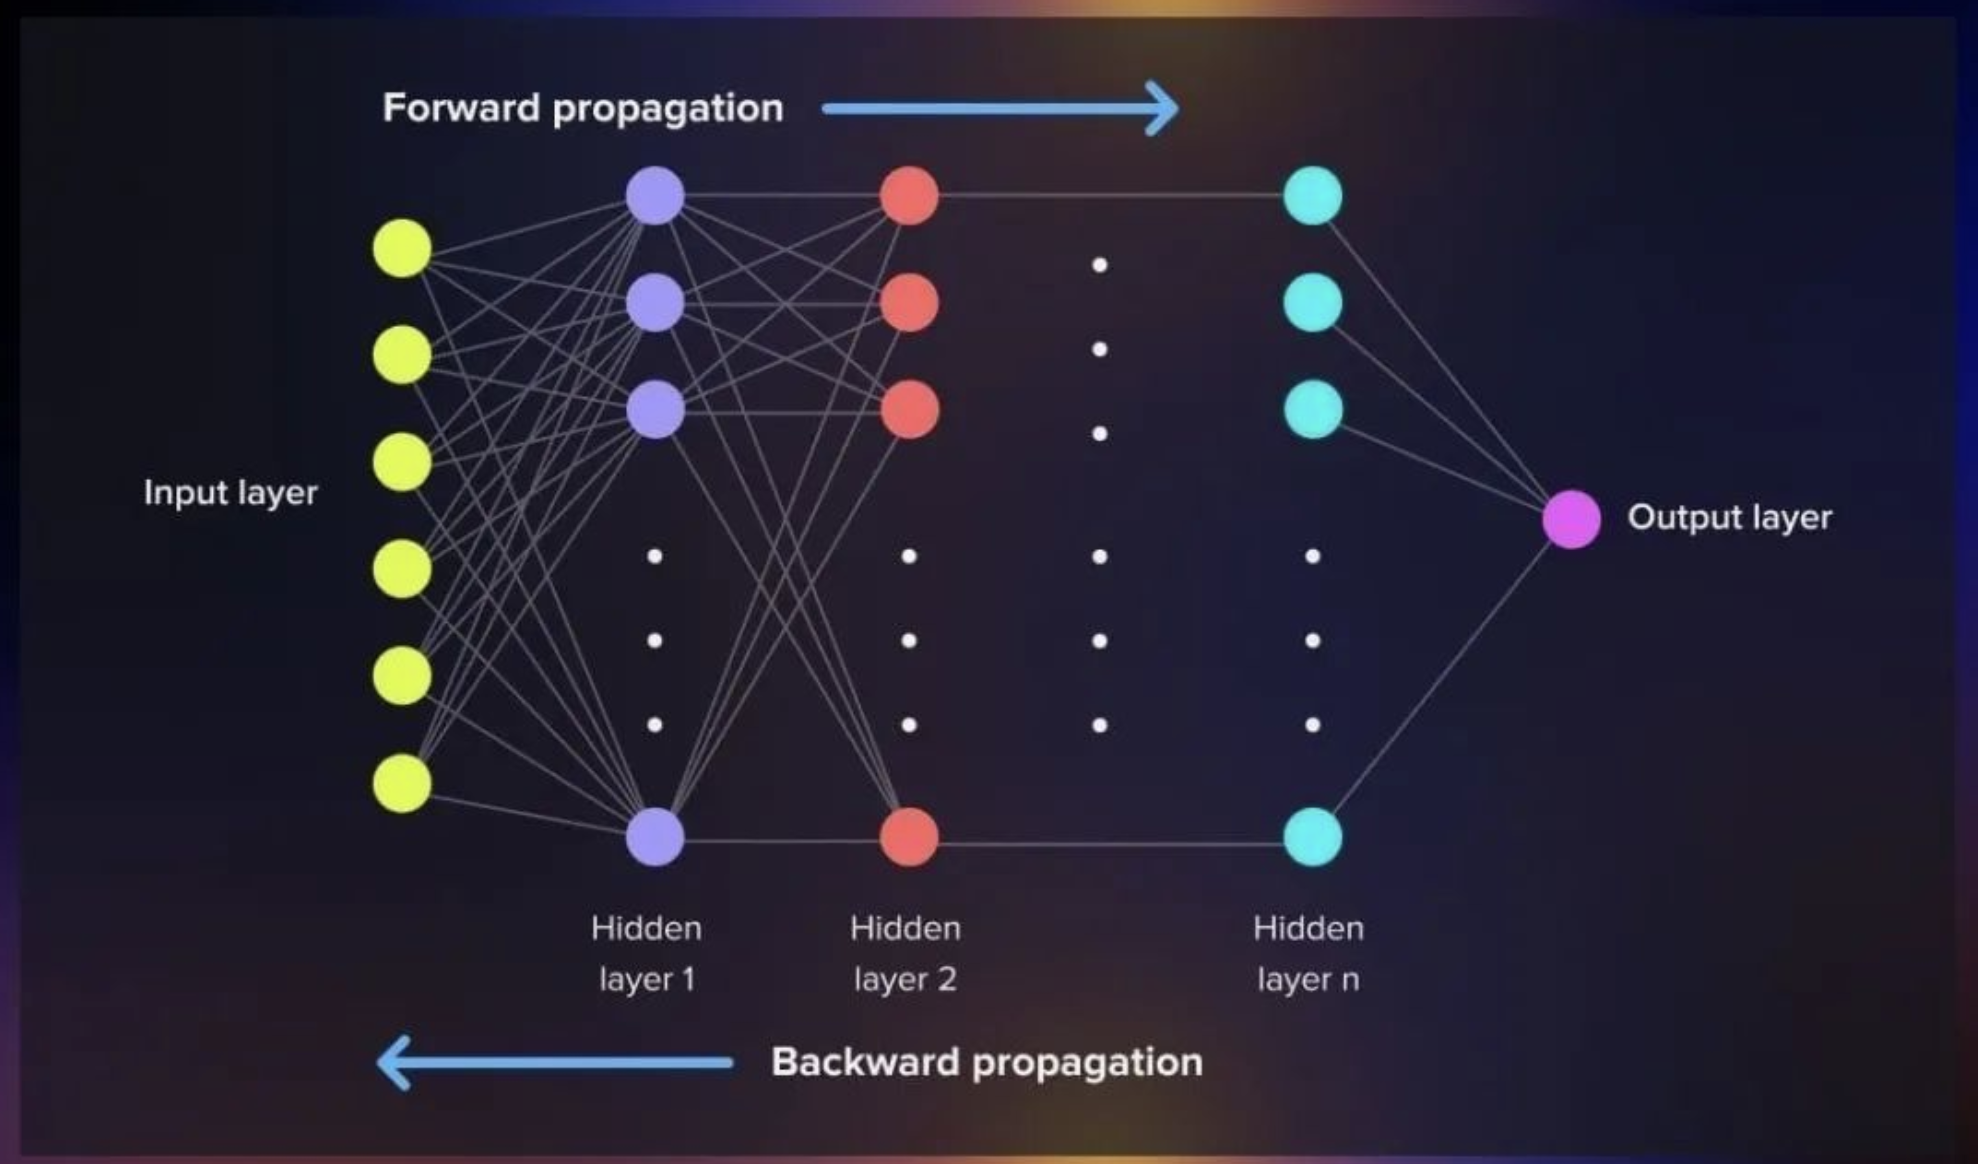
输入 → 一堆数学运算 → 输出 → 和正确答案比较 → 得到误差
这个“从输入到输出”的过程,叫做前向传播(Forward Pass)。
但光知道“错了”没有用。我们需要知道:网络里的哪些参数该对这个错误负责,负多少责?(就像犯了事之后要追责然后纠正错误一样)
这就引出了反向传播(Backward Pass):把误差从输出端,一层一层地往回传,沿途计算每一个参数应该承担的责任大小。
让我们用一个生活类比来说:
前向传播:一道菜从厨房端到了餐桌,客人说"这道菜不好吃"
反向传播:追查责任链——是服务员端错了?是厨师炒错了?
          还是采购员买的食材有问题?一路追到源头
在最早的神经网络里,这个“追查”过程是这样的:
输出层的误差
  → 往回传给倒数第二层
      → 再往回传给倒数第三层
          → 一直传到第一层
每一层的参数,都根据传到自己这里的误差,计算出自己的梯度,然后用梯度更新自己。
这个机制在简单的全连接网络里就已经存在。而Transformer 做的事情,本质上和这个没有区别——只是网络的结构更复杂,中间多了 Attention、RMSNorm、残差连接等模块,但每一层的反向传播,都遵循同样的链式法则。
所以这篇文章要分享的事情很简单:
“ 从 Transformer 最后一层的输出(logits)出发,推导出反向传播最核心的两个公式。这两个公式,会在 Transformer 的每一个线性层里反复使用。 ”
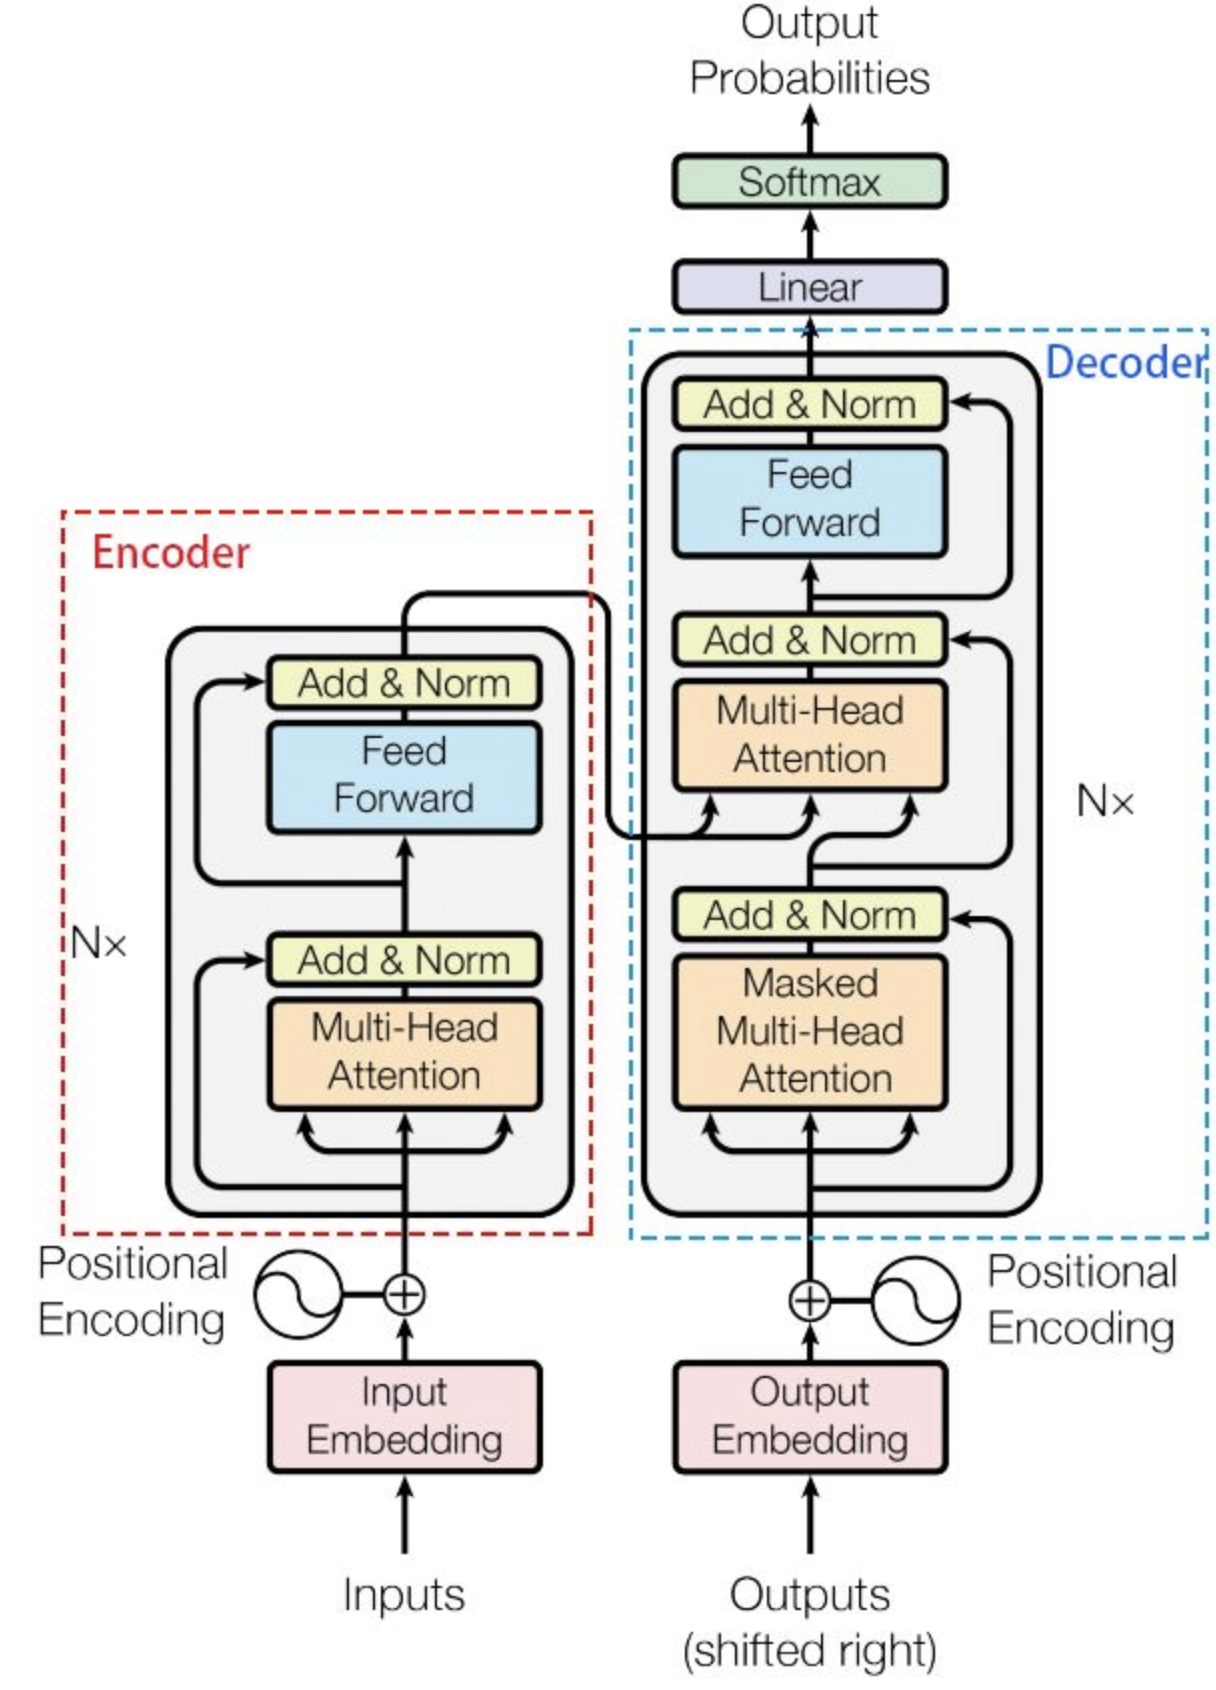
Transformer经典架构
误差和梯度
“ 在开始推导之前,先欢迎我们的两个主角登场👏 ”
误差
误差是一个在网络里从后往前流动的信号。
它的数学身份是:损失 对某个中间计算结果的导数。
它回答的问题是:“如果这个中间结果变化一点点,损失会怎么变?”
误差不是一个参数,它是一个临时的信号,每次训练完一个 batch 就消失了。它存在的唯一目的,是把“犯了多大的错”这件事,一层一层地传递到网络的每一个角落。
梯度
梯度是损失 对某个可学习参数 的导数。
它回答的问题是:“如果把这个参数调大一点点,损失会怎么变?”
梯度是我们真正想要的东西。有了所有参数的梯度,就可以告诉优化器(Optimizer,比如 Adam):
往梯度的反方向走一小步,损失就会减小,模型就会变得更聪明。
我们推导的全部目的,就是计算每一个参数层的梯度。误差的传播,是达到这个目的的手段。
从 Loss 出发
交叉熵
我们的模型预测了:
假设对应 。
而正确答案是 throne,用 one-hot 向量表示:
损失函数用交叉熵:
数字越大,说明模型错得越离谱。现在我们要从这个 出发,往回追责。
误差:Softmax + 交叉熵的联合梯度
Softmax 和交叉熵损失联合求导,有一个非常优雅的结果:
代入数字:
我们解读一下这三个数字:
+0.70(chair):  chair 的分数给高了,需要降低
-0.80(throne): throne 的分数给低了,需要提高
+0.10(floor):  floor 的分数也稍微高了一点,需要小幅降低
这就是反向传播的起点。
核心推导:线性层的连接
现在我们拿着 ,来到了它的上一层——输出投影层(Language Model Head)。
这一层做的事情是:
- :最后一个 Transformer Block 的输出,形状 ,比如 (为了方便展示)
- :输出投影矩阵,形状 , 是词表大小,比如
- :对每个词的原始打分,形状
用具体的形状写出来:
展开矩阵乘法,看清每一条线
把 展开,每个 logit 的计算是:
用图来看每一条连接:
              W的第1列     W的第2列     W的第3列
              (chair)      (throne)     (floor)

h₁ ────→   × W₁₁  ────→  × W₁₂  ────→  × W₁₃
h₂ ────→   × W₂₁  ────→  × W₂₂  ────→  × W₂₃
h₃ ────→   × W₃₁  ────→  × W₃₂  ────→  × W₃₃
h₄ ────→   × W₄₁  ────→  × W₄₂  ────→  × W₄₃
               ↓               ↓               ↓
          logit_chair    logit_throne    logit_floor
每个 是连接 和 之间的那个bridge。
现在我们已经知道了 。
那现在我们要问两个问题。
问题 A: 的梯度是多少?
以 (连接 和 的权重)为例。
第一步: 如何影响 ?
对 求偏导:
第二步: 如何影响损失 ?
这就是误差的定义:
第三步:链式法则,把两步连起来:
对所有的 和 做同样的操作:
把所有 个结果整理成矩阵:
写成矩阵公式:
语言理解:
W_{kj} 的梯度 = h_k × Δ_logits,j

h_k 越大:这个权重当时经手的输入信号越强,责任越大
Δ_j 越大: 这个权重连接的输出误差越大,责任越大
两者相乘,就是这个权重此刻的梯度
问题 B:把误差继续往前传
的梯度已经有了,交给优化器。
但反向传播还没结束—— 是从更前面的层算出来的,我们还要继续往前追责。(是的,坏人不止停留在表面😠)
为此,我们需要算出 ,即 的误差。
以 为例。
不像 那样只影响一个输出,它通过 的第一行,影响了所有三个 logit:
所以 的总误差,要把三条路上的贡献全部加起来:
用图来看这个“汇聚”的过程:
Δ_chair  (+0.70) ──× W₁₁──┐
                             ├──→ ∂L/∂h₁
Δ_throne (-0.80) ──× W₁₂──┤
                             │
Δ_floor  (+0.10) ──× W₁₃──┘
对所有 做同样的操作,整理成矩阵:
写成矩阵公式:
直觉总结:
前向传播:h 通过 W_lm 扩散成 logits
反向传播:logits 的误差通过 W_lm^T 收拢回 h

W^T 是 W 的"原路返回"版本
前向时 W 的第 k 行决定 h_k 如何影响所有输出
反向时 W^T 的第 k 行(即 W 的第 k 列)决定所有误差如何汇聚回 h_k
两个公式,一个对称结构
“ 让我们看看我们得到了什么战利品: ”
对称性:
计算 W 的梯度:把输入 h 转置,放在 Δ 的左边
计算 h 的误差:把参数 W 转置,放在 Δ 的右边
Δ 始终在中间,是两个公式共同的核心检查:
∂L/∂W 的形状 必须和 W 完全一致
Δ_h 的形状   必须和 h 完全一致
形状不对,一定哪里算错了
Transformer 反向传播的连接层
这不是只在输出层才用的特殊公式。Transformer 里几乎每一个有参数的地方,本质上都是一个线性层,都会用到这两个公式:
输出投影层 W_lm:
  ∂L/∂W_lm = h^T · Δ_logits
  Δ_h = Δ_logits · W_lm^T

Self-Attention 的 Q/K/V 投影:
  ∂L/∂W_Q = x^T · Δ_Q
  Δ_x = Δ_Q · W_Q^T

FFN 的每一层:
  ∂L/∂W_1 = x^T · Δ_z
  Δ_x = Δ_z · W_1^T
形式完全一样,只是每次 、、 换了具体的名字而已。
小结
- 2个传播公式的推导以及理解
“ 掌握了这两个公式,你就掌握了 Transformer 反向传播推导的大部分内容。剩下的是针对特殊的Softmax、RMSNorm、残差连接这些非线性部分,以及Attention多token交联的特殊推导,但它们的推导思路也完全一样:链式法则,一步一步往回追。这是大模型基于Transformer架构学习优化的根本方式。 ”
图 2 误差在Trasnformer可学习参数的表示
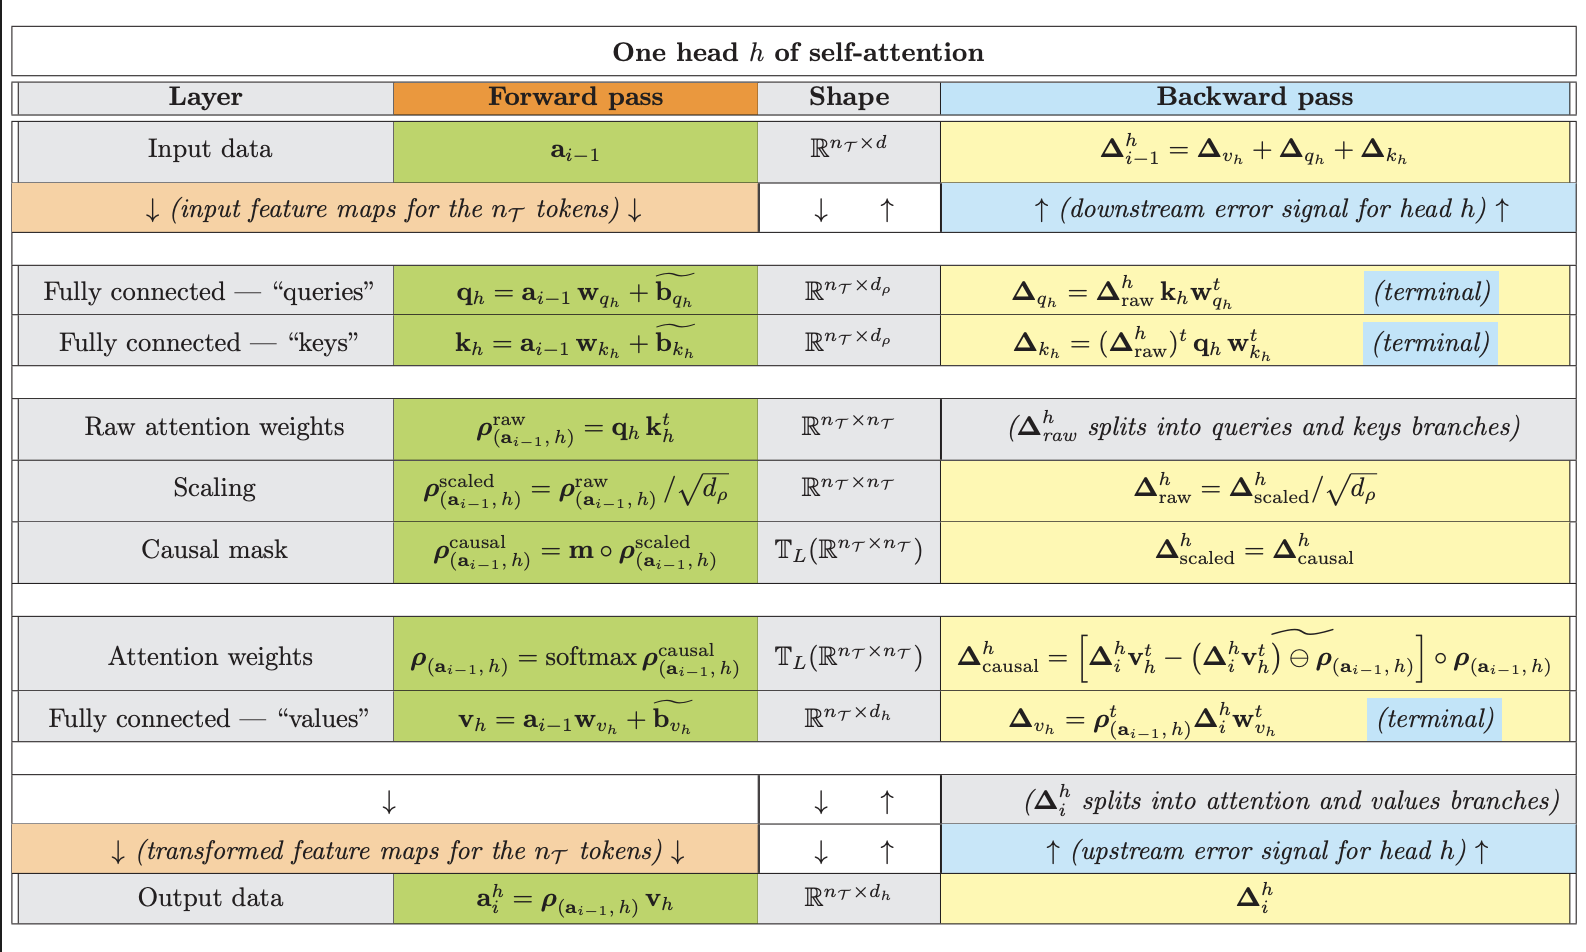
笔者的话
后续将分模块介绍FFN,Attenion,RMSNorm等Transformer经典架构的反向传播过程,以及将通过这里的探讨对Pre与Post-Norm的设计的选择等问题做一些探究~
参考资料
- Laurent Bou´,Deep learning for pedestrians: backpropagation in Transformers
- Stanford lecture,cs336(2025-2026)